Mises à jour par lots en policy gradient

Apprentissage par renforcement profond en Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Mises à jour du gradient pas à pas vs par lots
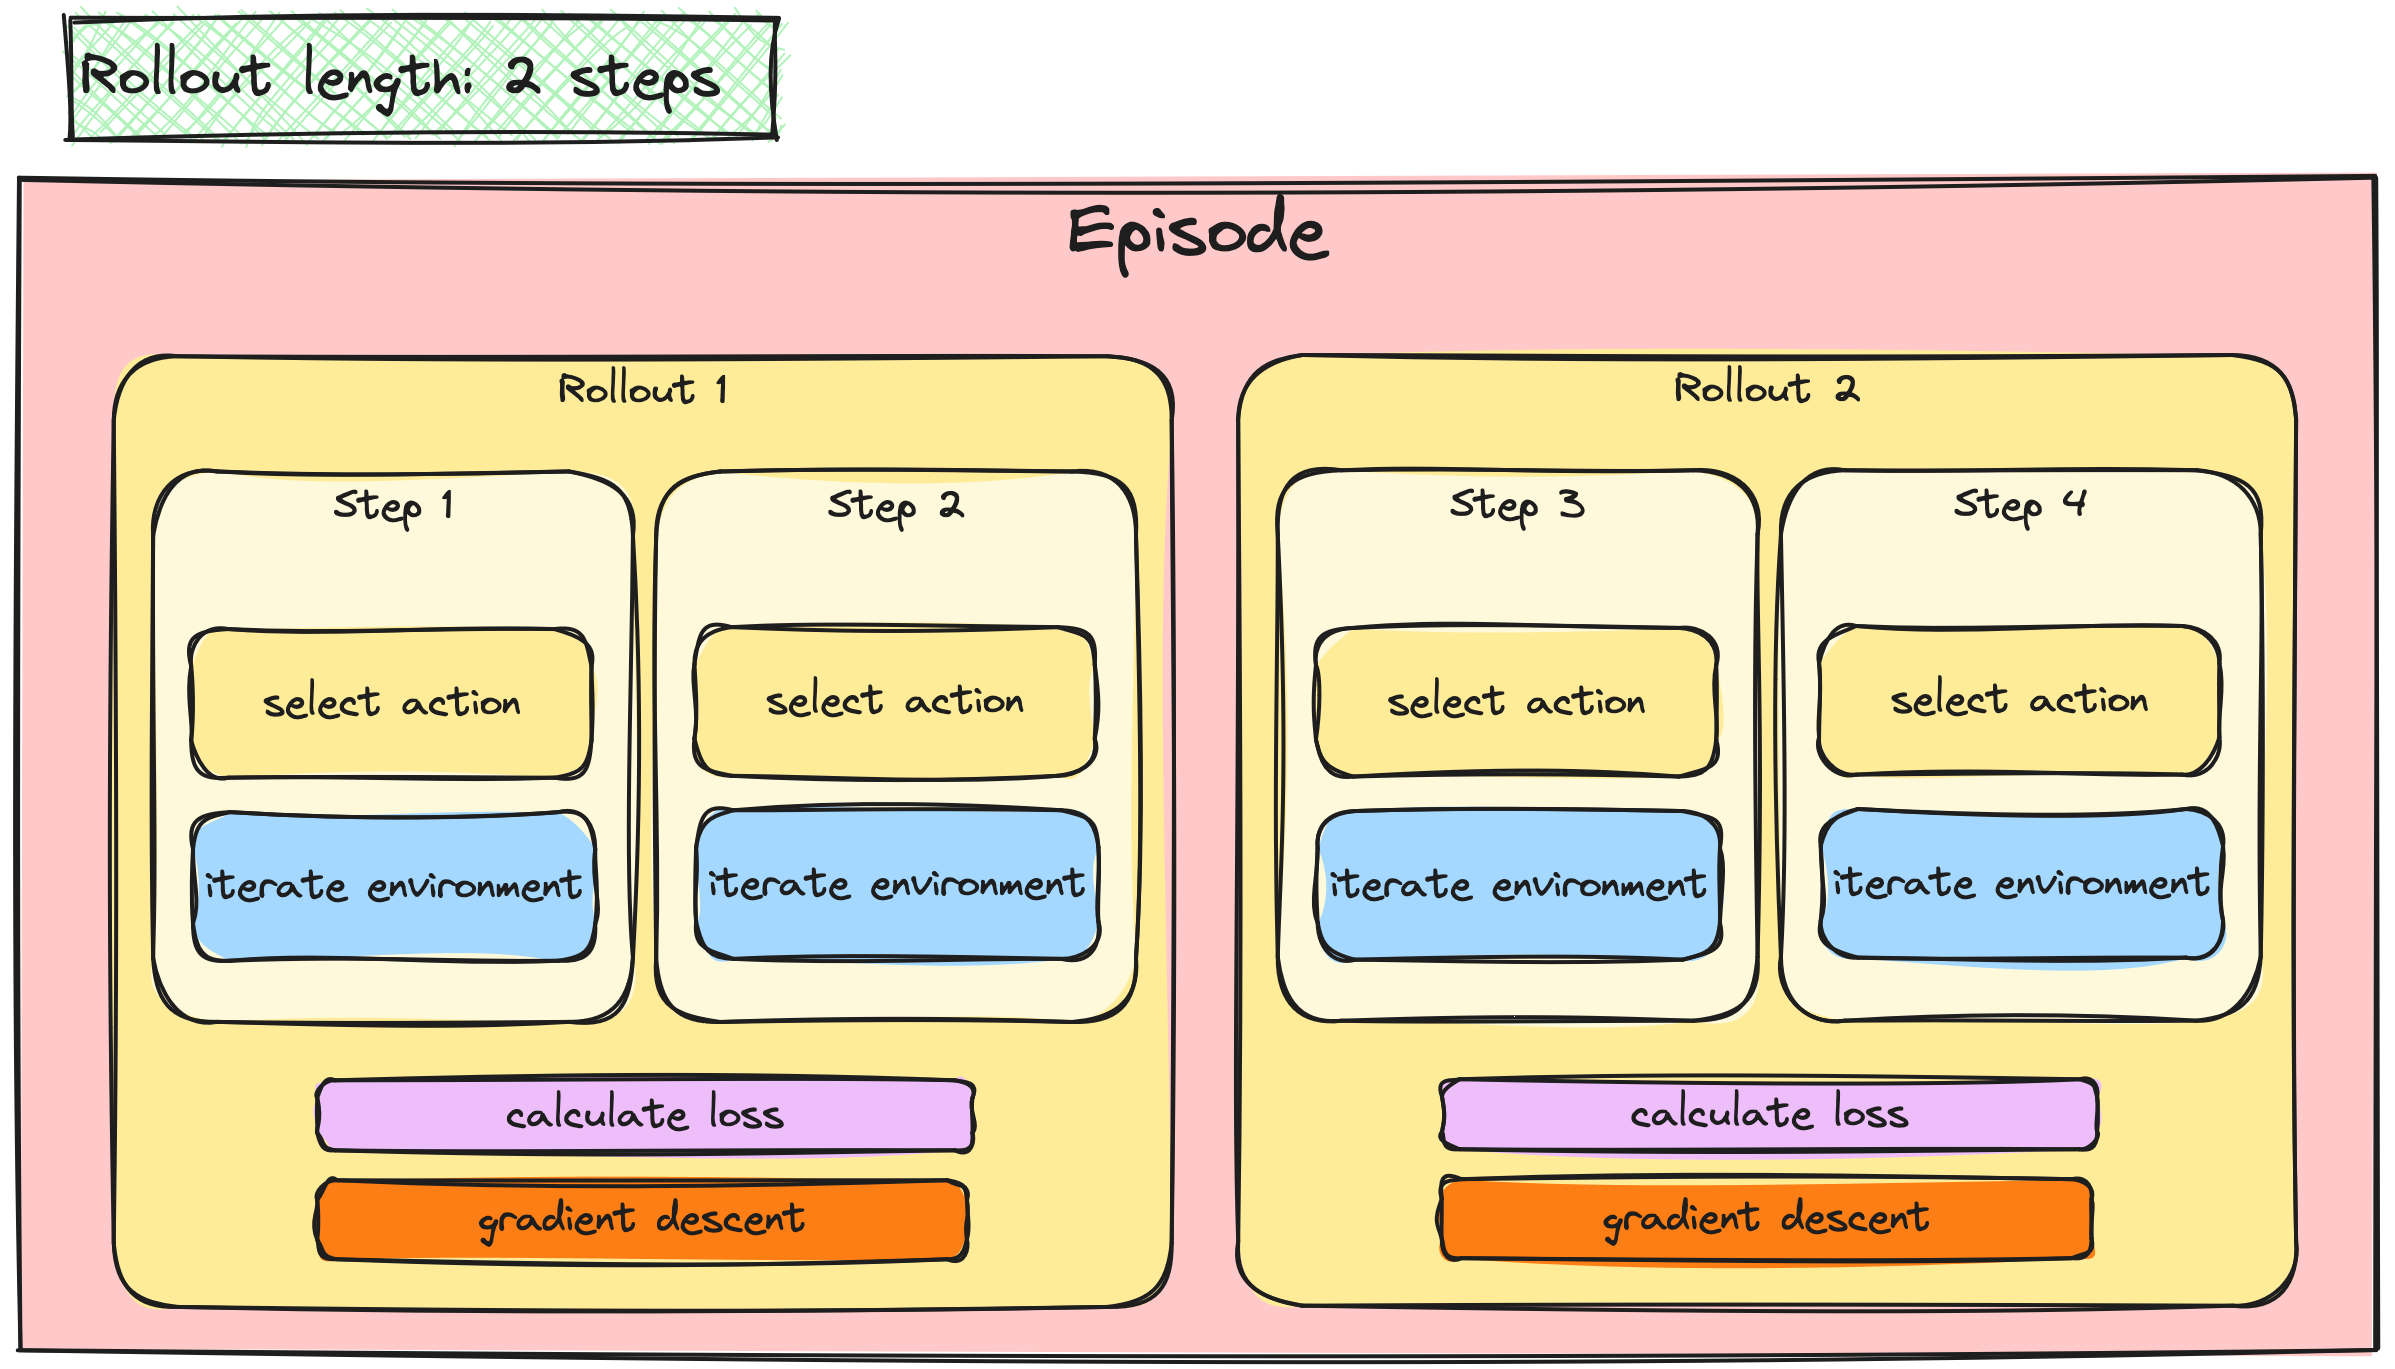
Une grande boîte représentant un épisode.

Apprentissage par renforcement profond en Python

Mises à jour du gradient pas à pas vs par lots
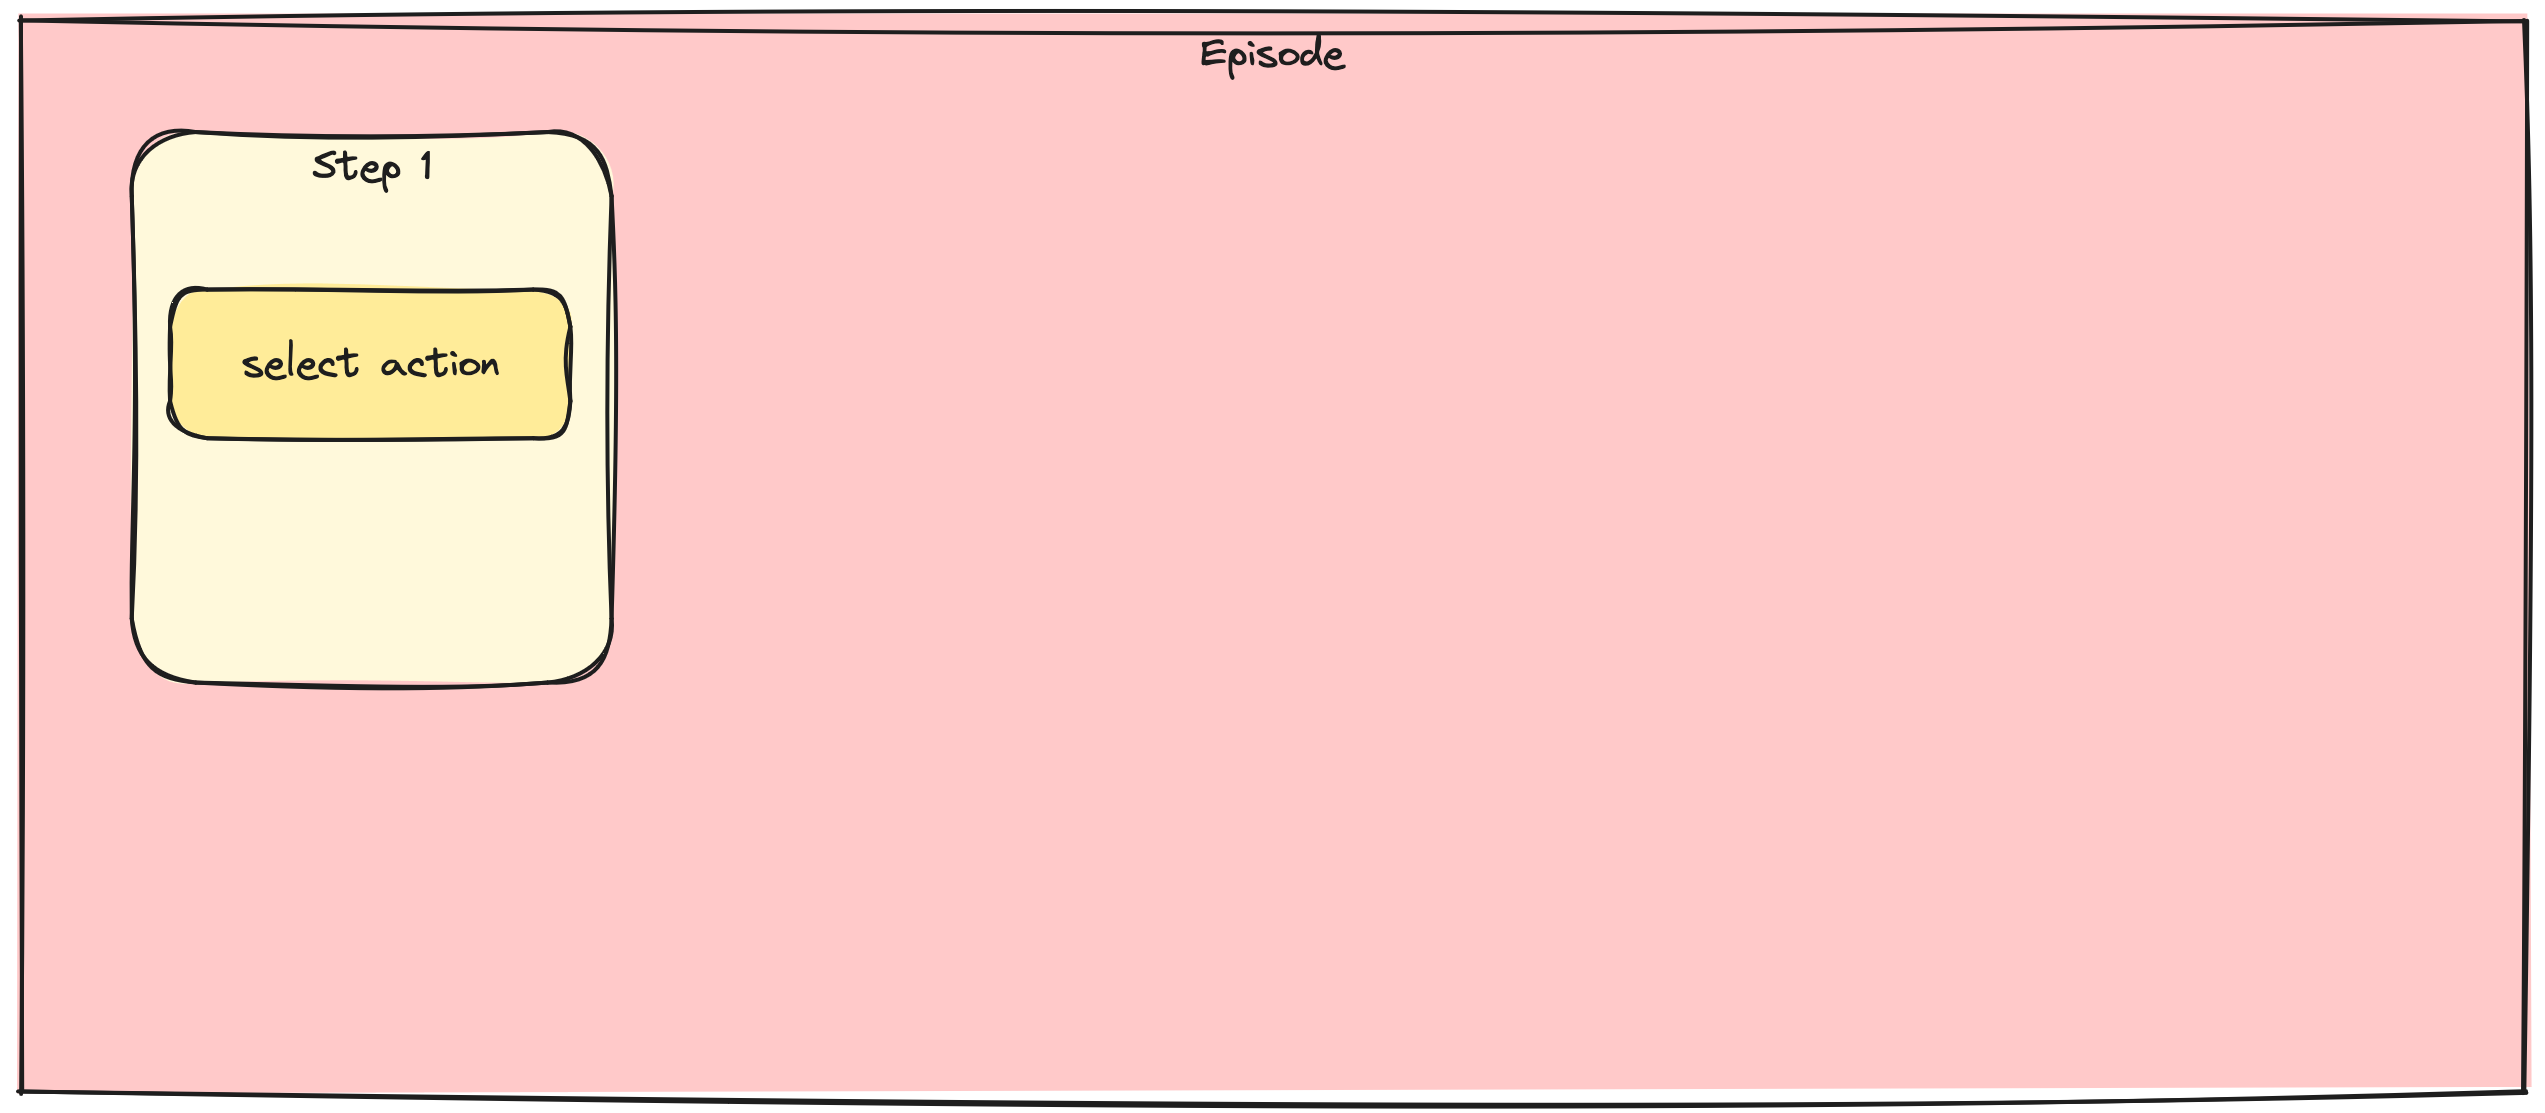
Dans la grande boîte, une plus petite apparaît, représentant l'étape 1. À l'intérieur, une autre boîte avec le texte « sélectionner une action ».

Apprentissage par renforcement profond en Python

Mises à jour du gradient pas à pas vs par lots
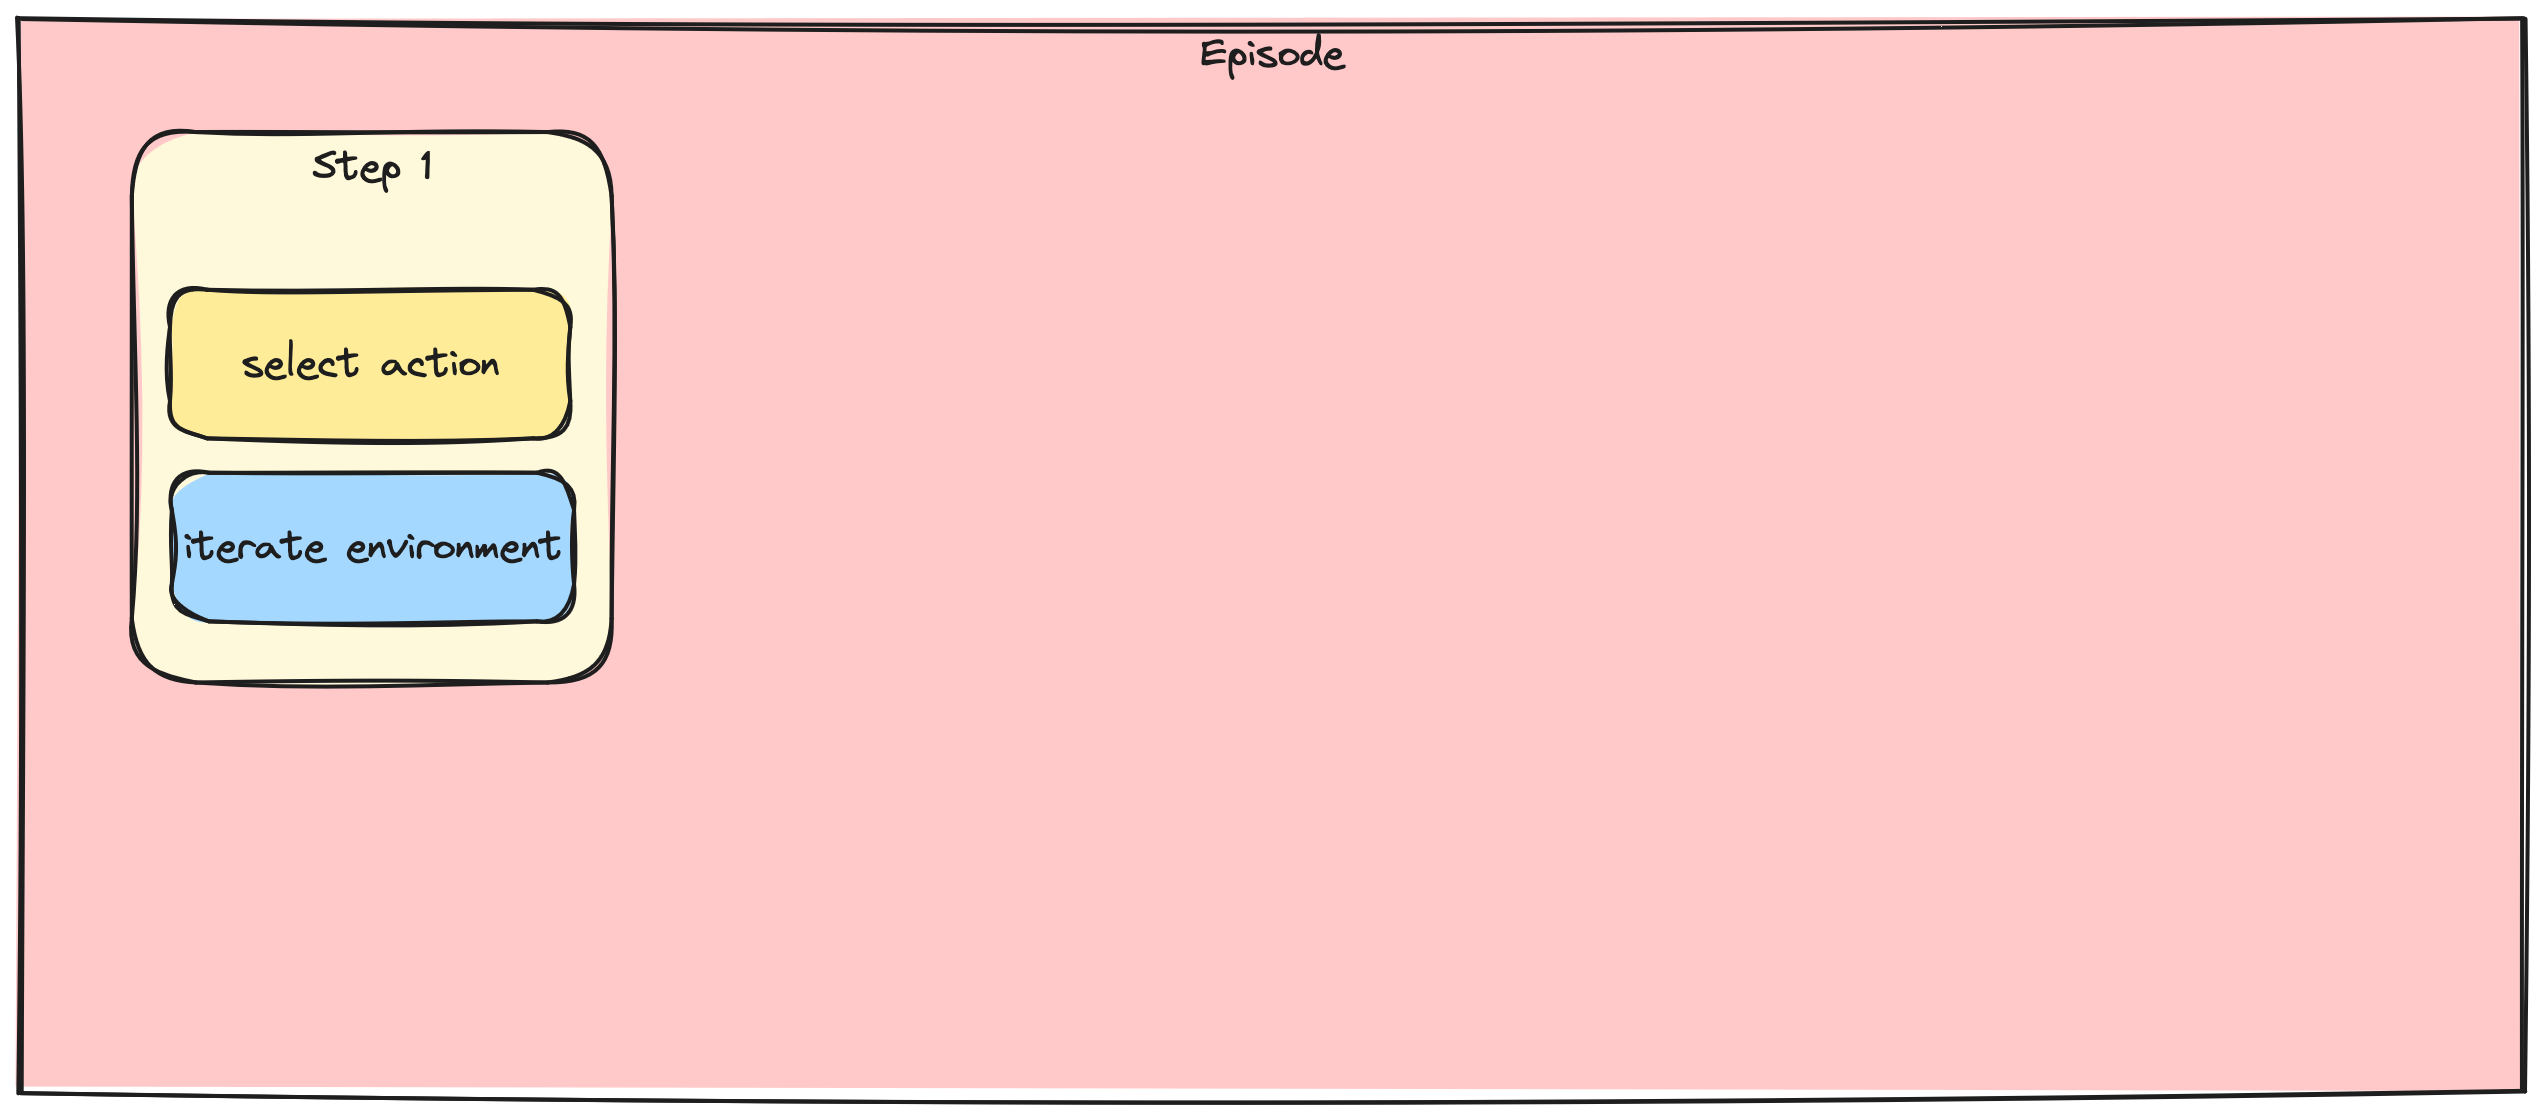
Dans la boîte de l'étape 1, une petite boîte avec le texte « itérer l'environnement ».

Apprentissage par renforcement profond en Python

Mises à jour du gradient pas à pas vs par lots
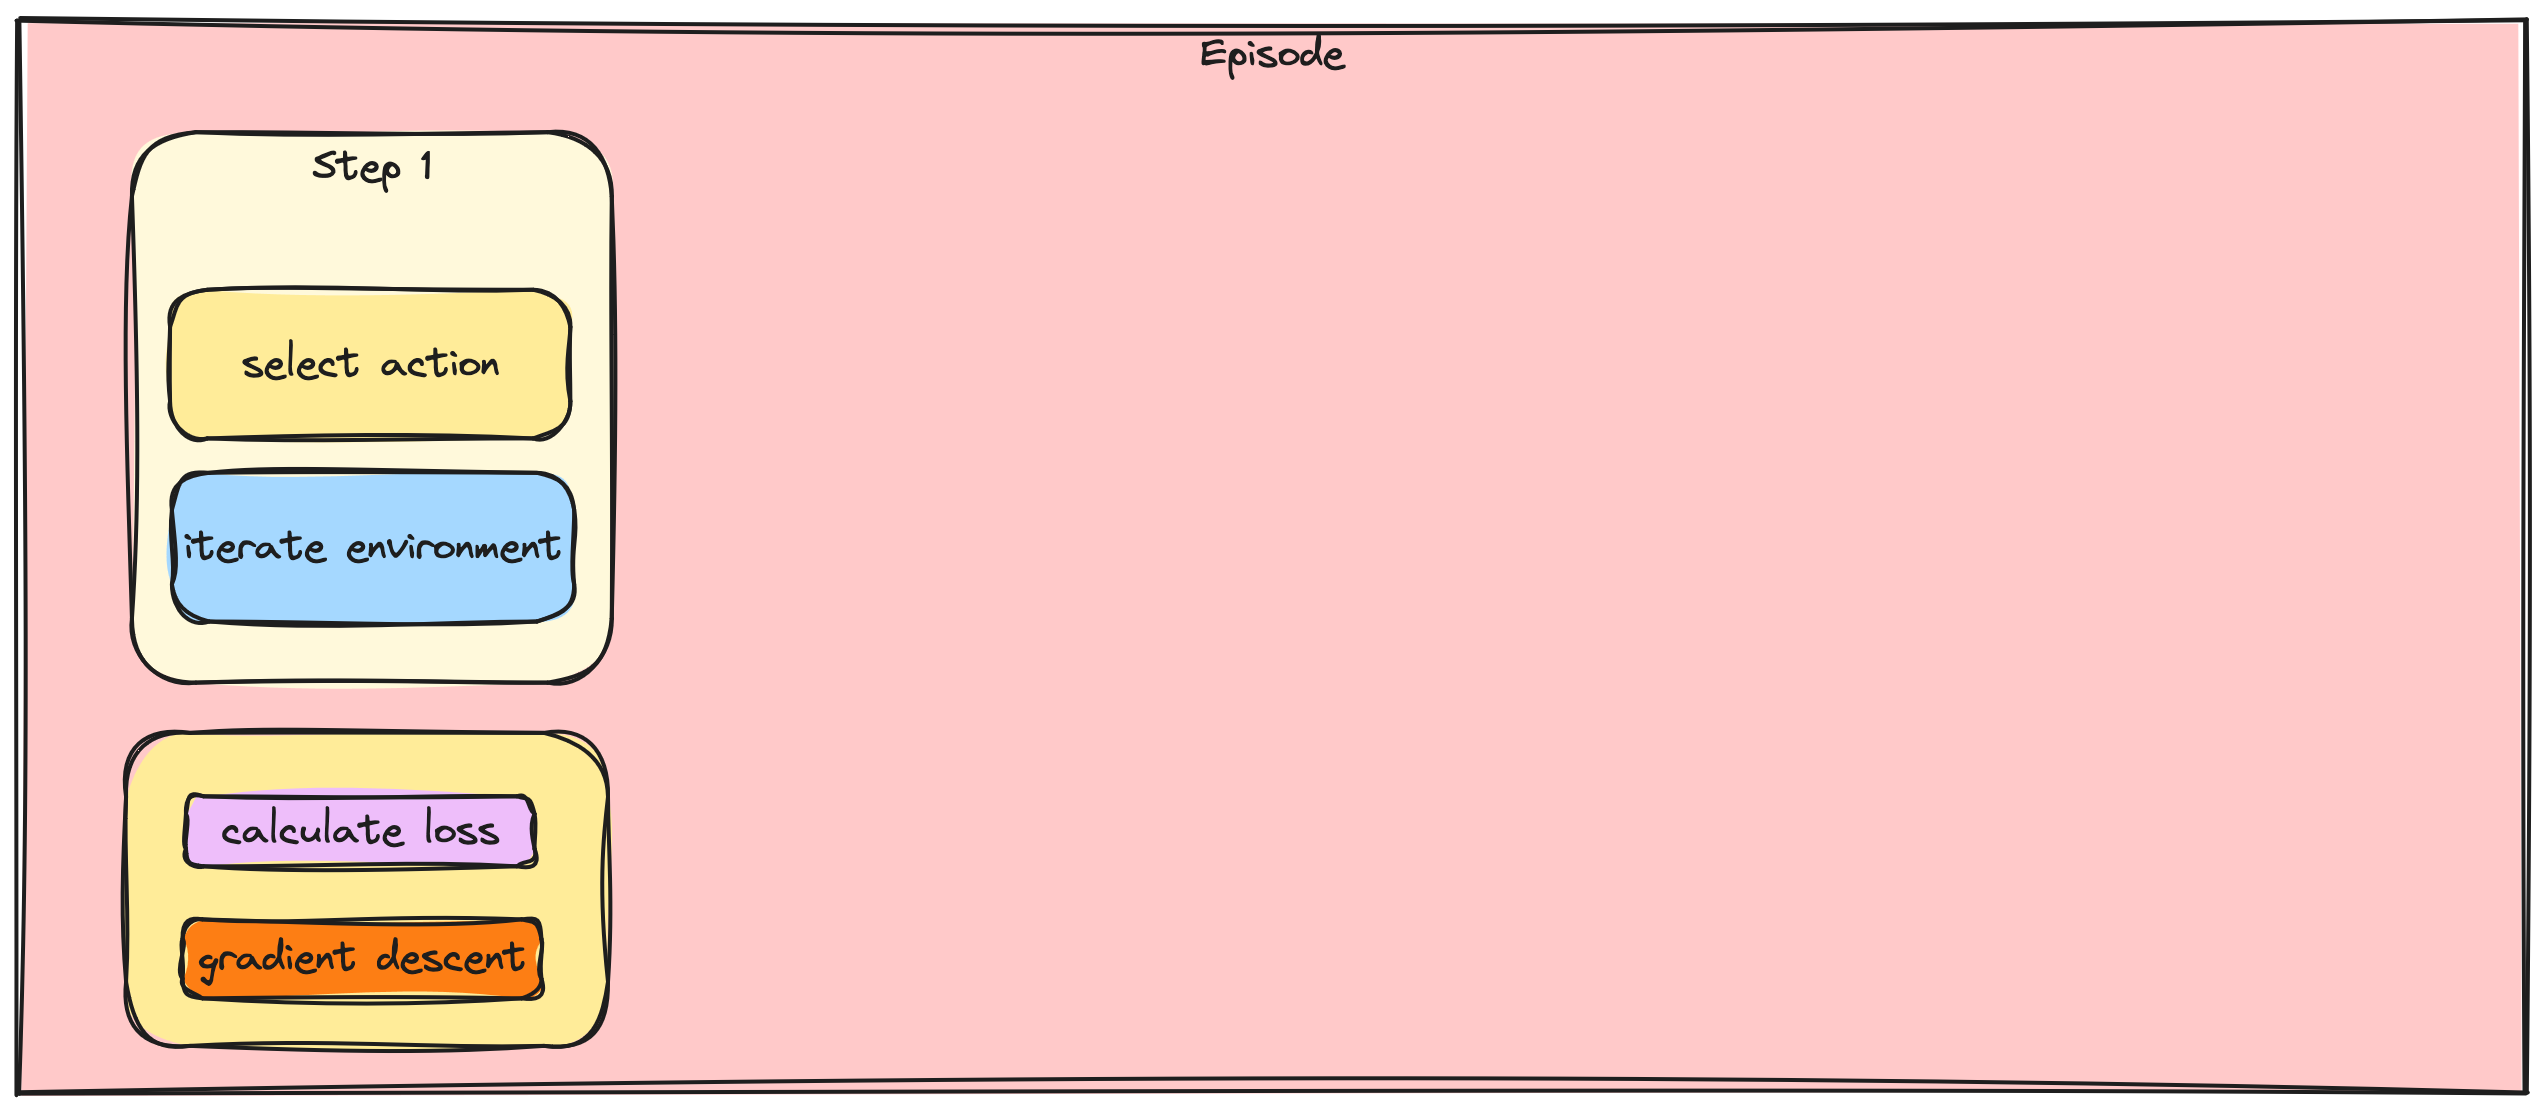
Sous la boîte de l'étape 1, une autre boîte avec les libellés « calculer la loss » et « descente de gradient ».

Apprentissage par renforcement profond en Python

Mises à jour du gradient pas à pas vs par lots
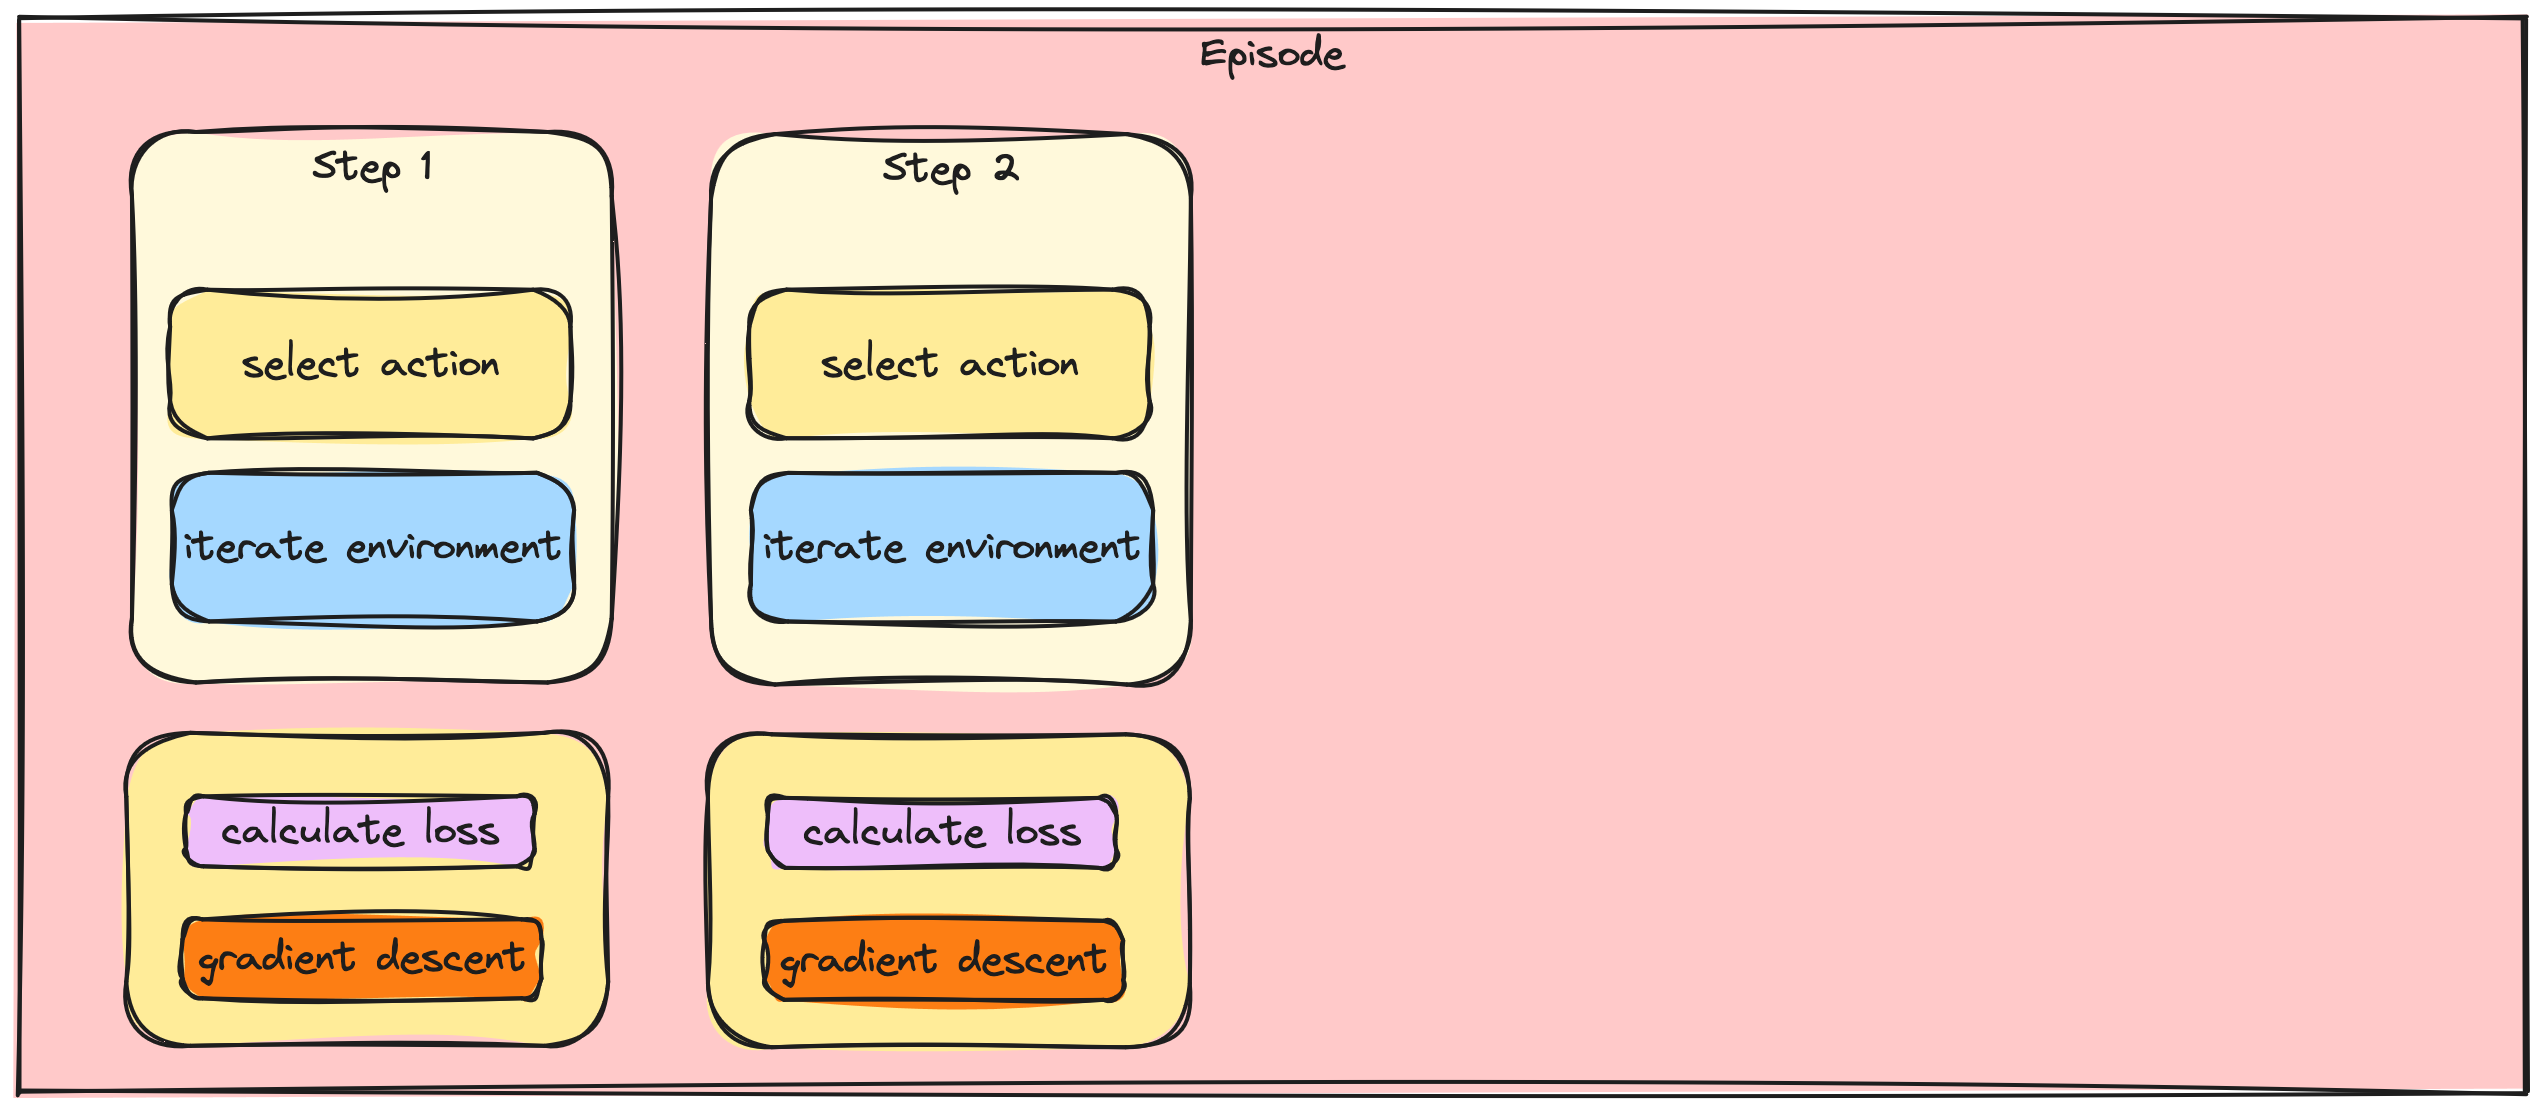
Un duo de boîtes identiques apparaît pour la deuxième étape, avec le même contenu.

Apprentissage par renforcement profond en Python

Mises à jour du gradient pas à pas vs par lots
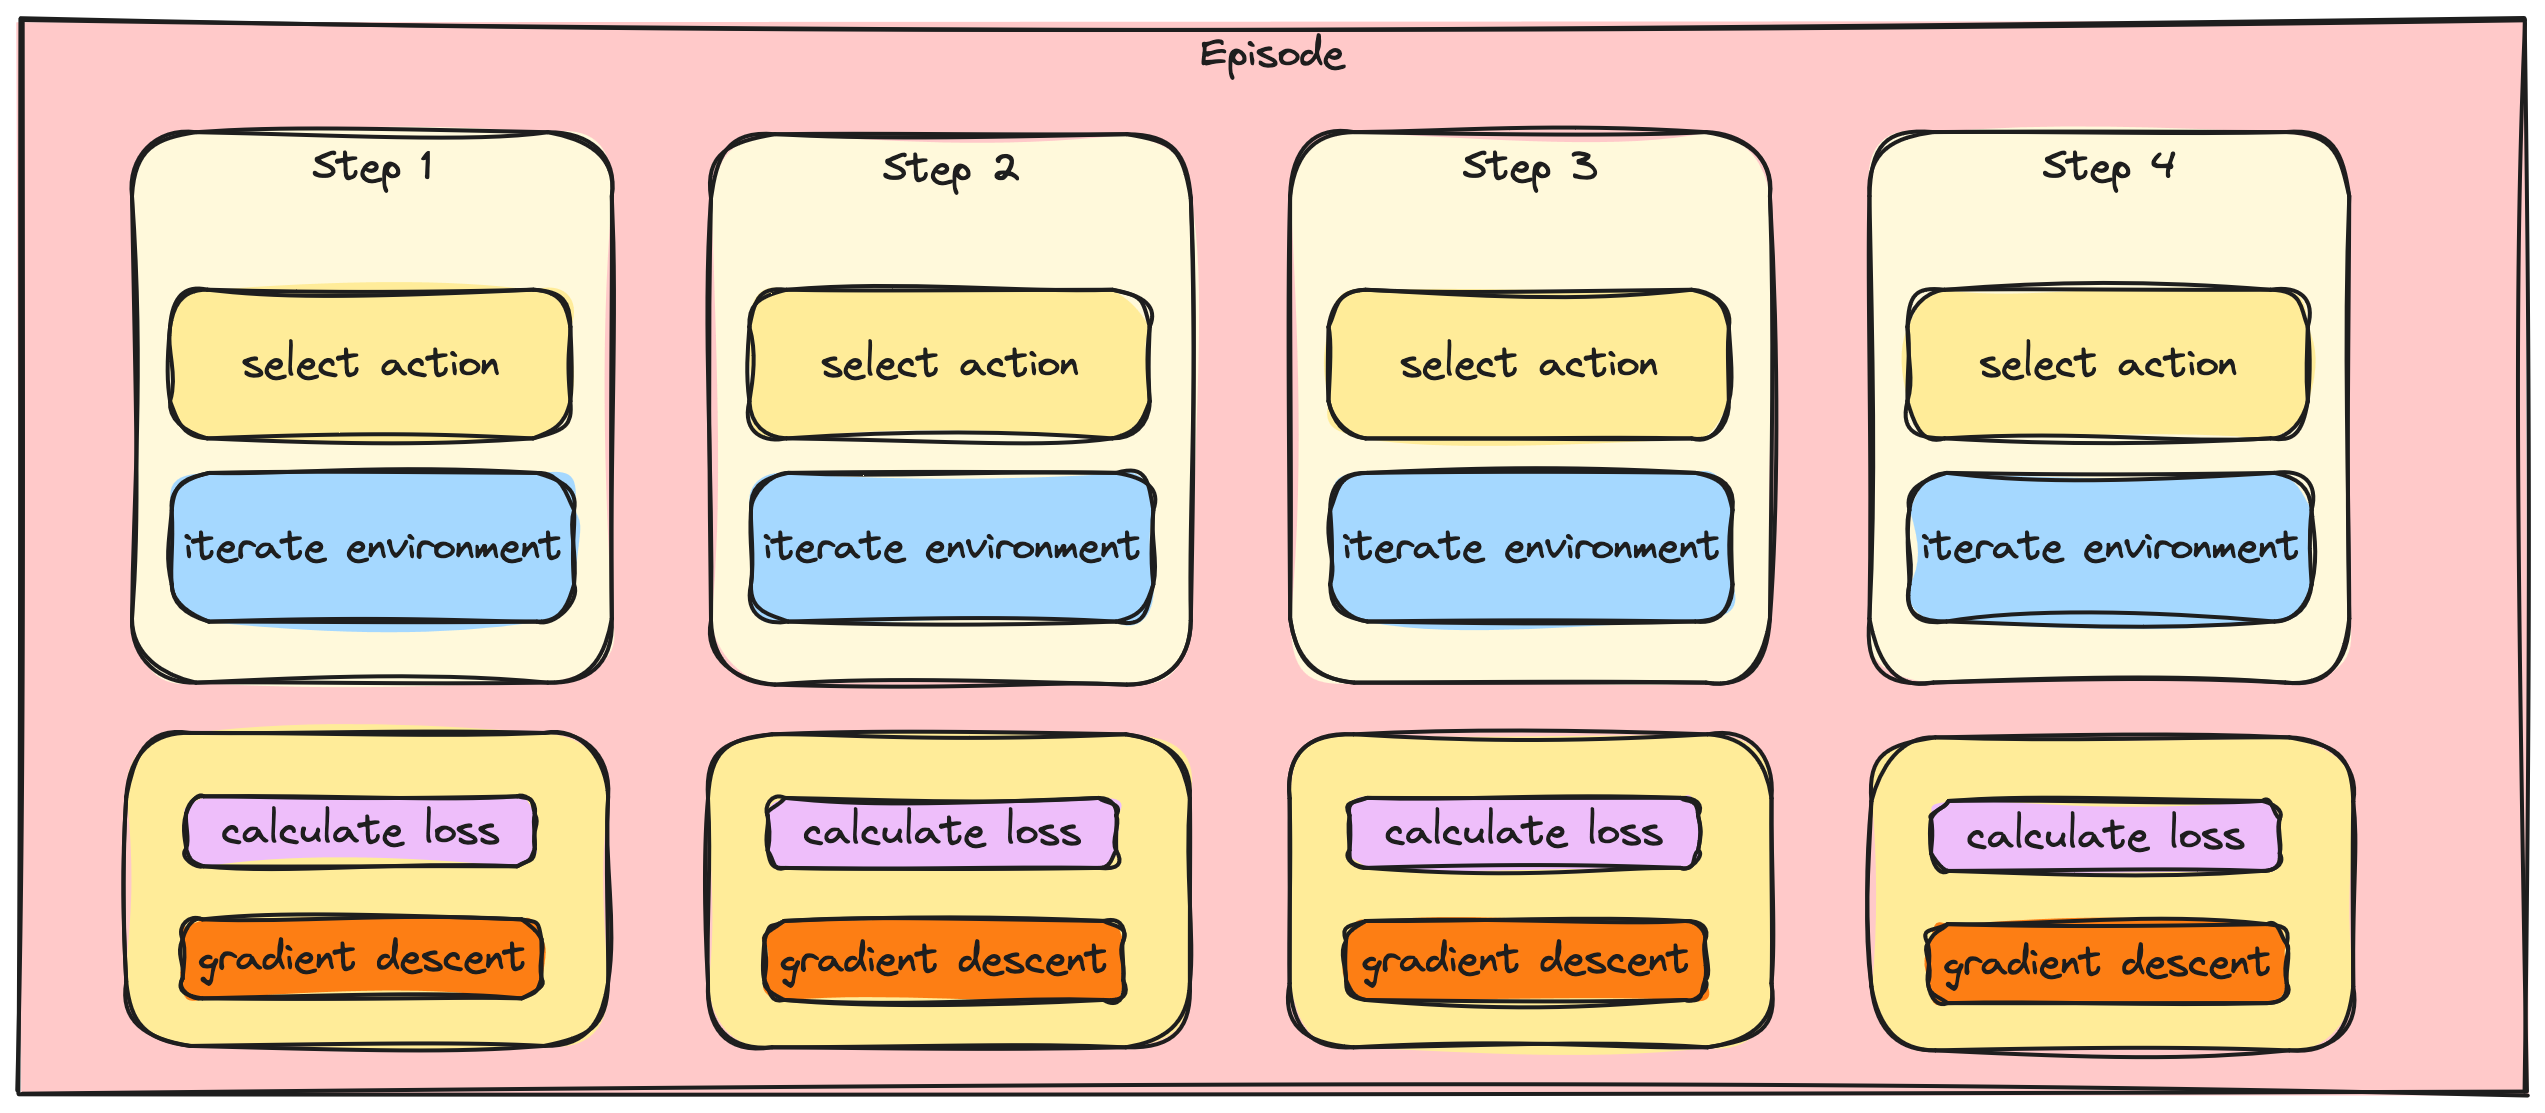
Les étapes 3 et 4 apparaissent aussi.

Apprentissage par renforcement profond en Python

Regrouper les mises à jour A2C / PPO

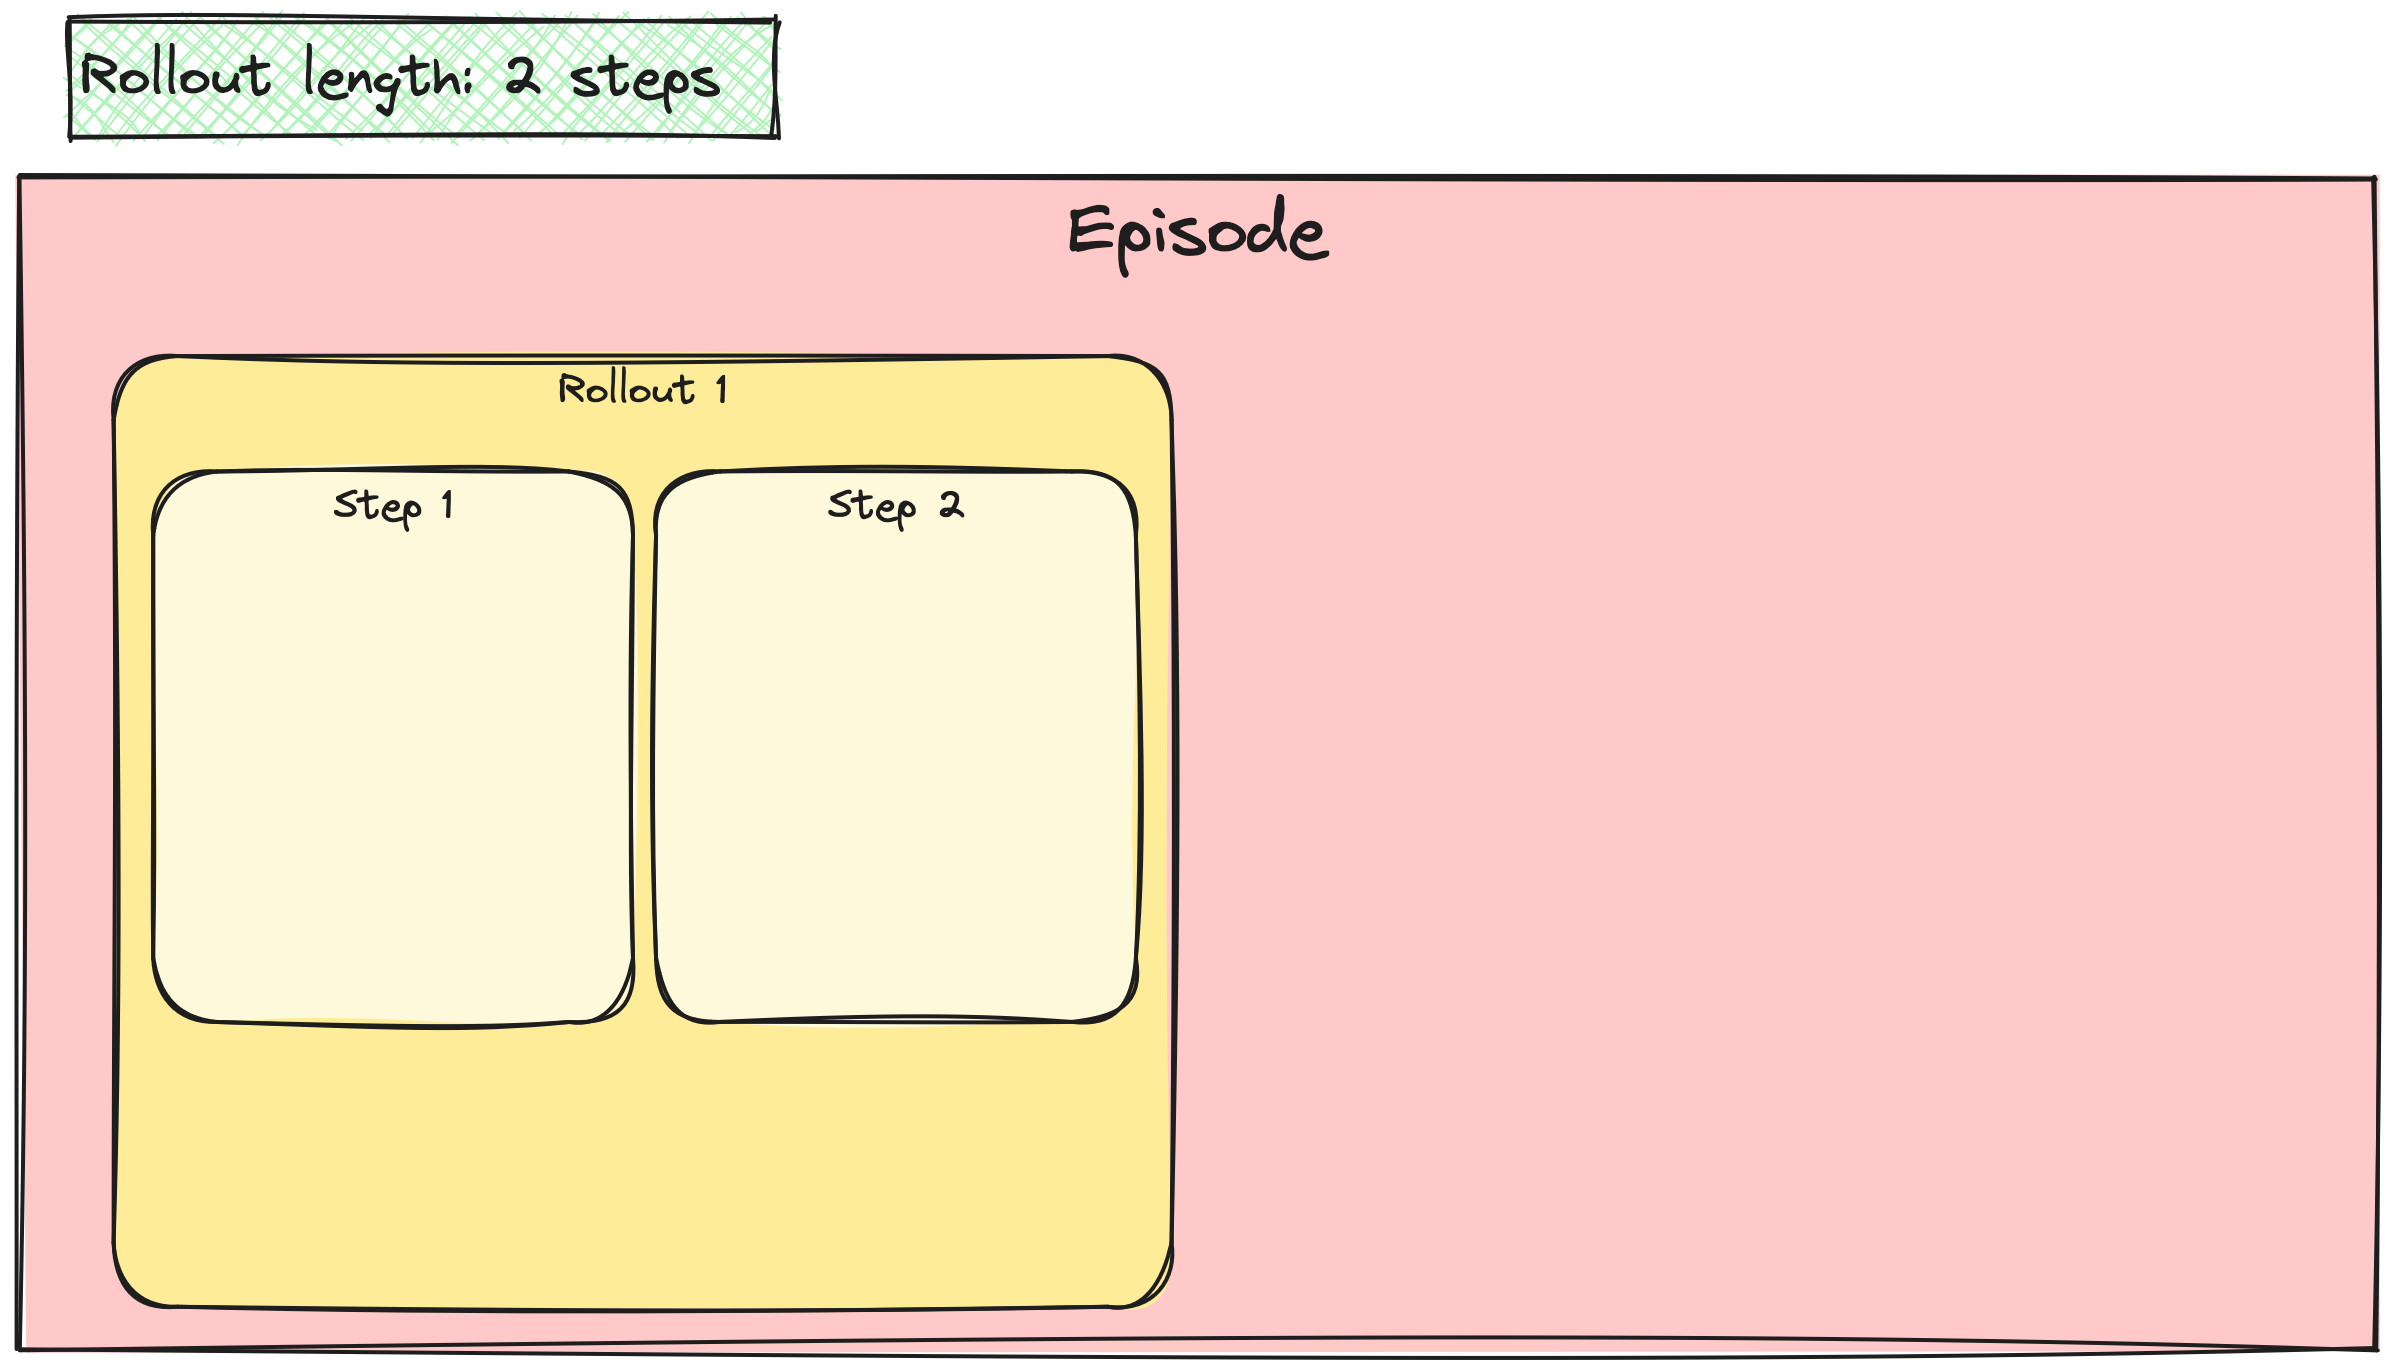
Une grande boîte « épisode » ; sur la moitié de sa surface, une autre boîte « rollout 1 » ; à l'intérieur, deux boîtes vides « étape 1 » et « étape 2 ».

Apprentissage par renforcement profond en Python

Regrouper les mises à jour A2C / PPO

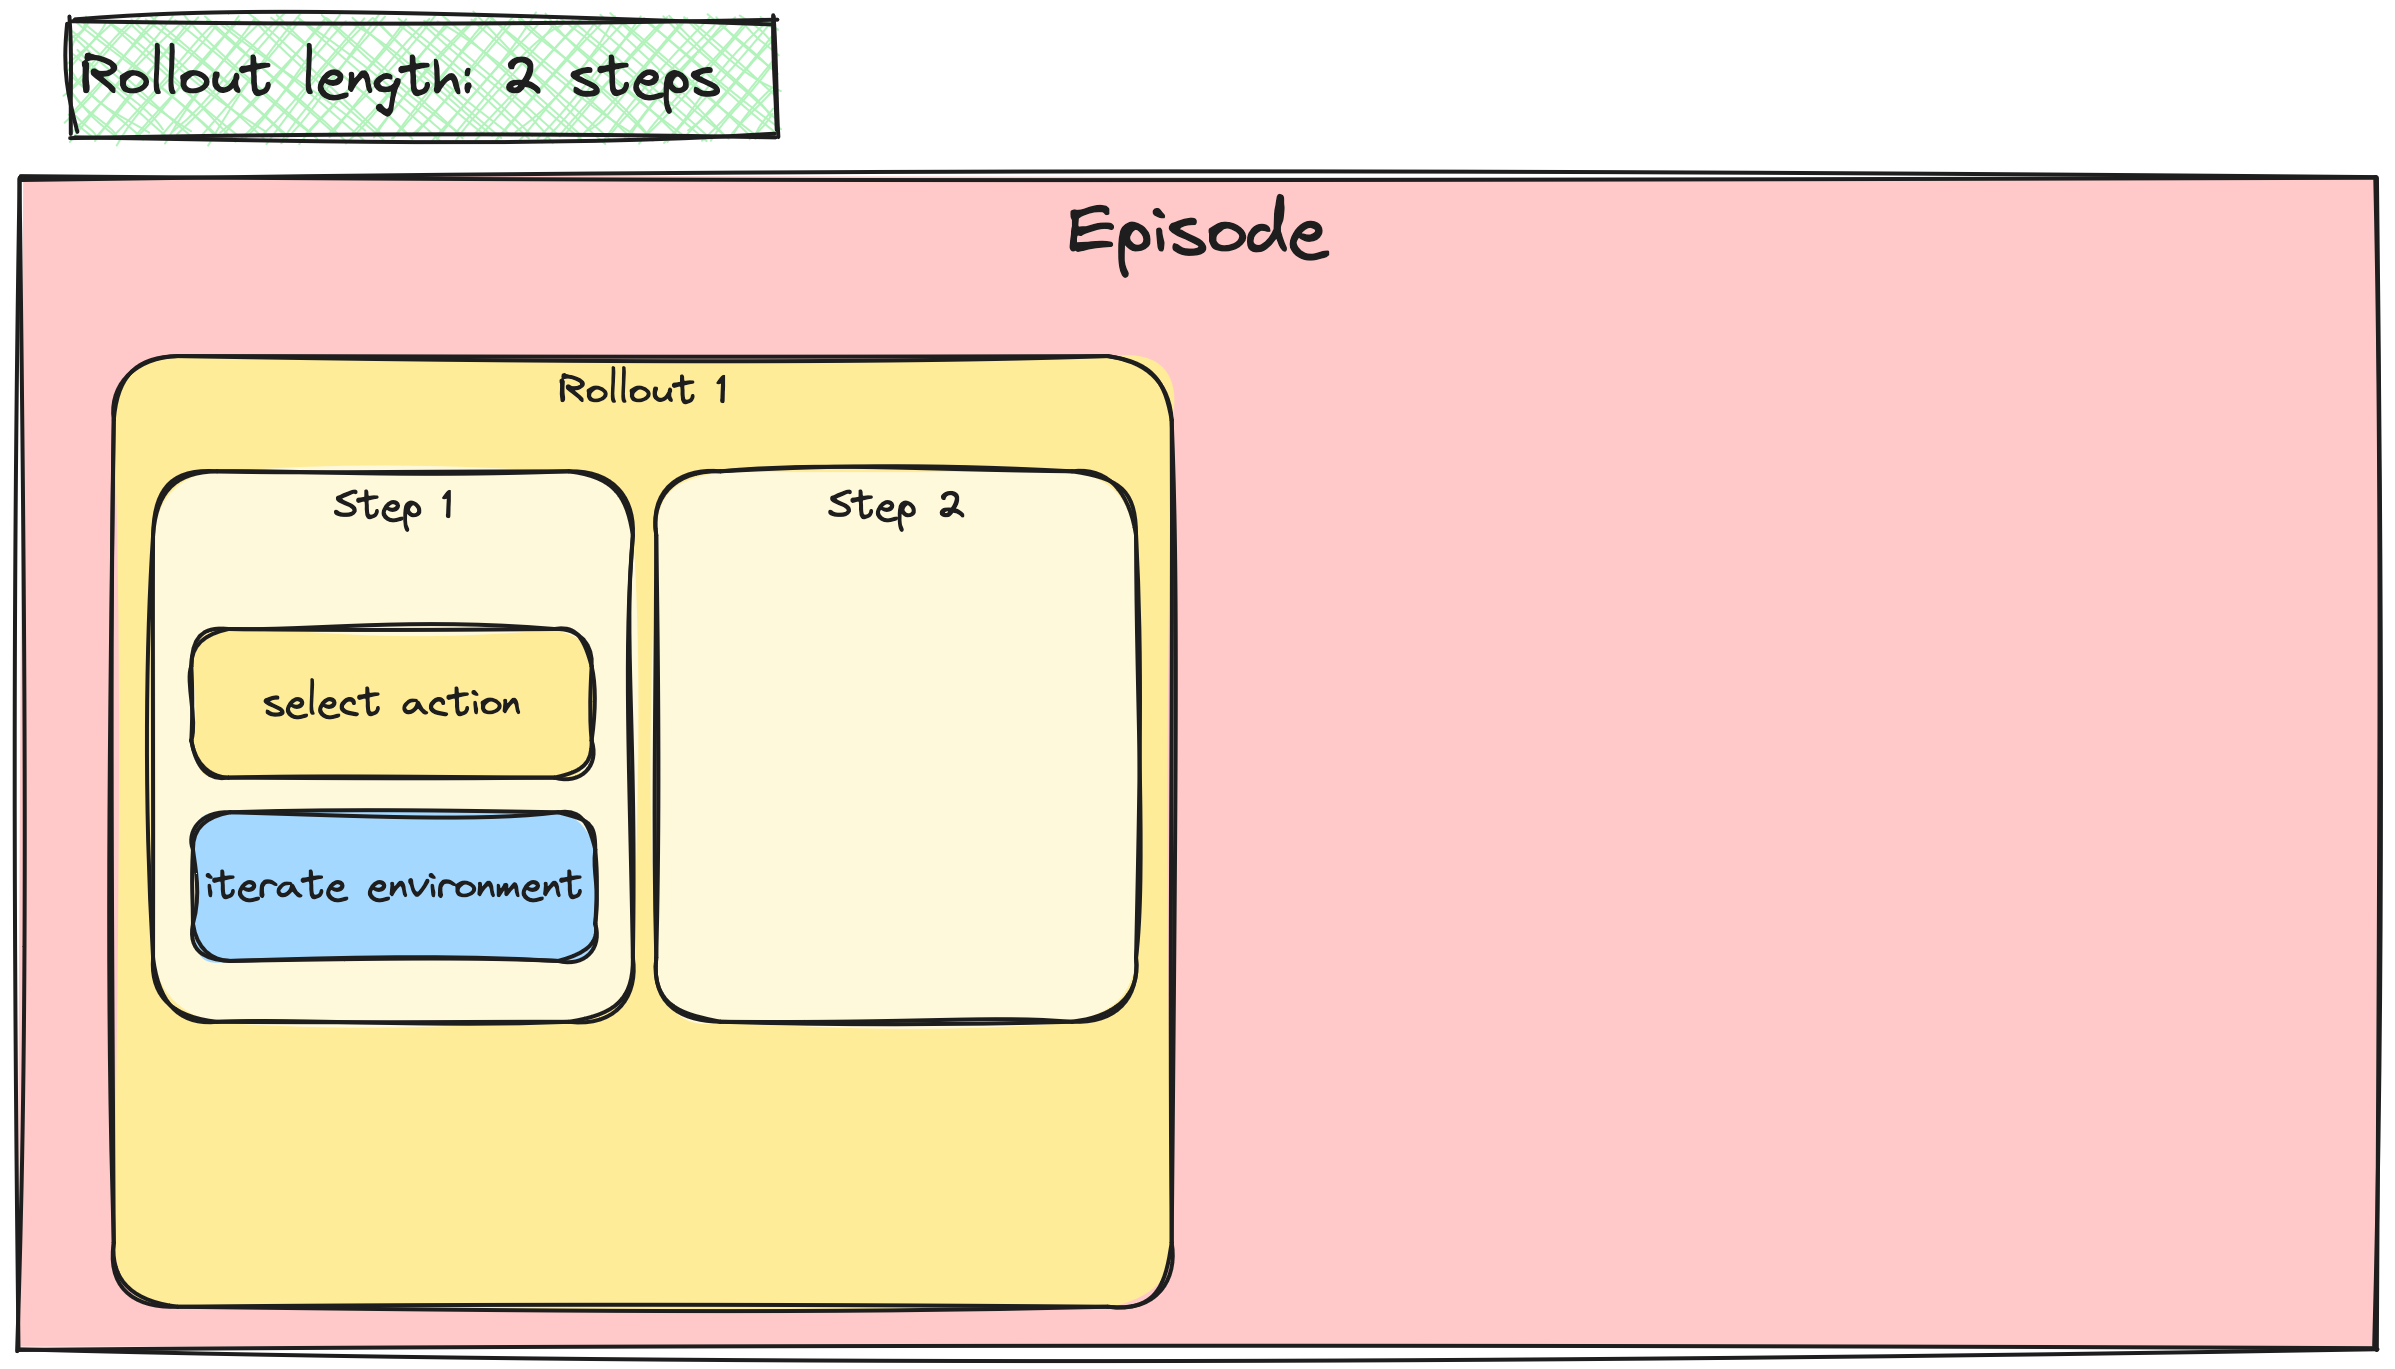
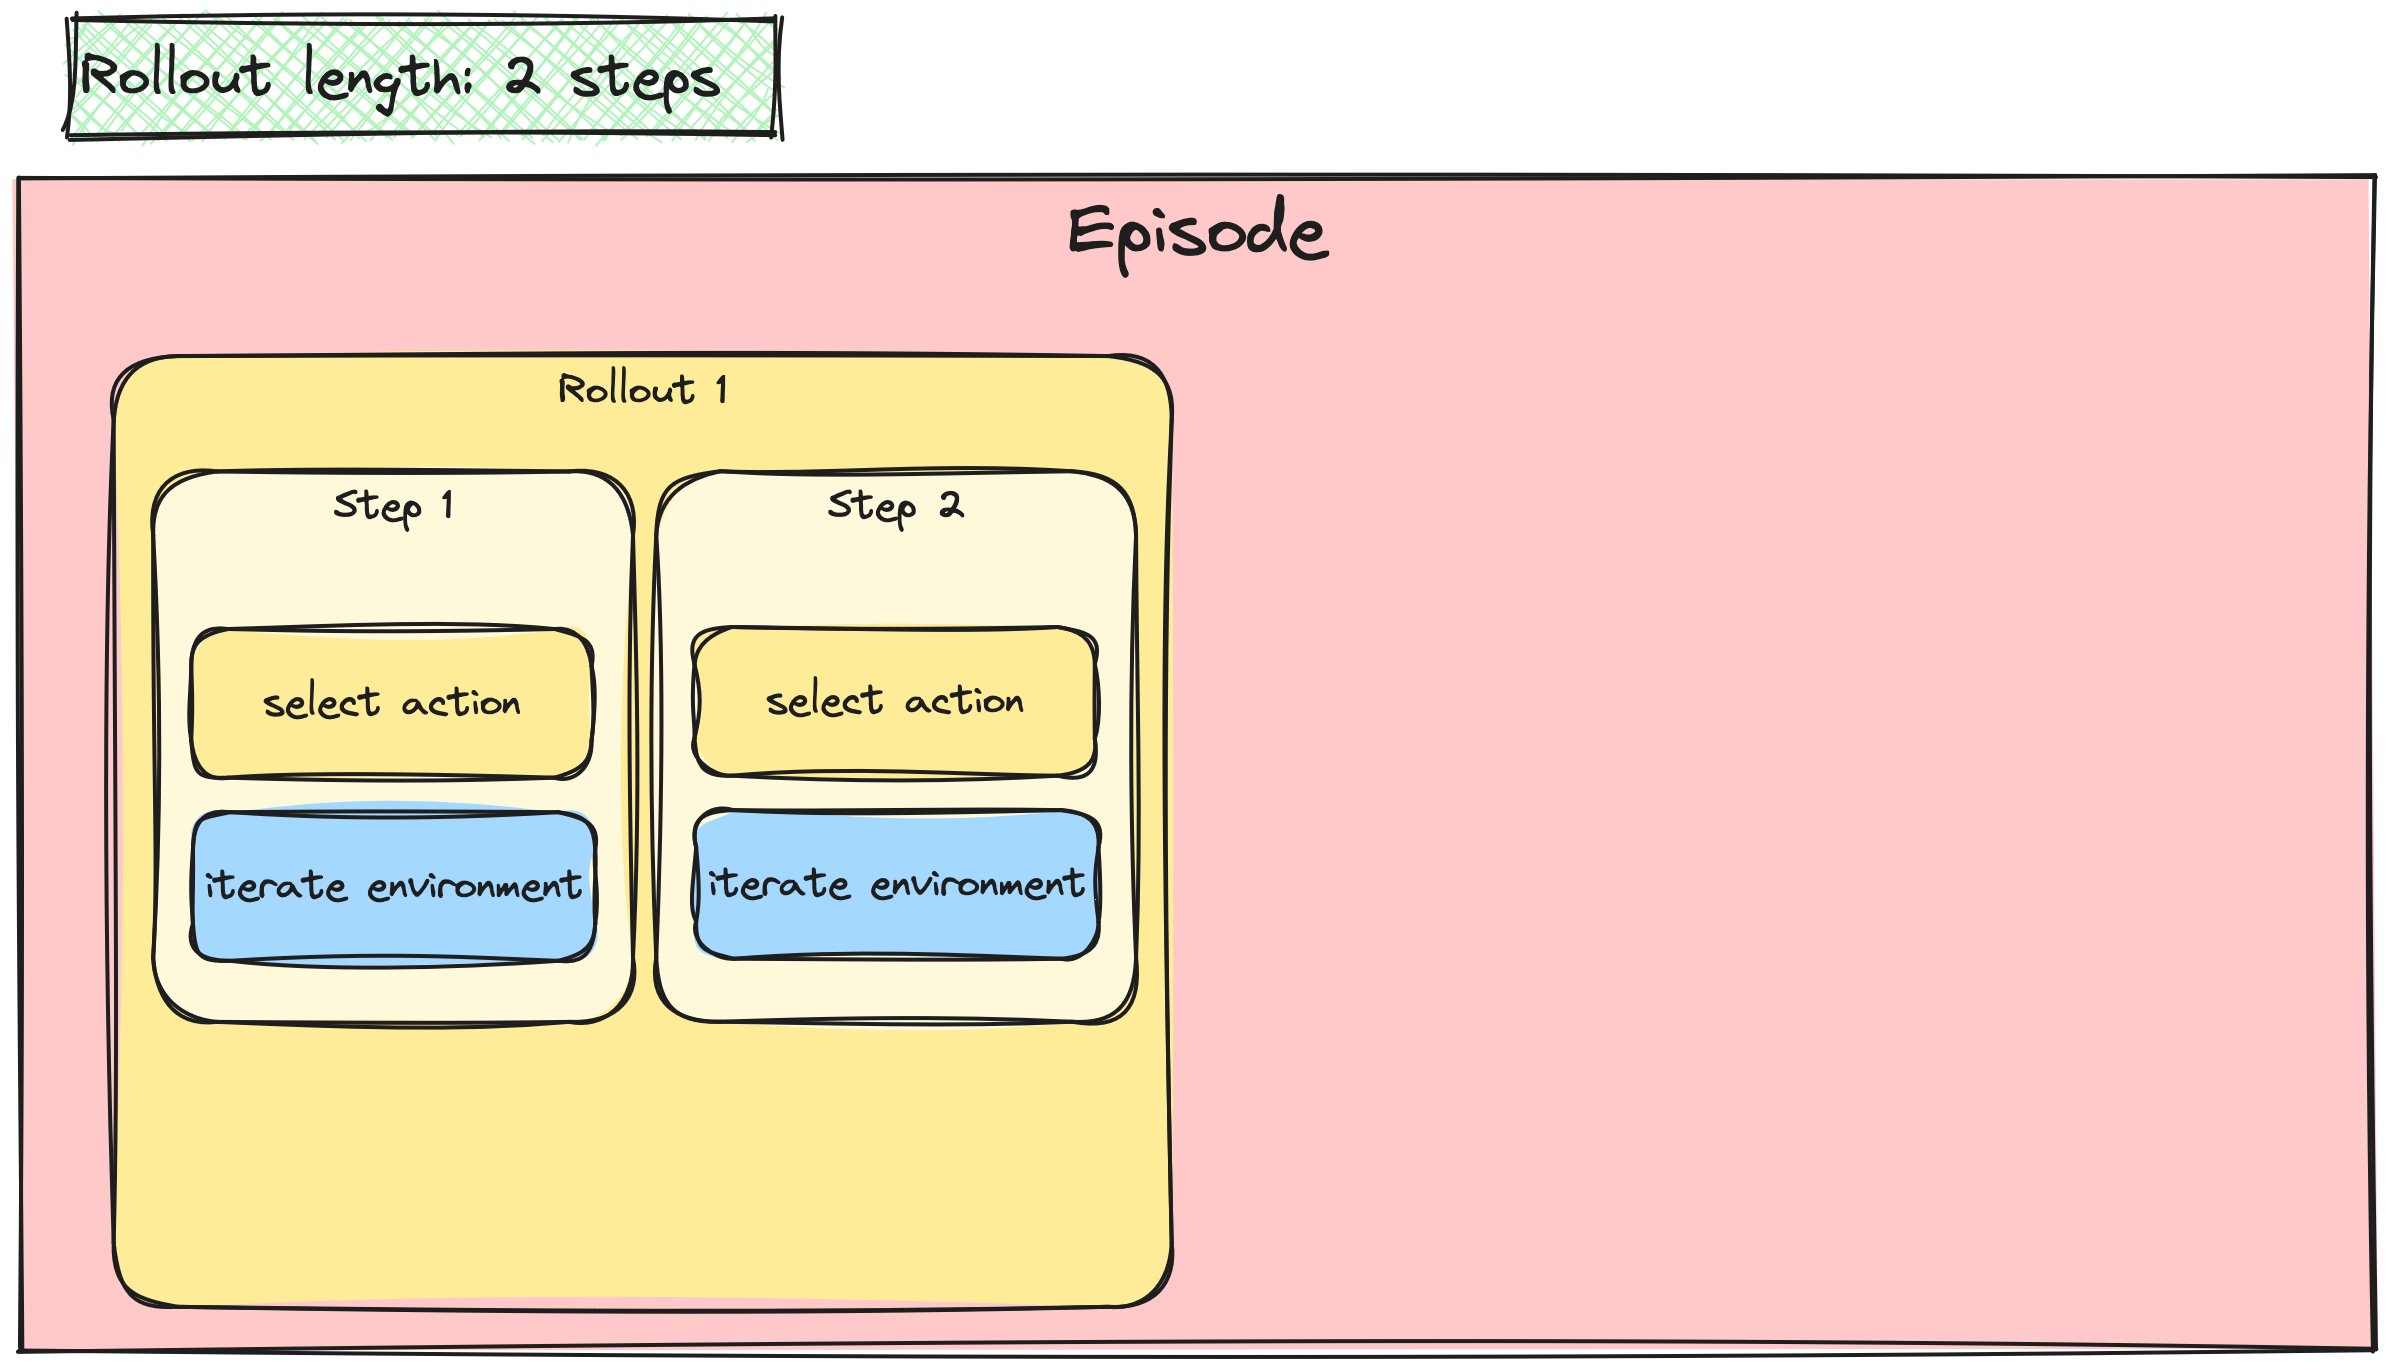
Dans la boîte de l'étape 1, les libellés « sélectionner une action » et « itérer l'environnement » apparaissent.

Apprentissage par renforcement profond en Python

Regrouper les mises à jour A2C / PPO

Idem pour l'étape 2.

Apprentissage par renforcement profond en Python

Regrouper les mises à jour A2C / PPO

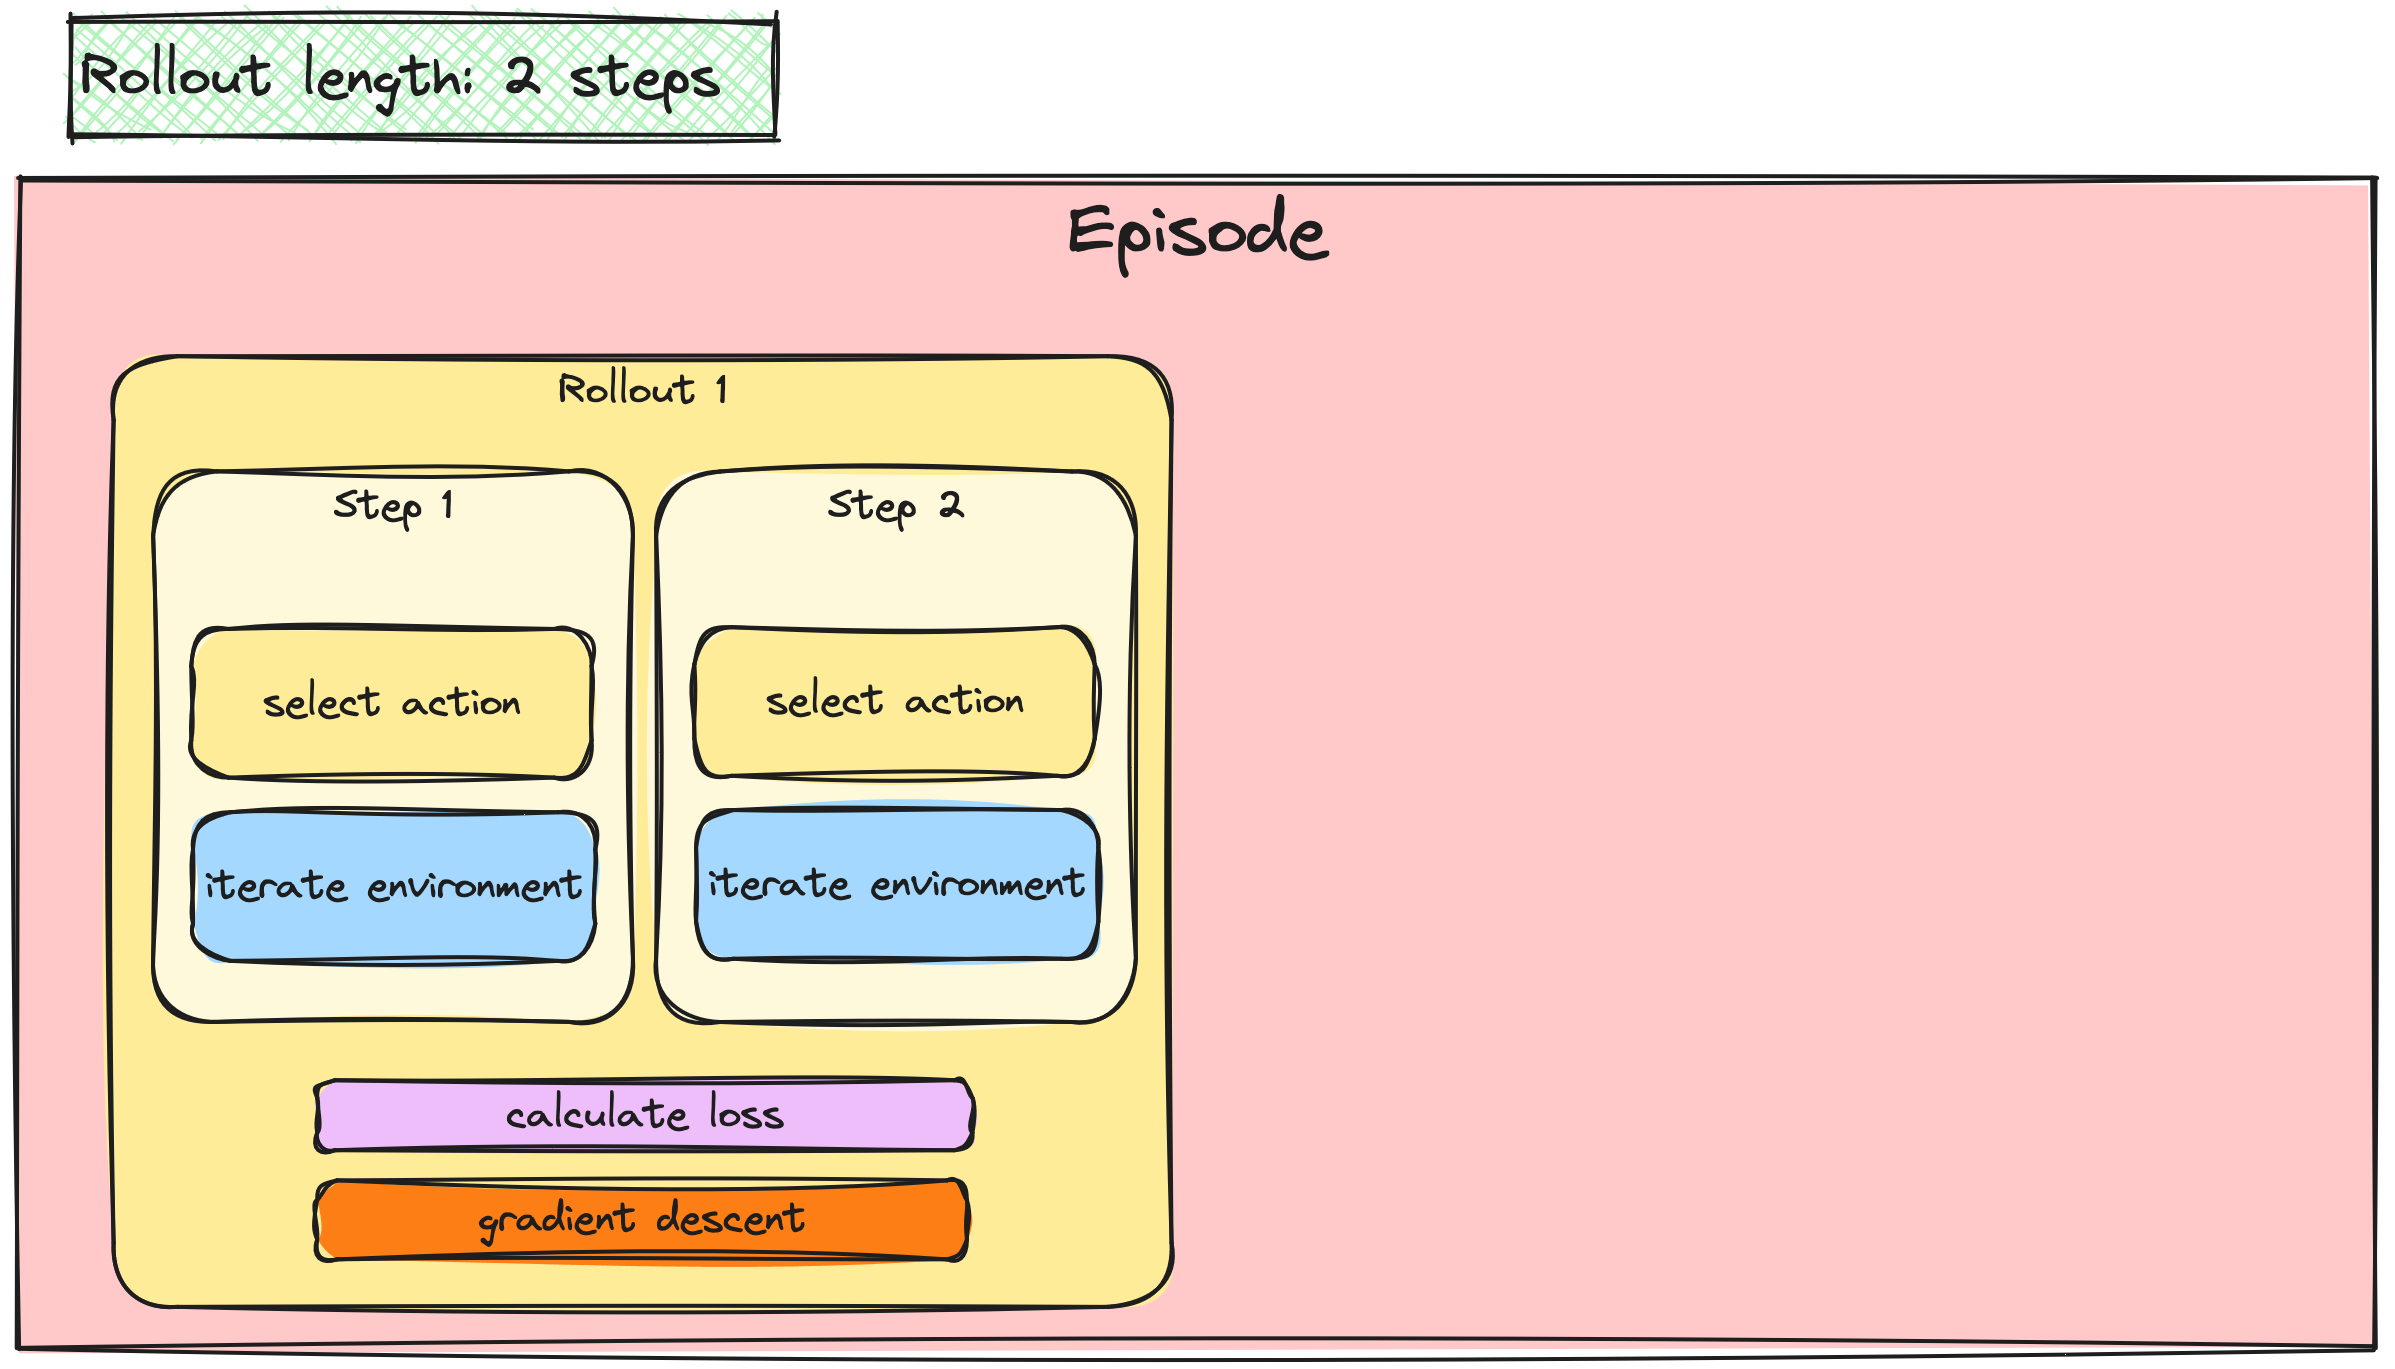
Sous les boîtes des étapes 1 et 2, un seul libellé « calculer la loss » et un seul « descente de gradient ».

Apprentissage par renforcement profond en Python

Regrouper les mises à jour A2C / PPO

La moitié restante de la zone épisode est occupée par une autre boîte de rollout identique à deux étapes, « rollout 2 ».

Apprentissage par renforcement profond en Python

Boucle d'entraînement A2C avec mises à jour par lots


# Set rollout length
rollout_length = 10

# Initiate loss batches
actor_losses = torch.tensor([]) critic_losses = torch.tensor([])
  • Initialiser les lots de pertes
  • Parcourir épisodes et étapes comme d'habitude


for episode in range(10):
  state, info = env.reset()
  done = False
  while not done:
    action, action_log_prob = select_action(actor, 
                                            state)                
    next_state, reward, terminated, truncated, _ = (
                                   env.step(action))
    done = terminated or truncated    
    actor_loss, critic_loss = calculate_losses(
        critic, action_log_prob, 
        reward, state, next_state, done)
    ...
Apprentissage par renforcement profond en Python

Boucle d'entraînement A2C avec mises à jour par lots

  ...
  actor_losses = torch.cat((actor_losses, actor_loss))
  critic_losses = torch.cat((critic_losses, critic_loss))

# If rollout is full, update the networks if len(actor_losses) >= rollout_length:
actor_loss_batch = actor_losses.mean() critic_loss_batch = critic_losses.mean()
actor_optimizer.zero_grad() actor_loss_batch.backward() actor_optimizer.step() critic_optimizer.zero_grad() critic_loss_batch.backward() critic_optimizer.step()
actor_losses = torch.tensor([]) critic_losses = torch.tensor([])
state = next_state


  • Ajouter la perte d'étape aux lots de pertes
  • Quand le rollout est plein :
    • Calculer la perte moyenne du lot avec .mean()
    • Effectuer la descente de gradient
    • Réinitialiser les lots de pertes
Apprentissage par renforcement profond en Python

A2C / PPO avec plusieurs agents


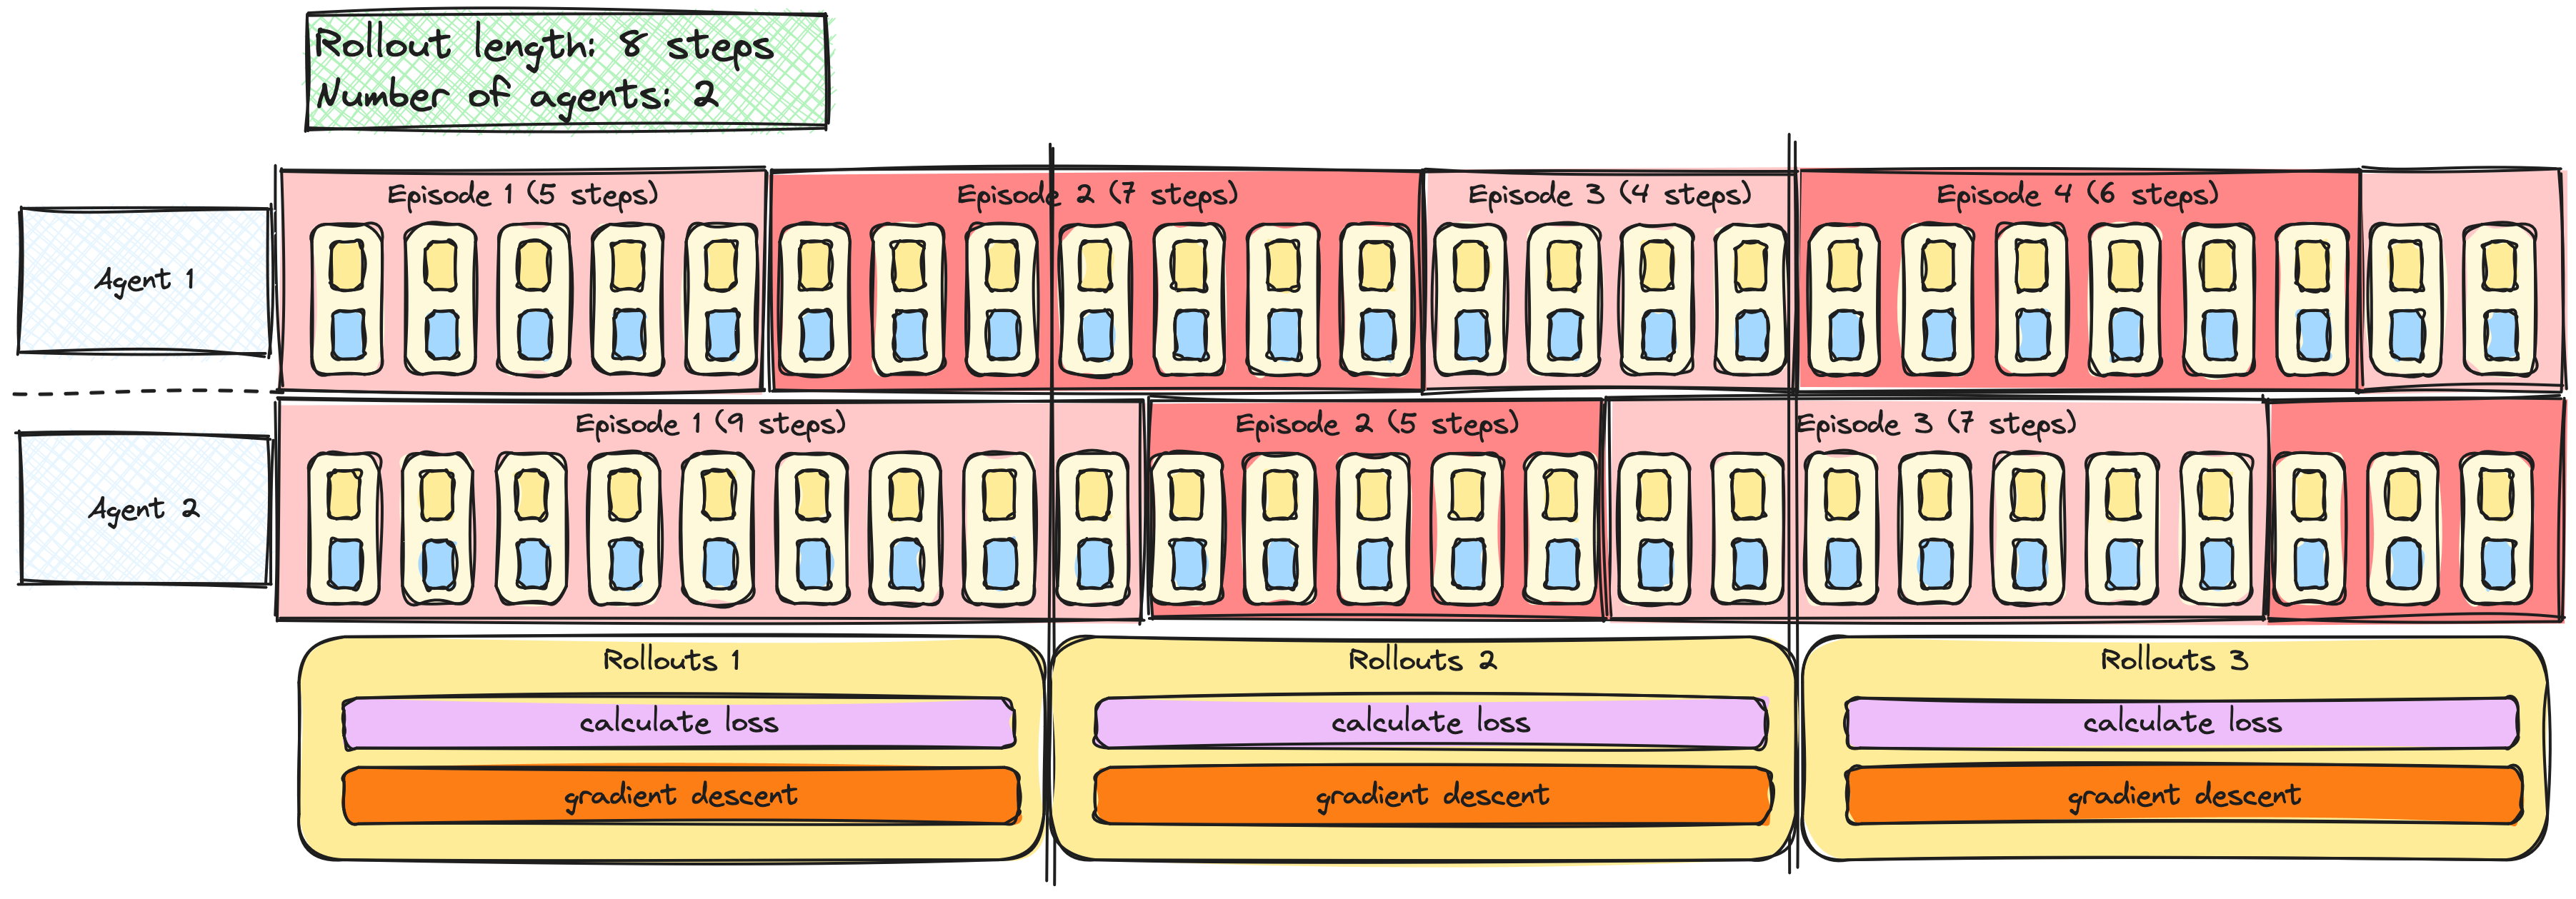
Deux bandes horizontales représentent l'agent 1 et l'agent 2. Chaque agent vit respectivement 4 et 3 épisodes de durées variables. Dans chaque épisode, des boîtes d'étapes sont visibles comme précédemment. Sous les deux bandes, trois boîtes de rollout couvrent des intervalles de 8 étapes, chacune avec « calculer la loss » et « descente de gradient ». En haut, une légende indique « longueur du rollout : 8 étapes ; nombre d'agents : 2 ».

Apprentissage par renforcement profond en Python

Rollouts et minilots

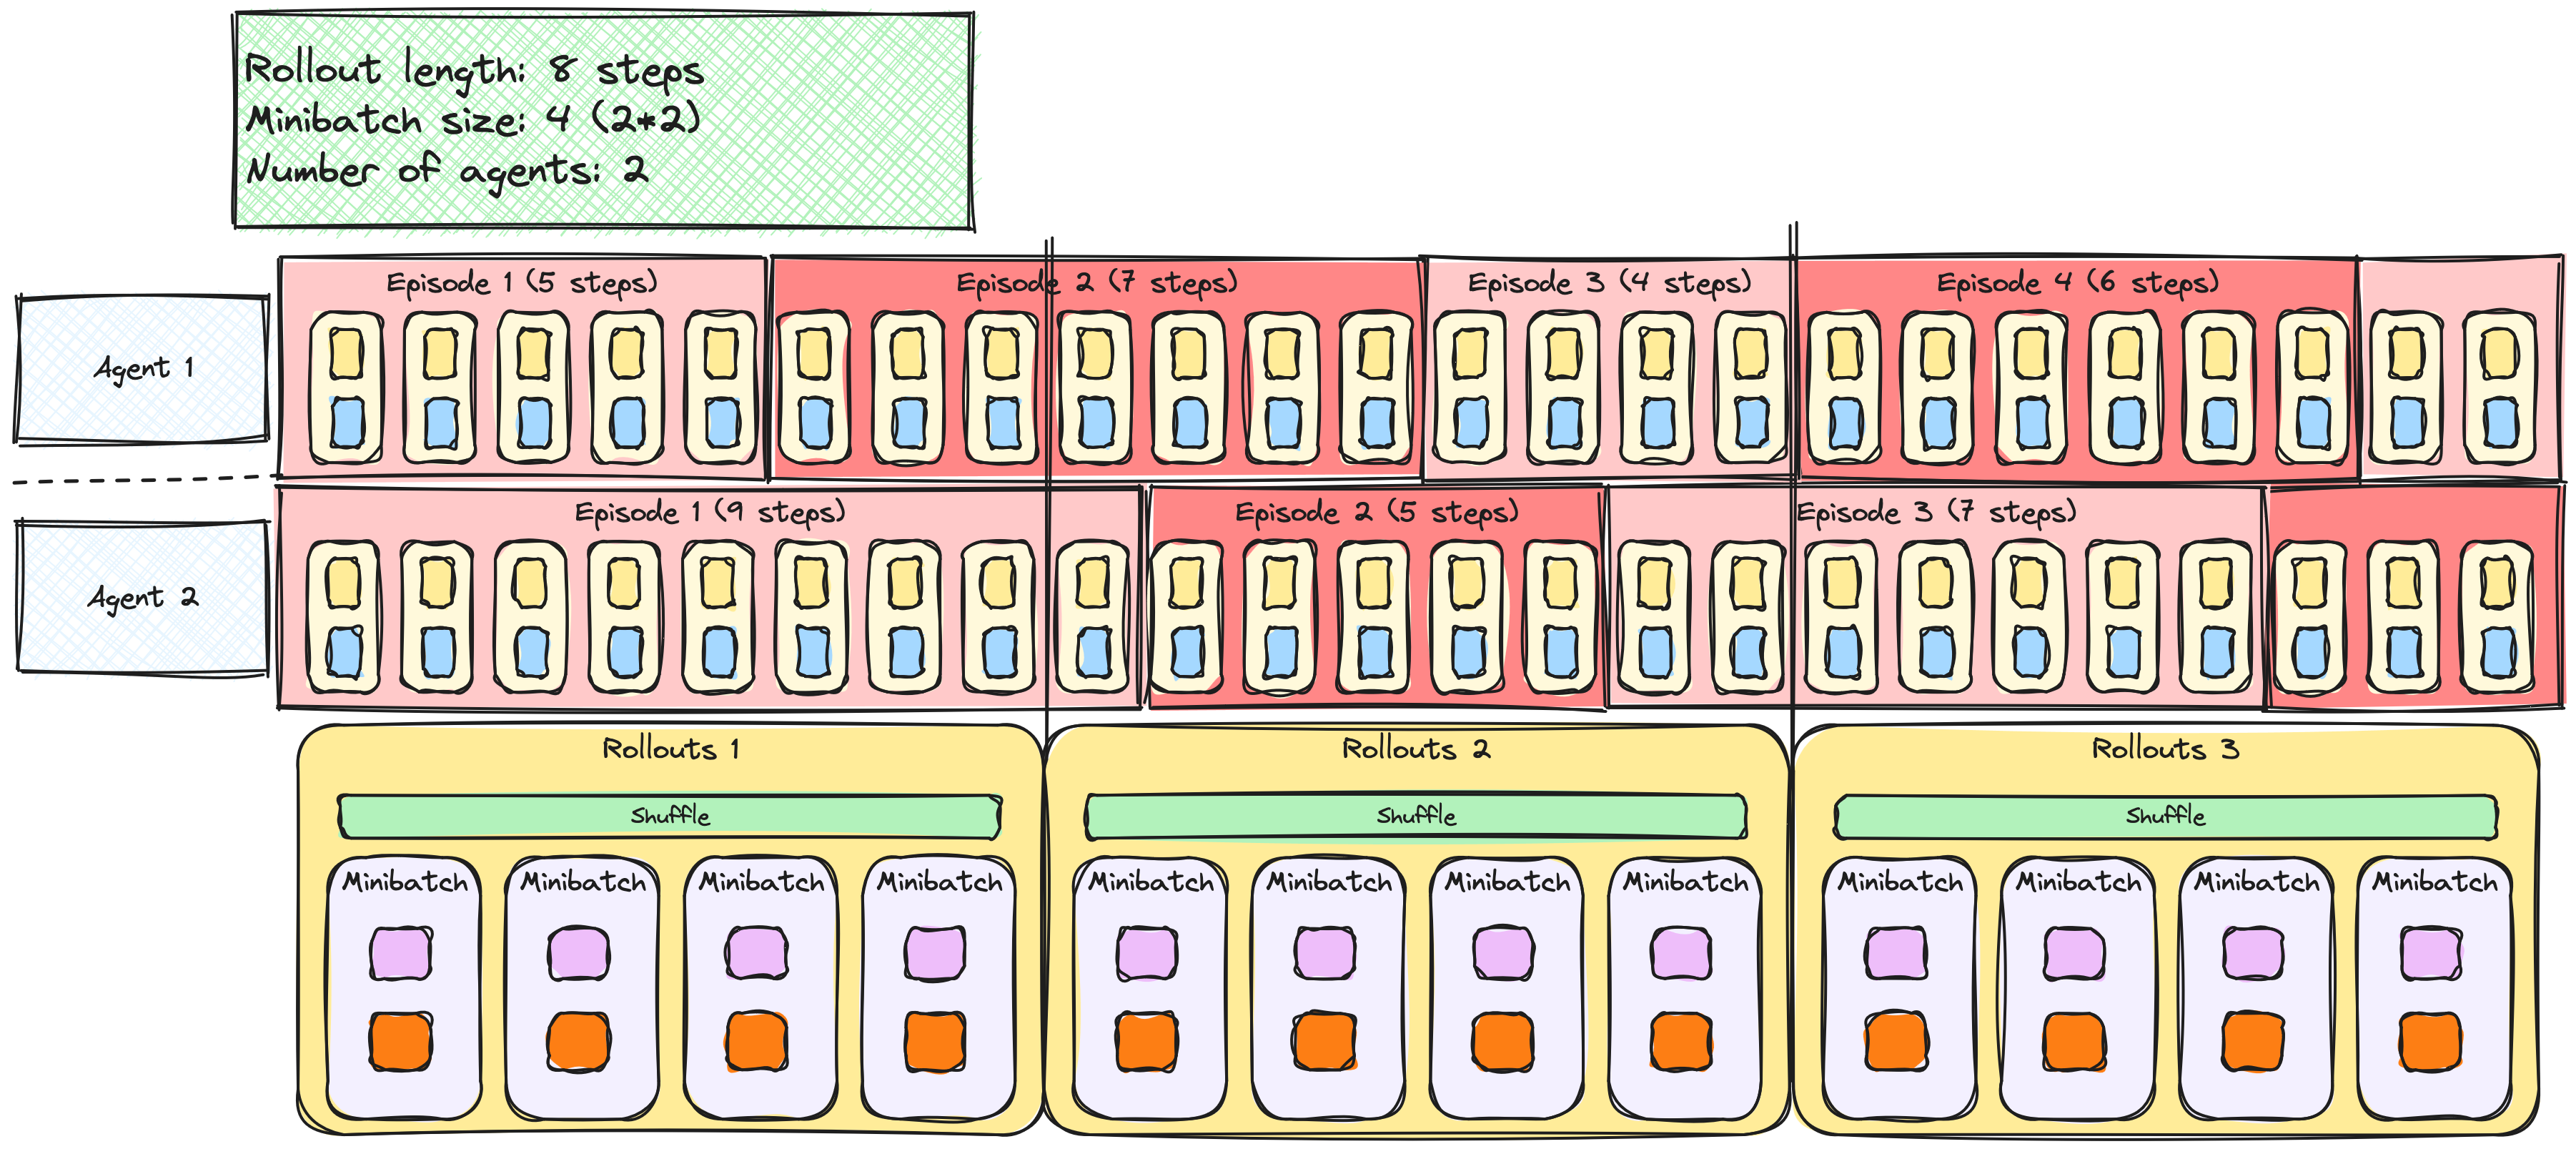
Deux bandes d'agents identiques à la diapositive précédente. En dessous, 3 boîtes de rollout visibles ; leur contenu change : en haut, une longue boîte « mélanger » ; en dessous, elles sont divisées en 4 « minilots », chacun contenant « calculer la loss » et « descente de gradient ». En haut, la légende indique : « Longueur du rollout : 8 étapes ; taille du minilot : 4 (2x2) ; nombre d'agents : 2 ».

Apprentissage par renforcement profond en Python

PPO avec plusieurs epochs

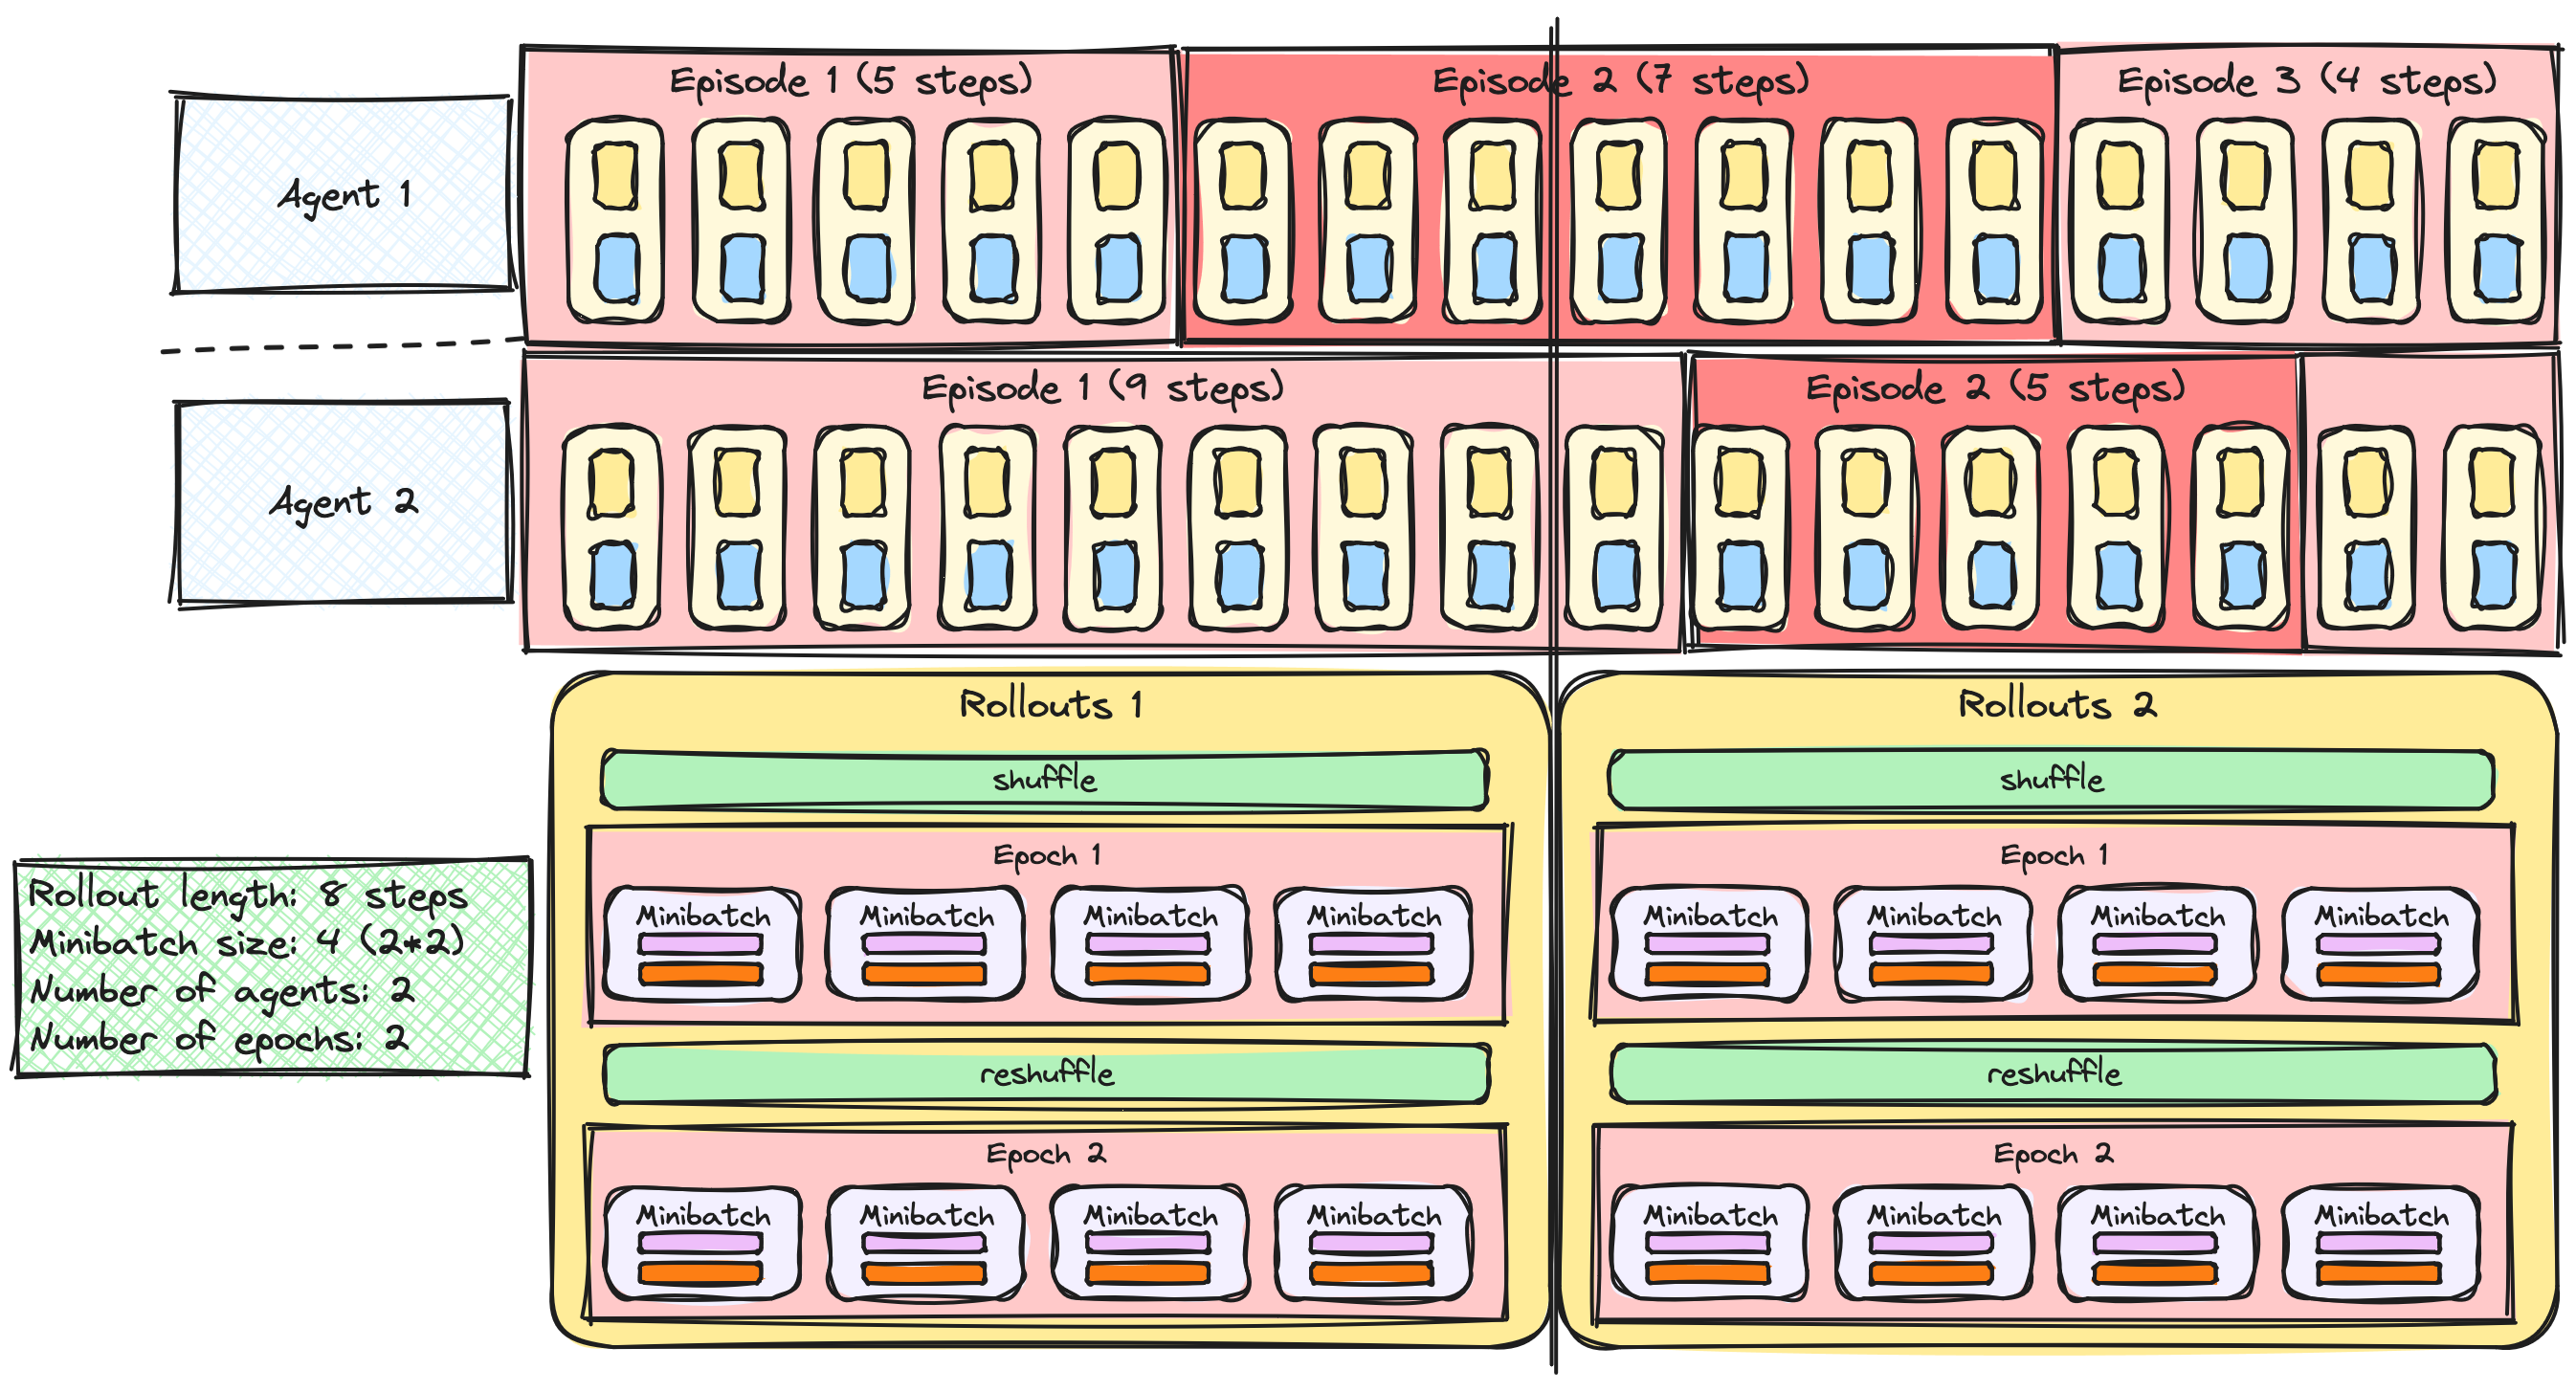
Un schéma très proche du précédent, sauf que les lots de rollout sont aussi découpés verticalement en 4 zones : en haut « mélanger » ; puis une grande boîte « epoch 1 » contenant 4 minilots en longueur ; ensuite « re-mélanger » ; enfin une grande boîte « epoch 2 », aussi avec 4 minilots. La légende : « Longueur du rollout : 8 étapes ; taille du minilot : 4 (2x2) ; nombre d'agents : 2 ; nombre d'epochs : 2 ».

Apprentissage par renforcement profond en Python

Passons à la pratique !

Apprentissage par renforcement profond en Python

Preparing Video For Download...