Double DQN

Apprentissage par renforcement profond en Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Double Q-learning

  • Le Q-learning surestime les valeurs Q, ce qui nuit à l'efficacité de l'apprentissage
  • C'est dû au biais de maximisation
  • Le Double Q-Learning supprime ce biais en séparant sélection d'action et estimation de valeur
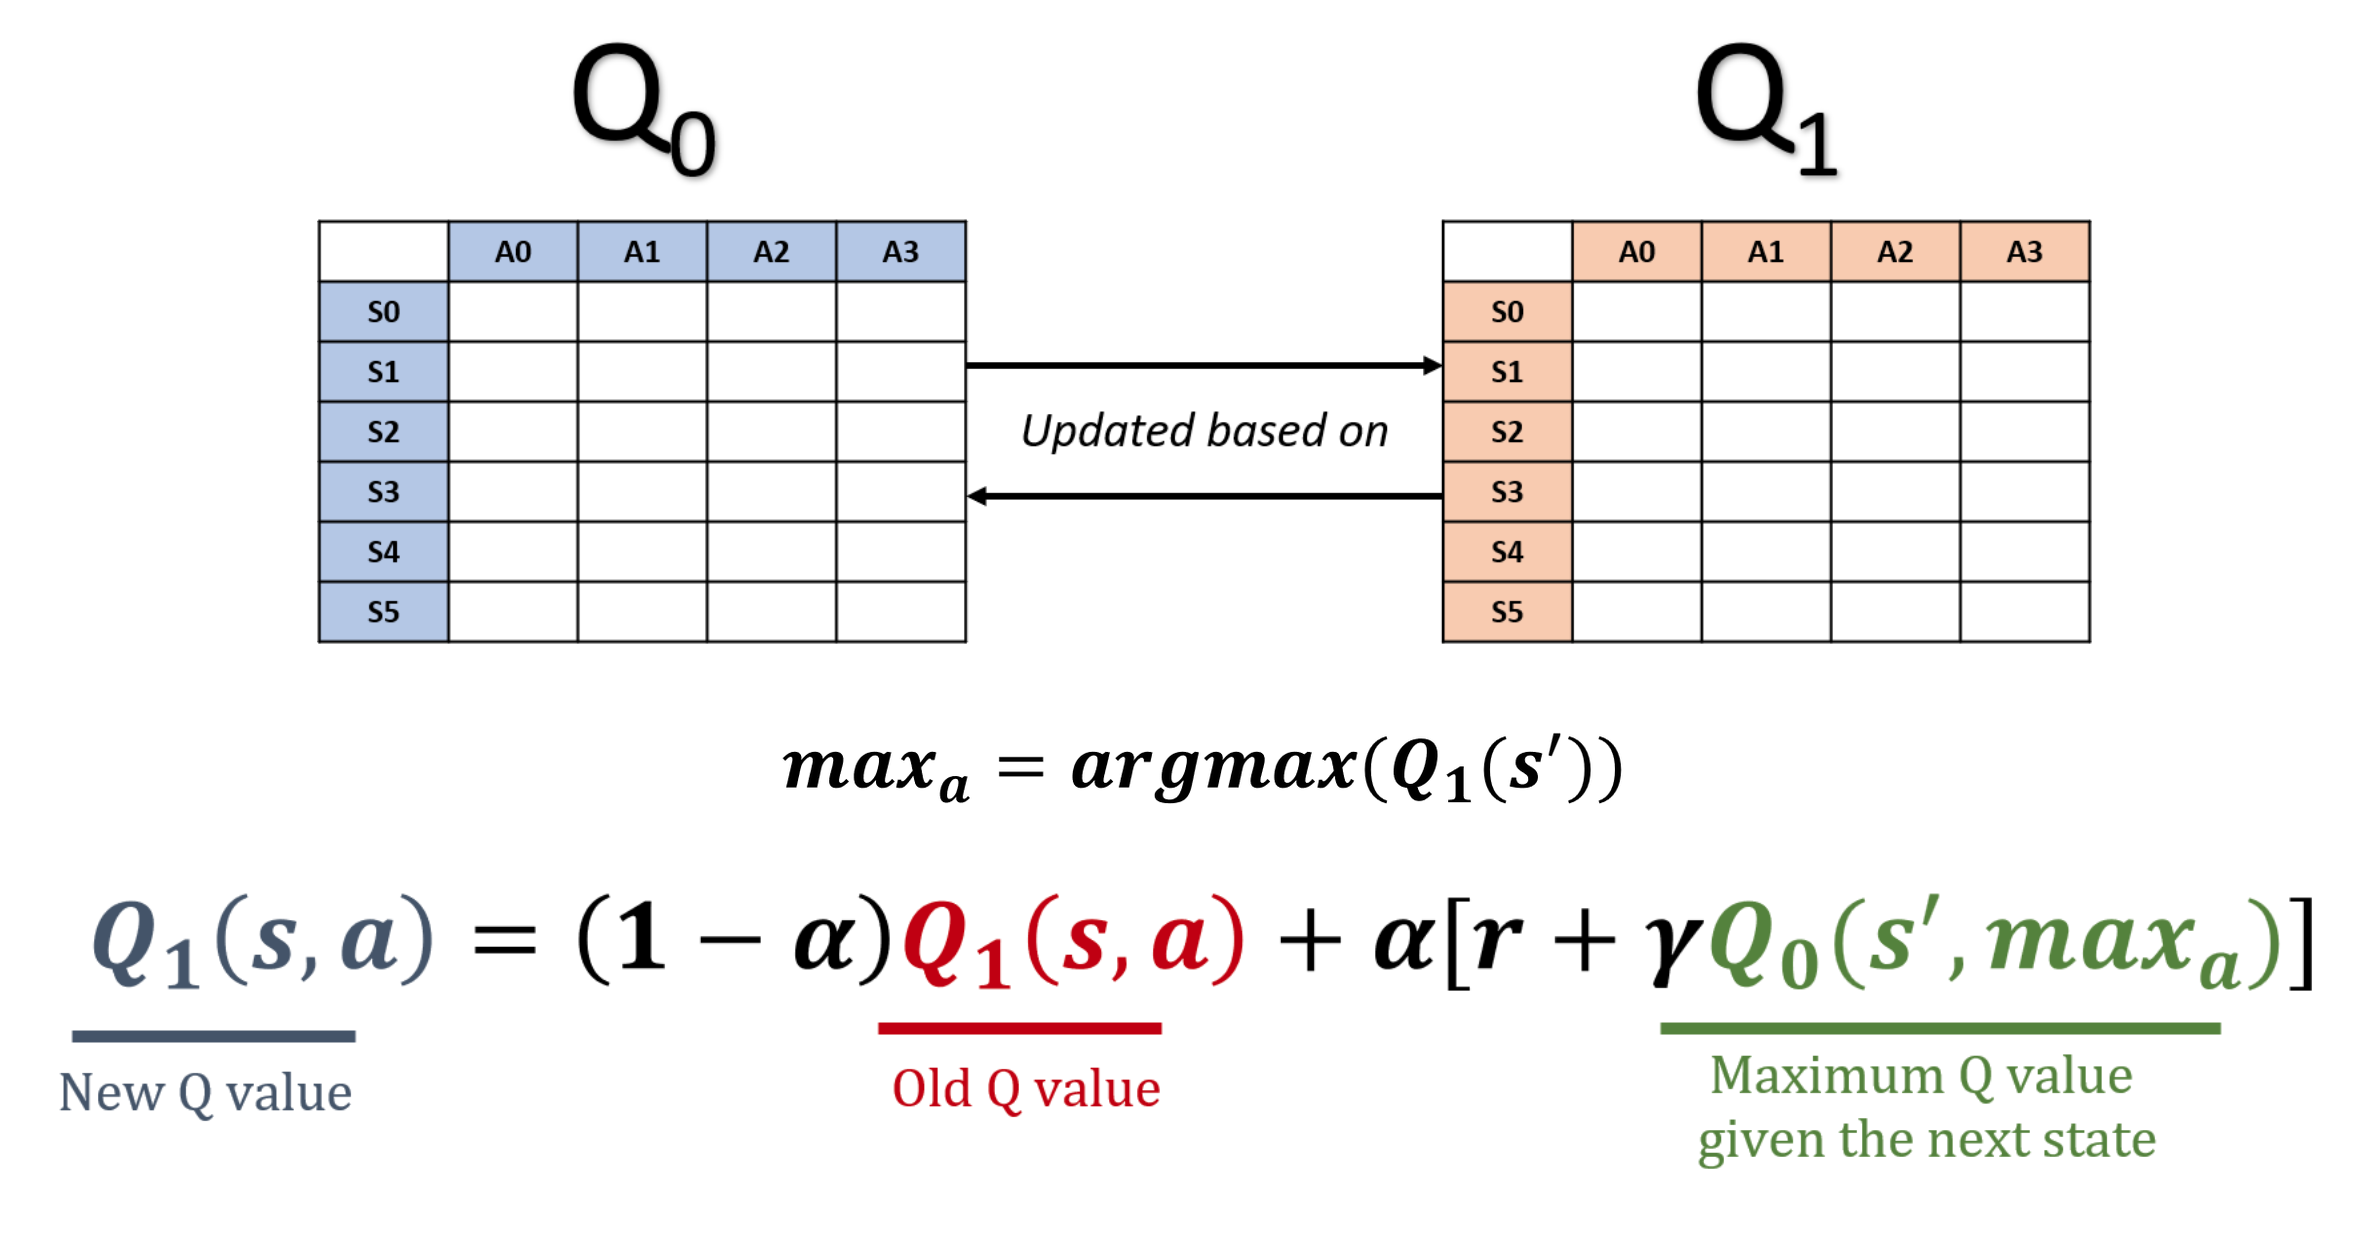
Deux tables Q (illustration du cours Reinforcement Learning with Gymnasium using Python) ; le double Q-learning les utilise en alternance

Apprentissage par renforcement profond en Python

L'idée derrière DDQN

  • Partir d'un DQN complet (avec cibles Q figées)
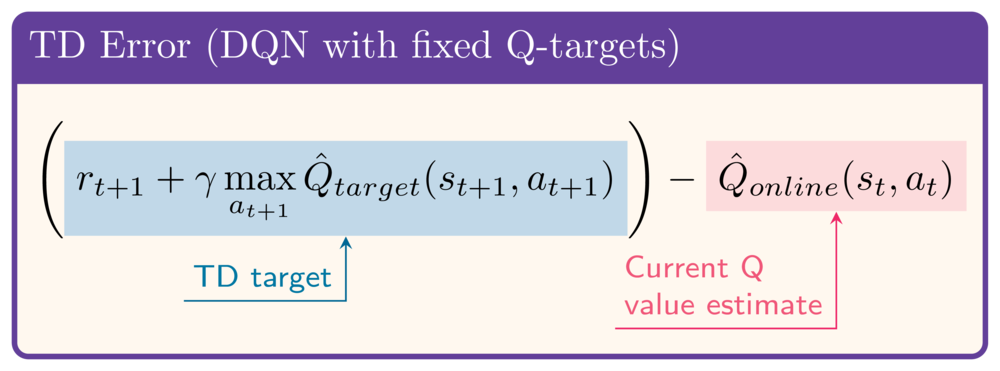
  • Dans la cible TD de DQN :
    • Sélection d'action : réseau cible
    • Estimation de valeur : réseau cible
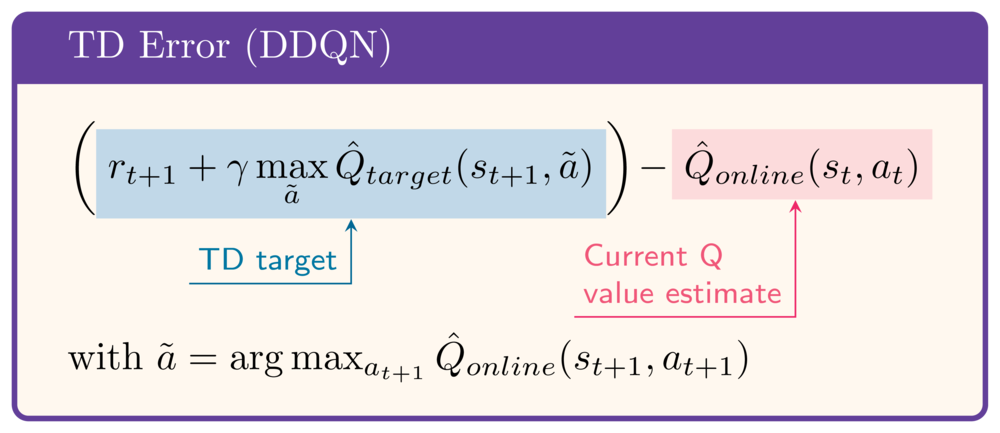
  • Dans la cible TD de DDQN :
    • Sélection d'action : réseau online
    • Estimation de valeur : réseau cible
  • Pas exactement le double Q-learning (pas d'alternance de réseaux Q)
  • L'essentiel du gain, pour un changement minimal

Erreur de Bellman (DQN avec cibles Q figées) : Q_online(s_t, a_t) - (r_t+1 + gamma max(Q_target(s_t+1, a)))

Erreur de Bellman (DDQN avec cibles Q figées) : Q_online(s_t, a_t) - (r_t+1 + gamma Q_target(s_t+1, tilde a)) avec tilde a = argmax_a(Q_online(s_t+1, a))

Apprentissage par renforcement profond en Python

Implémentation du Double DQN

DQN :

... # instantiate online and target networks
q_values = (online_network(states)
            .gather(1, actions).squeeze(1))

with torch.no_grad():
# # next_q_values = (target_network(next_states) .amax(1))
target_q_values = (rewards + gamma * next_q_values * (1 - dones))
loss = torch.nn.MSELoss()(q_values, target_q_values) ... # gradient descent ... # target network update

DDQN :

... # instantiate online and target networks
q_values = (online_network(states)
            .gather(1, actions).squeeze(1))

with torch.no_grad():

target_q_values = (rewards + gamma * next_q_values * (1 - dones))
loss = torch.nn.MSELoss()(q_values, target_q_values) ... # gradient descent ... # target network update
Apprentissage par renforcement profond en Python

Implémentation du Double DQN

DQN :

... # instantiate online and target networks
q_values = (online_network(states)
            .gather(1, actions).squeeze(1))

with torch.no_grad():
next_actions = (target_network(next_states) .argmax(1).unsqueeze(1))
next_q_values = (target_network(next_states) .gather(1, next_actions).squeeze(1))
target_q_values = (rewards + gamma * next_q_values * (1 - dones))
loss = torch.nn.MSELoss()(q_values, target_q_values) ... # gradient descent ... # target network update

DDQN :

... # instantiate online and target networks
q_values = (online_network(states)
            .gather(1, actions).squeeze(1))

with torch.no_grad():
next_actions = (online_network(next_states) .argmax(1).unsqueeze(1))
next_q_values = (target_network(next_states) .gather(1, next_actions).squeeze(1))
target_q_values = (rewards + gamma * next_q_values * (1 - dones))
loss = torch.nn.MSELoss()(q_values, target_q_values) ... # gradient descent ... # target network update
Apprentissage par renforcement profond en Python

Performances de DDQN


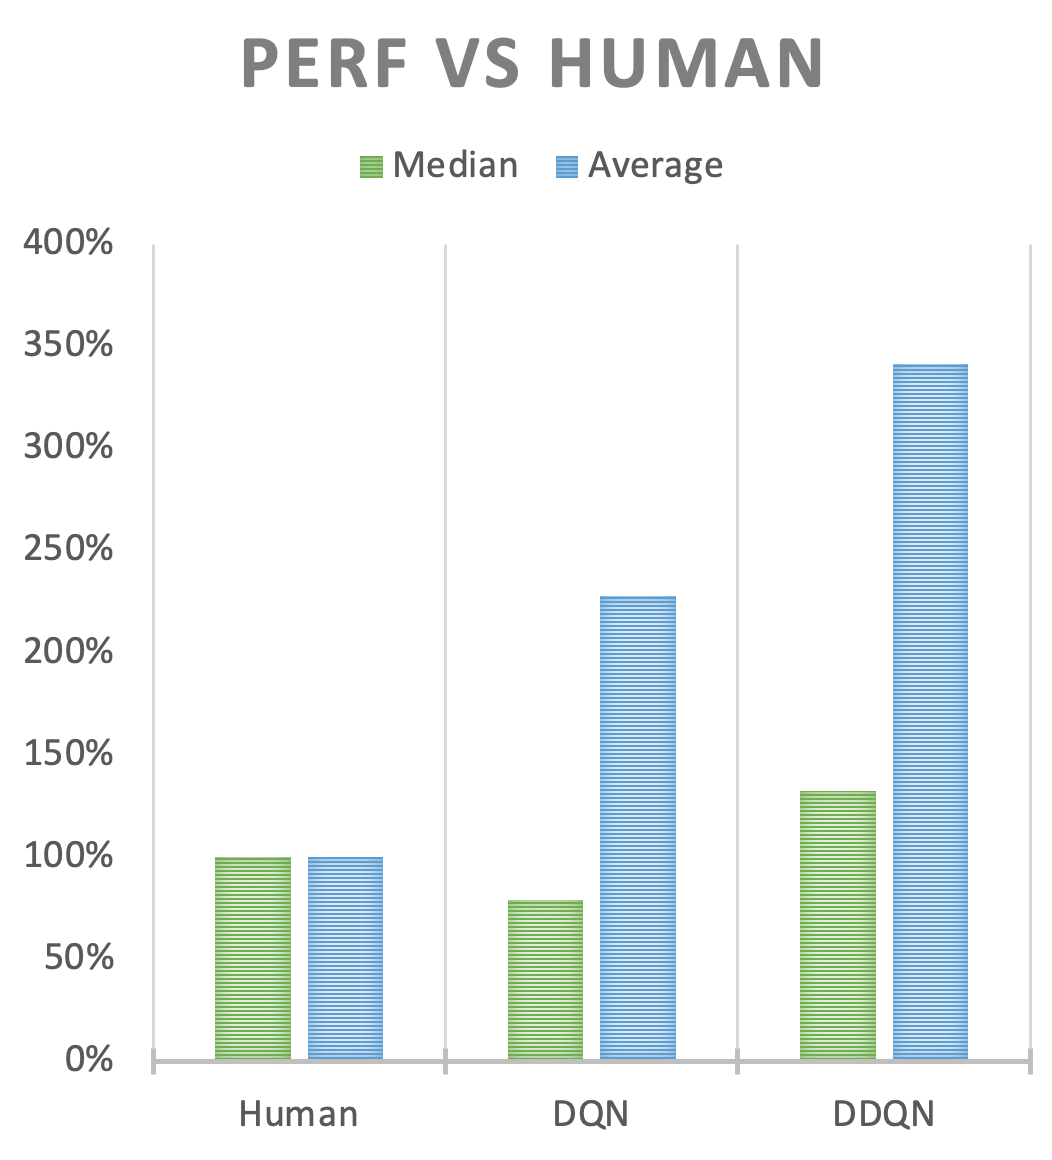
  • Comparer les performances de DDQN, DQN et joueurs humains sur les jeux Atari
  • DDQN : scores supérieurs au DQN d'origine
  • Pas toujours vrai → testez les deux

Histogramme : DQN approche le niveau humain sur le jeu médian et dépasse l'humain en moyenne ; DDQN dépasse à la fois l'humain et DQN sur le médian et la moyenne.

1 https://arxiv.org/abs/2303.11634
Apprentissage par renforcement profond en Python

Passons à la pratique !

Apprentissage par renforcement profond en Python

Preparing Video For Download...