Advantage Actor Critic

Apprentissage par renforcement profond en Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Pourquoi l'Actor-Critic ?
 

  • Limites de REINFORCE :

    • Forte variance
    • Faible efficacité d'échantillonnage
  • Les méthodes Actor-Critic ajoutent un réseau critique, permettant l'apprentissage par différence temporelle (TD)

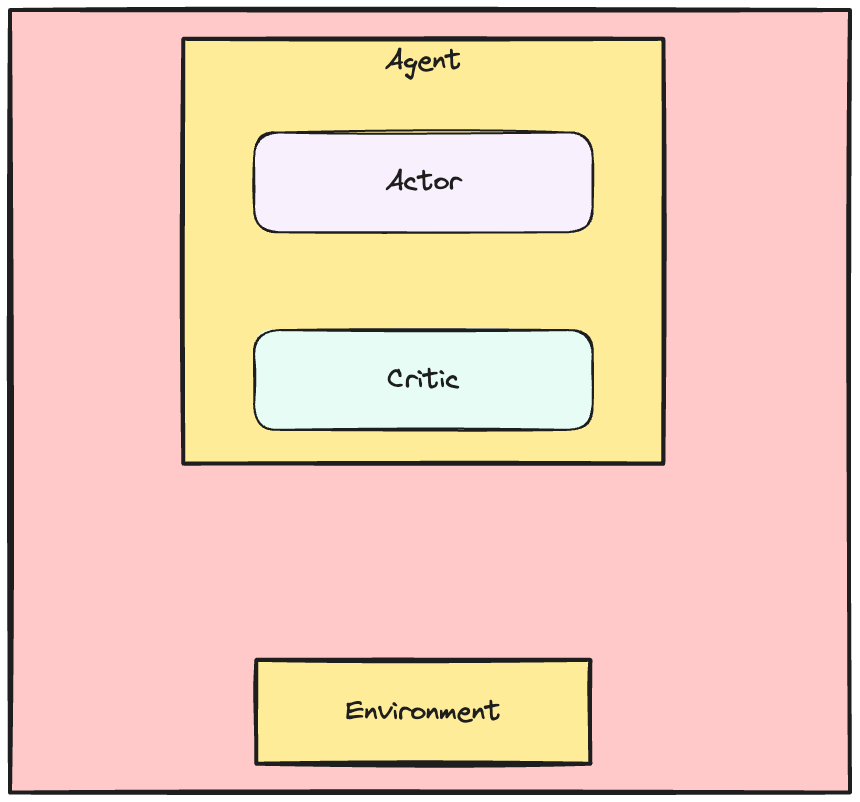
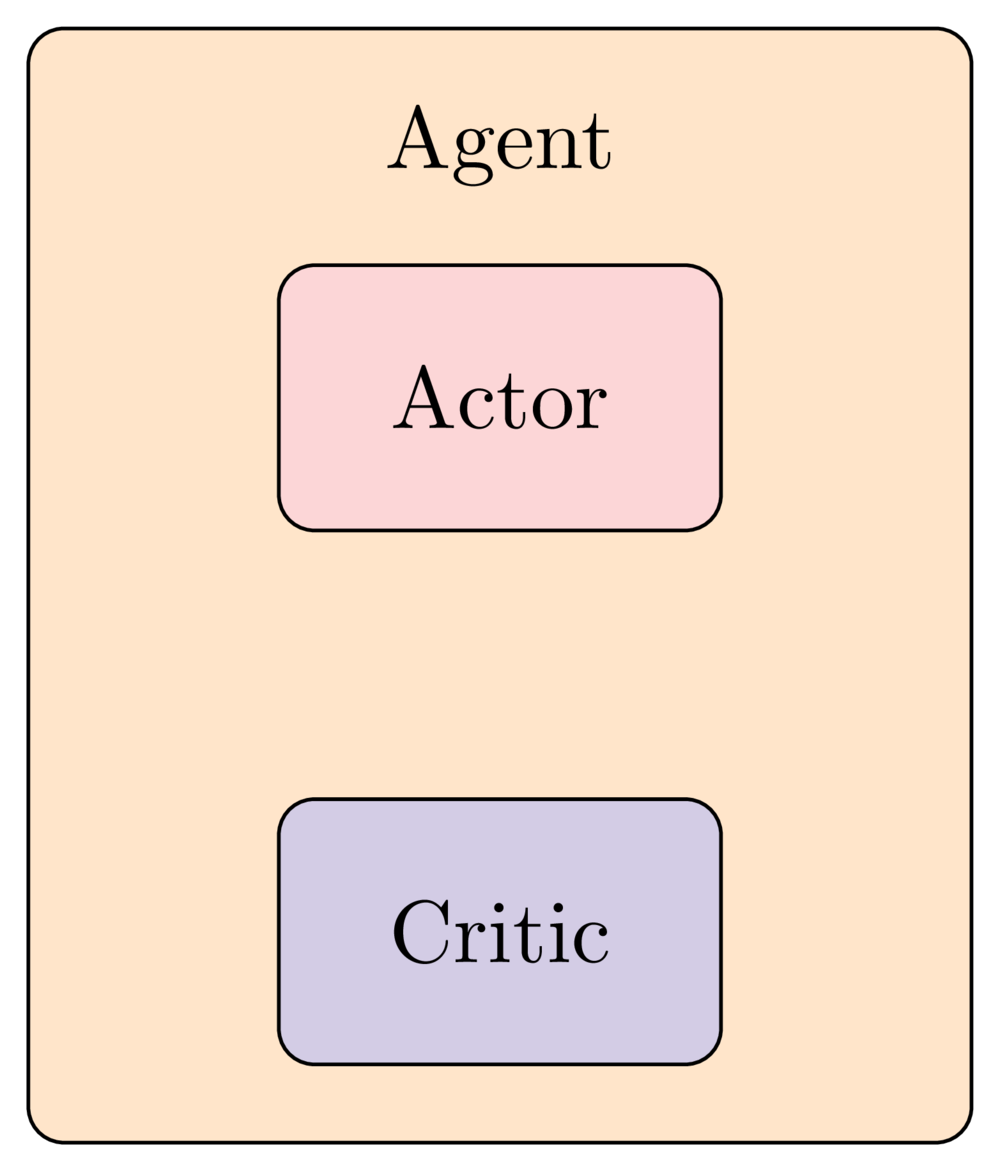
Un grand rectangle intitulé « agent » ; à l'intérieur, deux petits rectangles intitulés « actor » et « critic ».

Apprentissage par renforcement profond en Python

L'intuition derrière les méthodes Actor-Critic
Des étudiant·e·s discutent autour d'une table avec des livres et des stylos.


  • Réseau acteur :

    • Prend des décisions
    • Ne peut pas les évaluer
  • Réseau critique :

    • Donne un retour à chaque étape à l'acteur
Apprentissage par renforcement profond en Python

Le réseau Critic


  • Le critique approxime la fonction de valeur d'état
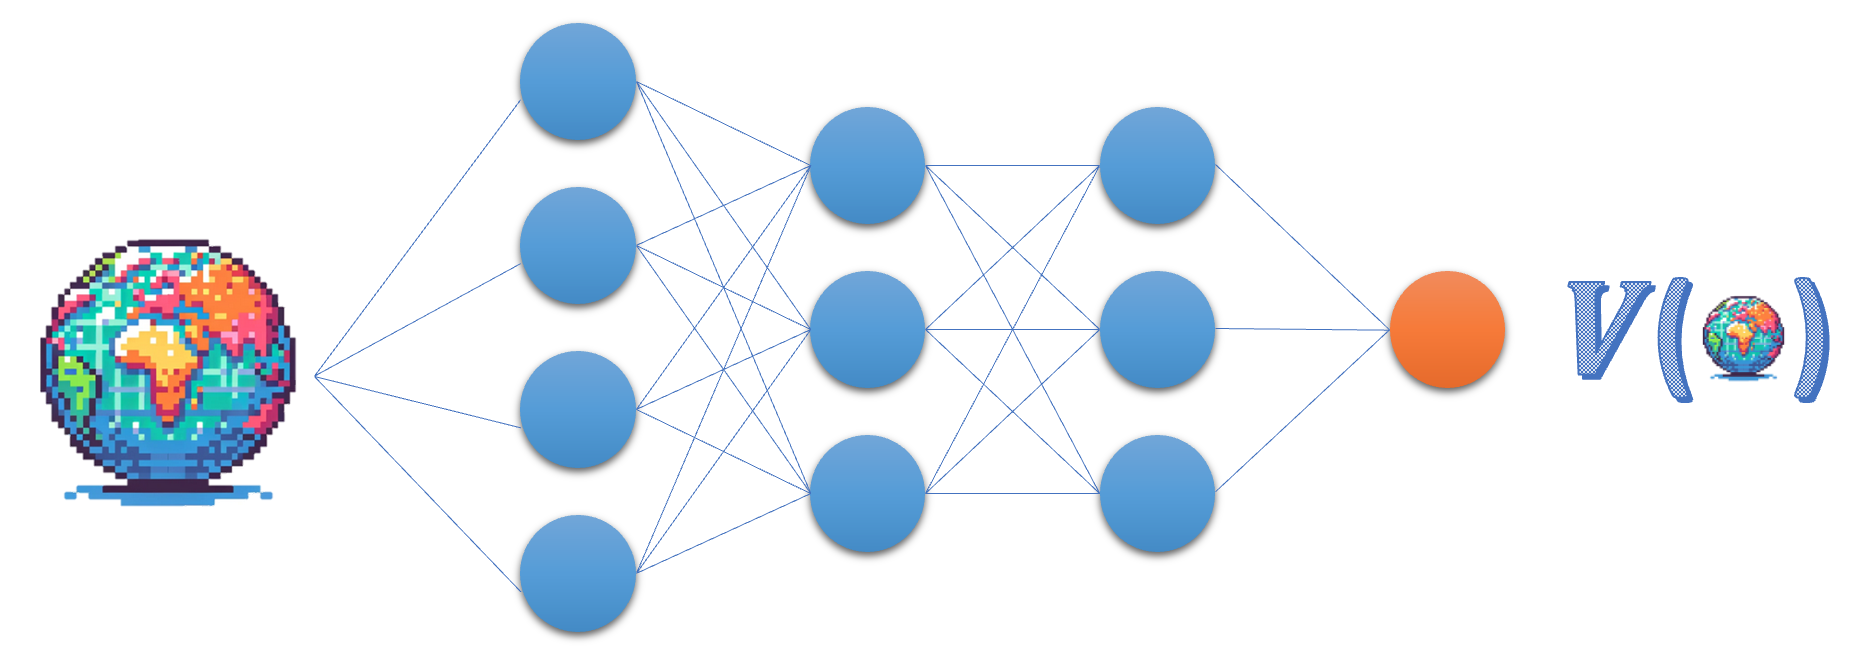
Représentation du réseau critique : l'état en entrée et la fonction de valeur en sortie ; il n'a qu'un seul nœud de sortie.

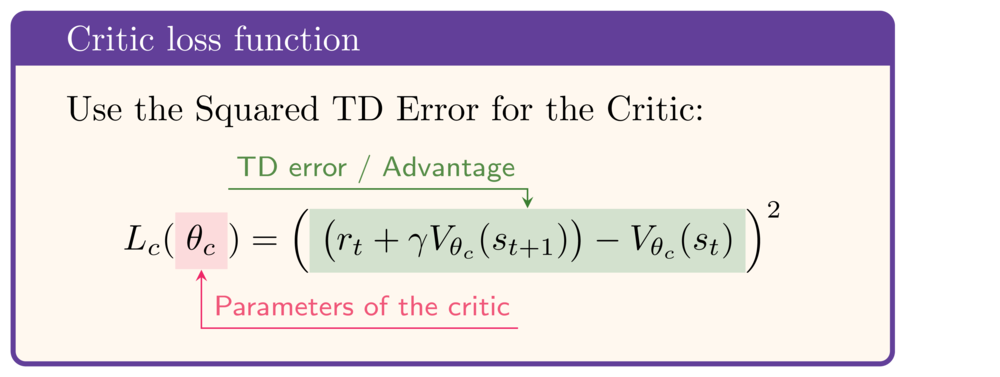
  • Juge l'action $a_t$ selon l'avantage ou l'erreur TD


class Critic(nn.Module):
    def __init__(self, state_size):
        super(Critic, self).__init__()
        self.fc1 = nn.Linear(state_size, 64)
        self.fc2 = nn.Linear(64, 1)

def forward(self, state): x = torch.relu(self.fc1(torch.tensor(state))) value = self.fc2(x) return value
critic_network = Critic(8)
Apprentissage par renforcement profond en Python

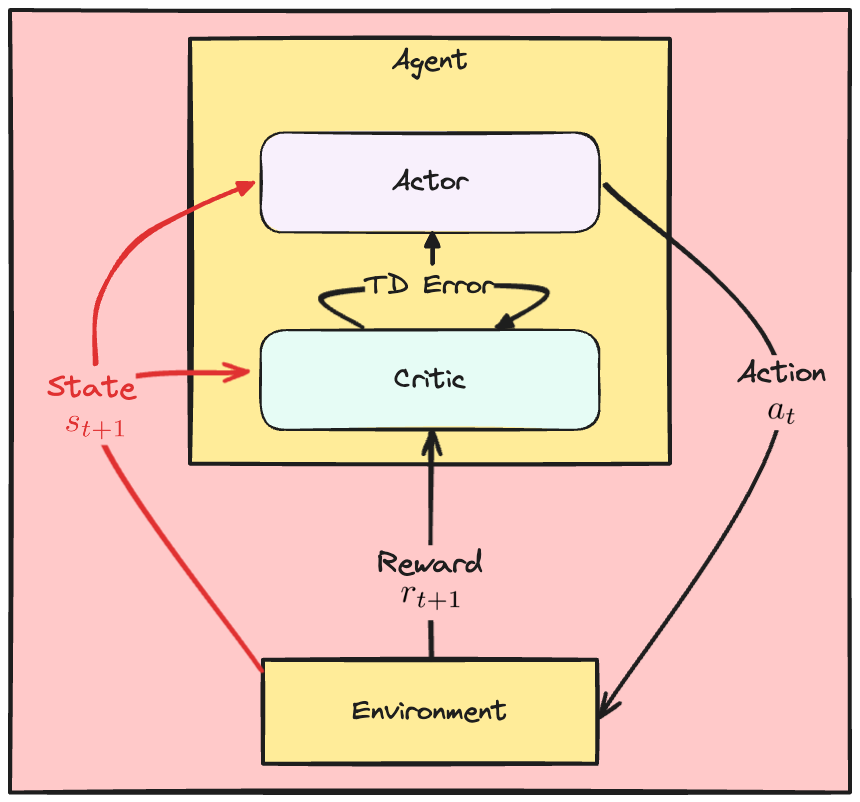
La dynamique Actor-Critic


  • À chaque étape :
    • L'acteur choisit une action (comme le réseau de politique dans REINFORCE)

En haut : un grand rectangle « agent » ; à l'intérieur, deux petits rectangles « actor » et « critic ». En bas : un rectangle séparé « environment ».

Apprentissage par renforcement profond en Python

La dynamique Actor-Critic


  • À chaque étape :
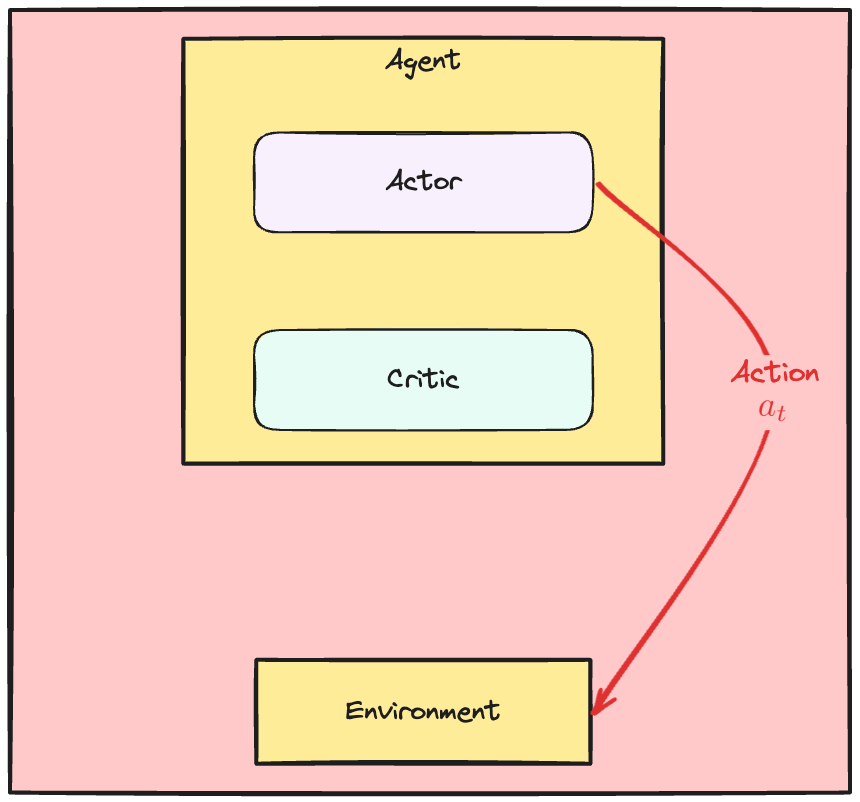
    • L'acteur choisit une action (comme le réseau de politique dans REINFORCE)
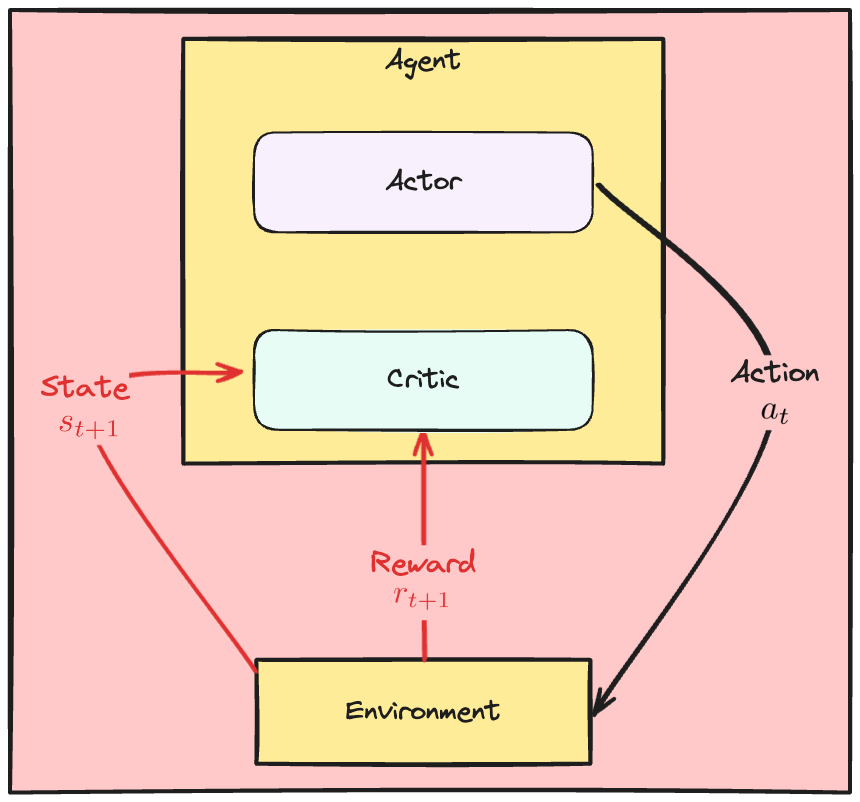
    • Le critique observe la récompense et l'état

Une flèche rouge « action » va de l'acteur vers l'environnement.

Apprentissage par renforcement profond en Python

La dynamique Actor-Critic


  • À chaque étape :
    • L'acteur choisit une action (comme le réseau de politique dans REINFORCE)
    • Le critique observe la récompense et l'état
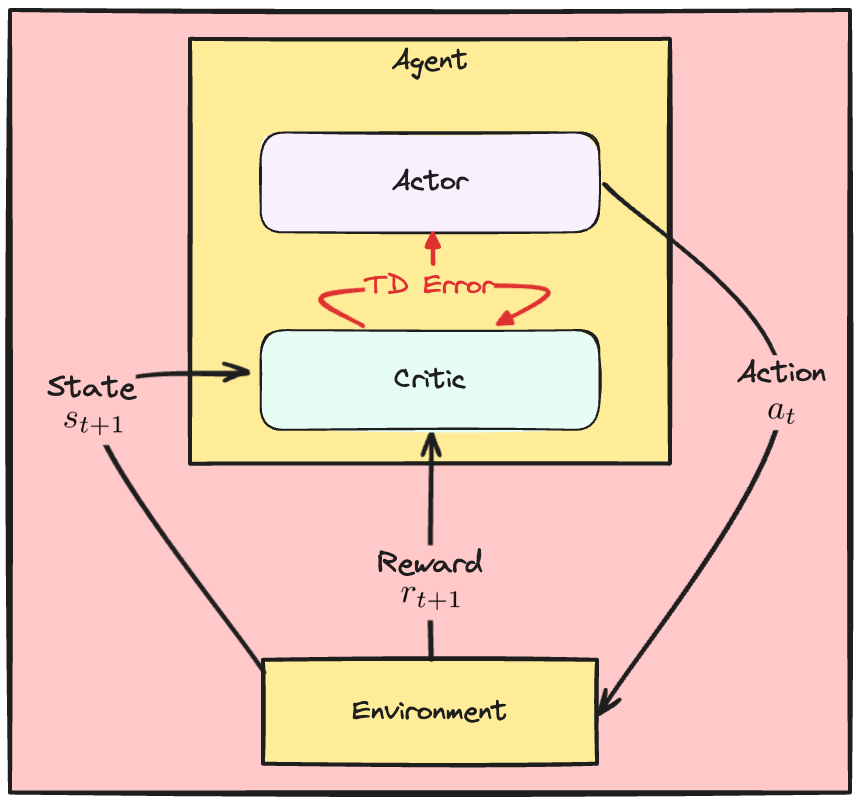
    • Le critique calcule l'erreur TD
    • L'acteur et le critique utilisent l'erreur TD pour mettre à jour les poids

Deux flèches rouges, « State » et « Reward », vont de l'environnement vers le Critic.

Apprentissage par renforcement profond en Python

La dynamique Actor-Critic


  • À chaque étape :
    • L'acteur choisit une action (comme le réseau de politique dans REINFORCE)
    • Le critique observe la récompense et l'état
    • Le critique évalue l'erreur TD
    • L'acteur et le critique utilisent l'erreur TD pour mettre à jour les poids
    • L'acteur mis à jour observe le nouvel état

Une flèche « TD error » va du Critic vers l'Actor.

Apprentissage par renforcement profond en Python

La dynamique Actor-Critic


  • À chaque étape :
    • L'acteur choisit une action (comme le réseau de politique dans REINFORCE)
    • Le critique observe la récompense et l'état
    • Le critique évalue l'erreur TD
    • L'acteur et le critique utilisent l'erreur TD pour mettre à jour les poids
    • L'acteur mis à jour observe le nouvel état
  • … puis on recommence

La flèche « State » va maintenant aussi vers l'Actor.

Apprentissage par renforcement profond en Python

Les pertes A2C


Critic

La fonction de perte du critique. Utiliser l'erreur TD au carré pour le critique : Lc(theta c) = ((r_t + gamma * V theta c (s t + 1)) - V theta c) au carré

  • Perte du critique : erreur TD au carré


Actor
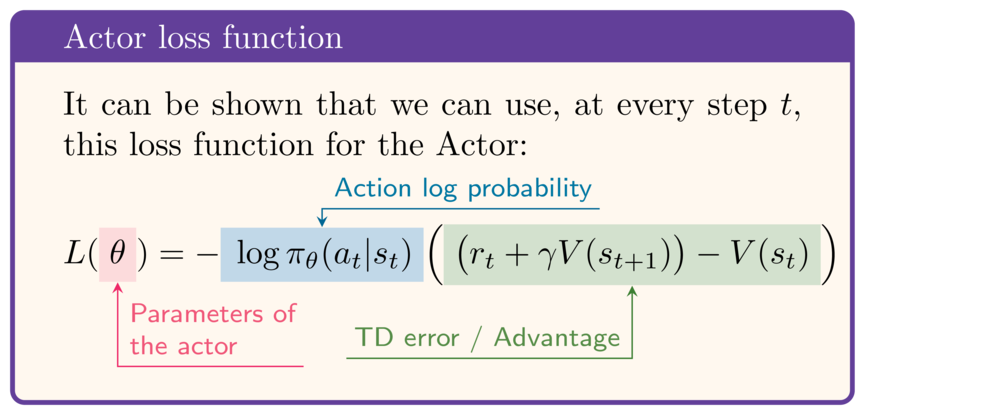
La fonction de perte de l'acteur. On peut montrer qu'à chaque pas t, on peut utiliser : L(theta) égal à moins la log-probabilité de l'action multipliée par l'erreur TD (ou l'avantage).

  • L'erreur TD reflète l'évaluation du critique
  • Augmenter la probabilité des actions à erreur TD positive
Apprentissage par renforcement profond en Python

Calcul des pertes


def calculate_losses(critic_network, action_log_prob, 
                     reward, state, next_state, done):

# Critic provides the state value estimates value = critic_network(state)
next_value = critic_network(next_state)
td_target = (reward + gamma * next_value * (1-done))
td_error = td_target - value
# Apply formulas for actor and critic losses actor_loss = -action_log_prob * td_error.detach()
critic_loss = td_error ** 2
return actor_loss, critic_loss


  • Calculer l'erreur TD
  • Calculer la perte de l'acteur
    • Utilisez .detach() pour stopper la propagation du gradient vers les poids du critique
  • Calculer la perte du critique
Apprentissage par renforcement profond en Python

Boucle d'entraînement Actor-Critic

for episode in range(10):
  state, info = env.reset()
  done = False
  while not done:

# Select action action, action_log_prob = select_action(actor, state)
next_state, reward, terminated, truncated, _ = env.step(action) done = terminated or truncated
# Calculate losses actor_loss, critic_loss = calculate_losses(critic, action_log_prob, reward, state, next_state, done)
# Update actor actor_optimizer.zero_grad(); actor_loss.backward(); actor_optimizer.step()
# Update critic critic_optimizer.zero_grad(); critic_loss.backward(); critic_optimizer.step()
state = next_state
Apprentissage par renforcement profond en Python

Passons à la pratique !

Apprentissage par renforcement profond en Python

Preparing Video For Download...