Introduction au deep reinforcement learning

Apprentissage par renforcement profond en Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Pourquoi le Deep Reinforcement Learning
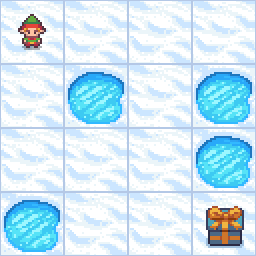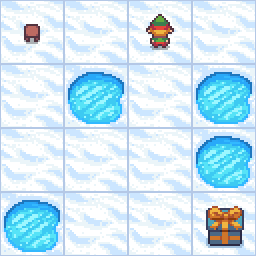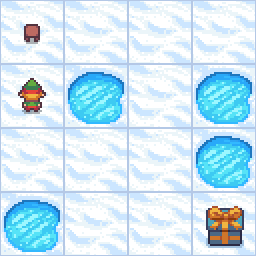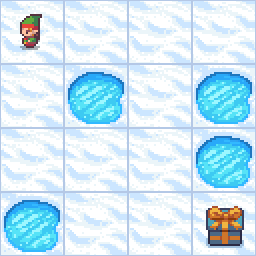
 

  • Le RL classique convient aux tâches de faible dimension


  • Beaucoup d'applications ont des états et/ou actions de haute dimension


Un agent explorant l'environnement Frozen Lake

Un agent jouant au classique Space Invaders

Apprentissage par renforcement profond en Python

Les ingrédients du DRL


  1. Concepts de Reinforcement Learning
  2. Deep Learning et PyTorch


  • Le DRL combine ces concepts avec des réseaux neuronaux profonds


Illustration en pixel art d'un cuisinier mélangeant des ingrédients

Apprentissage par renforcement profond en Python

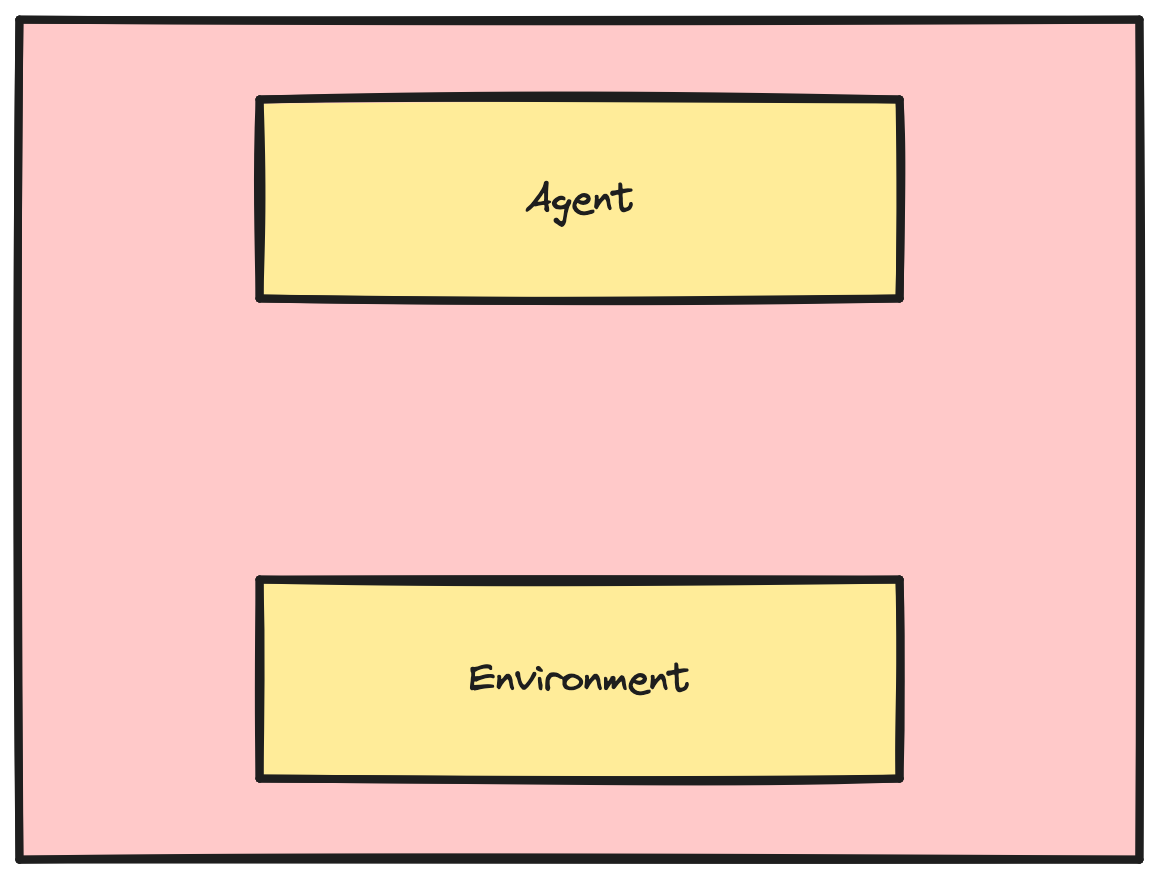
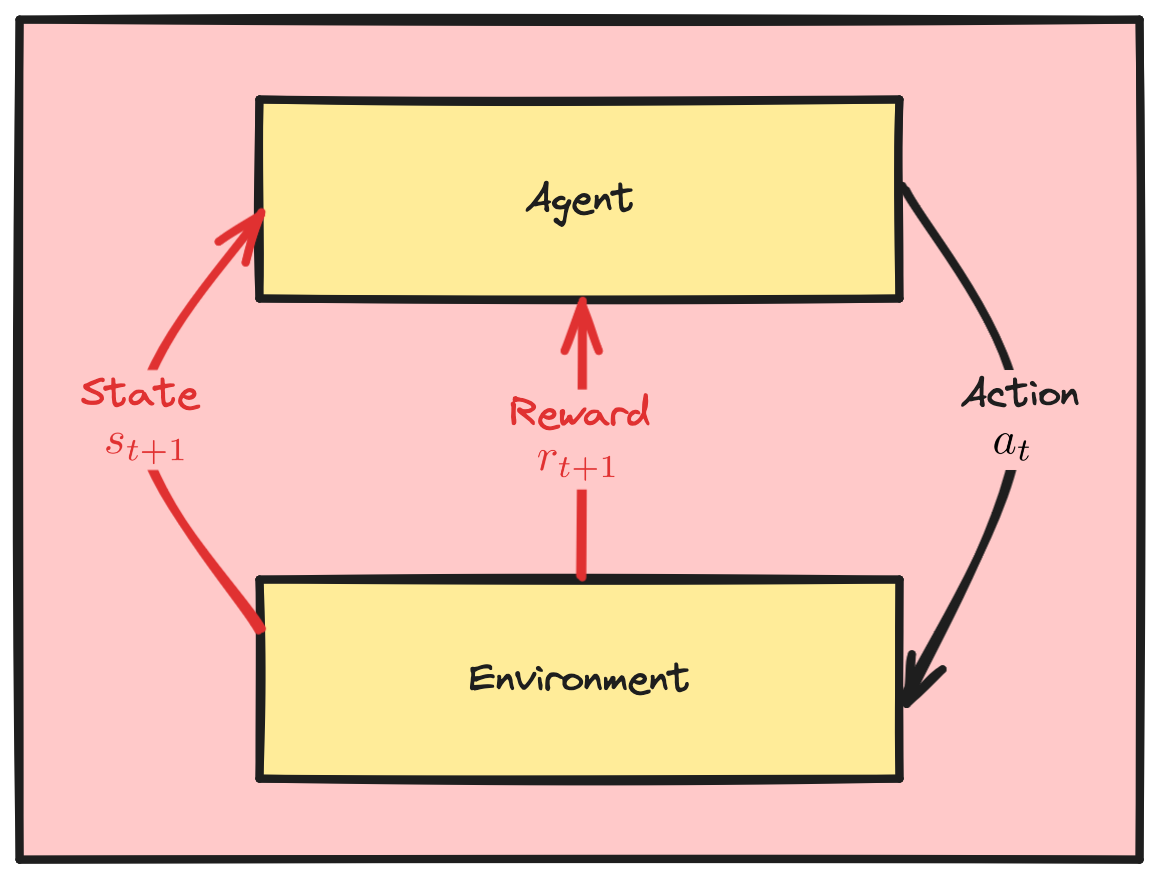
Le cadre du RL


  • Étape t :


Une grande boîte contenant deux petites boîtes « Agent » et « Environment »

Apprentissage par renforcement profond en Python

Le cadre du RL


  • Étape t :
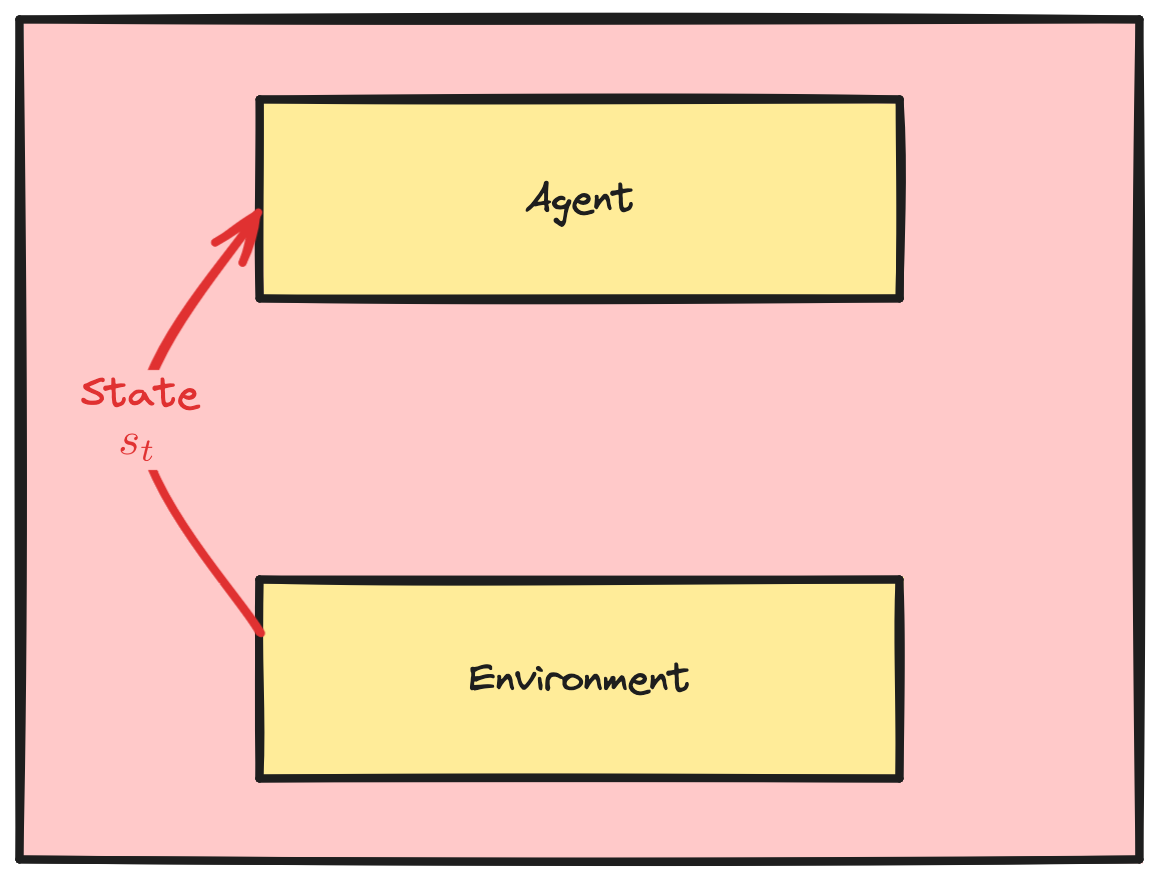
    • L'agent observe l'état $s_t$


Une flèche rouge « State s_t » va de l'environnement vers l'agent.

Apprentissage par renforcement profond en Python

Le cadre du RL


  • Étape t :
    • L'agent observe l'état $s_t$
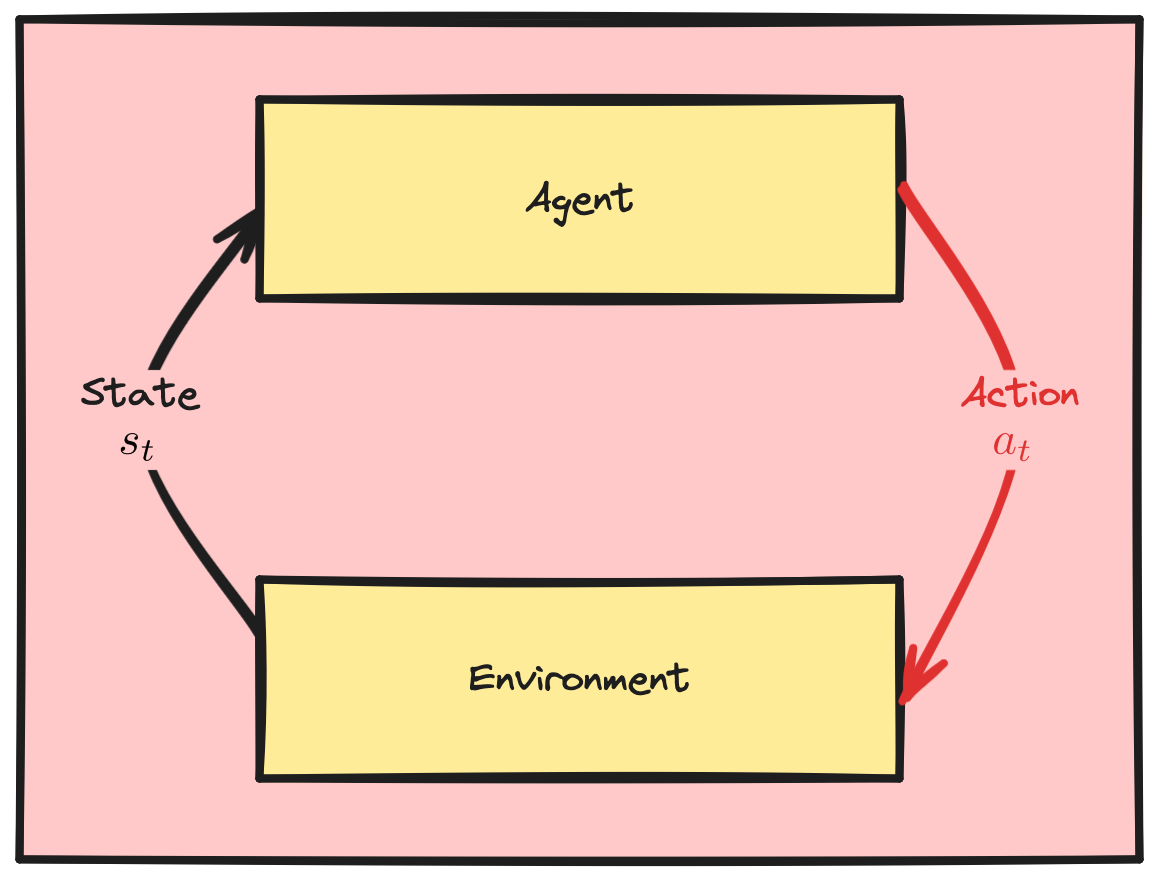
    • L'agent effectue l'action $a_t$


Une flèche rouge « action a_t » va de l'agent vers l'environnement. La flèche d'état est maintenant noire.

Apprentissage par renforcement profond en Python

Le cadre du RL


  • Étape t :
    • L'agent observe l'état $s_t$
    • L'agent effectue l'action $a_t$
  • Étape t+1 :
    • L'environnement donne la récompense $r_t$
    • L'état évolue vers $s_{t+1}$


La flèche « state s_t » devient « state s_t+1 » et redevient rouge. Une nouvelle flèche rouge « reward r_t+1 » va de l'environnement vers l'agent. La flèche d'action est noire.

Apprentissage par renforcement profond en Python

Le cadre du RL


  • Étape t :
    • L'agent observe l'état $s_t$
    • L'agent effectue l'action $a_t$
  • Étape t+1 :
    • L'environnement donne la récompense $r_t$
    • L'état évolue vers $s_{t+1}$
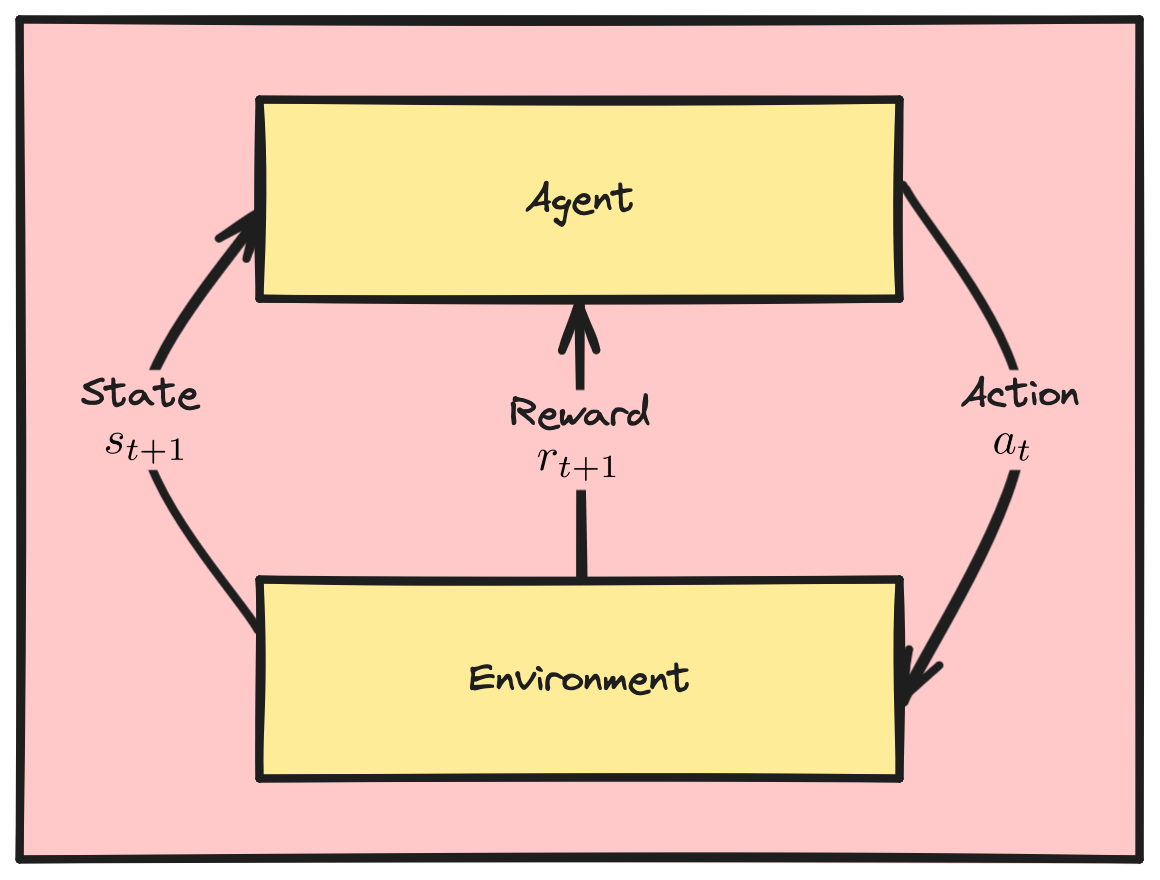
  • Répéter jusqu'à la fin de l'épisode


Même image que la diapo précédente, mais toutes les flèches sont noires.

Apprentissage par renforcement profond en Python

Politique $\pi(s_t)$


  • Application de l'état à l'action, qui décrit le comportement de l'agent dans un état donné $s_t$


  • Déterministe :
    • Retourne l'action choisie
  • Stochastique :
    • Retourne une distribution sur les actions
    • La politique est une loi de probabilité sur les actions possibles
Apprentissage par renforcement profond en Python

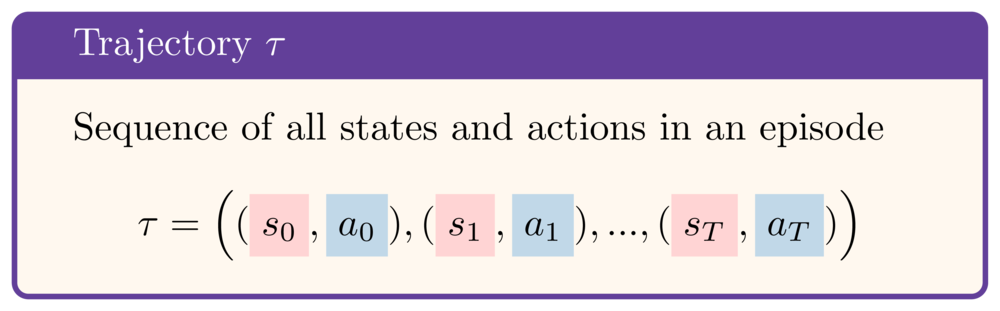
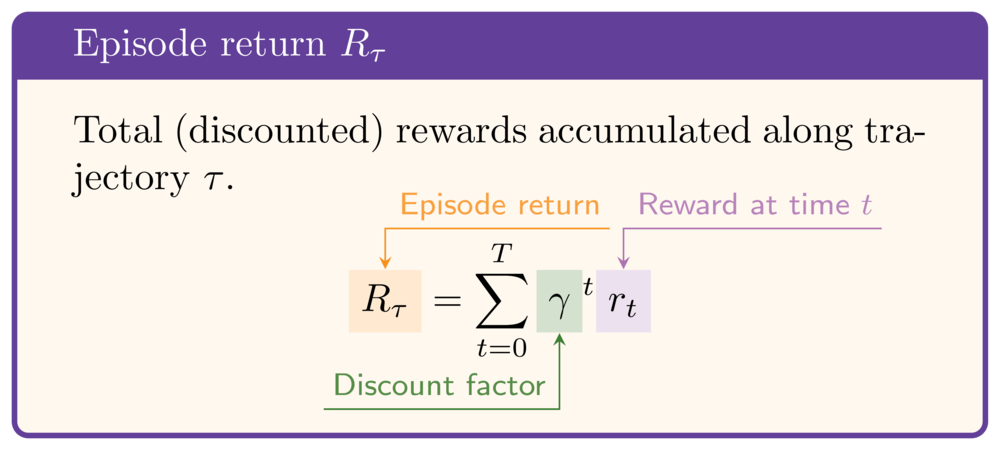
Trajectoire et retour d'épisode


Trajectoire tau : suite de tous les états et actions d'un épisode ; tau = ((s0, a0), (s1, a1), ... (sT, aT))


Retour d'épisode Rtau : total (actualisé) des récompenses accumulées le long de la trajectoire tau. Rtau = somme sur t de gamma puissance t fois r_t

Apprentissage par renforcement profond en Python

Configuration de l'environnement

env = gym.make("ALE/SpaceInvaders-v5")

# Define neural network architecture class Network(nn.Module): def __init__(self, dim_inputs, dim_outputs): super(Network, self).__init__() self.linear = nn.Linear(dim_inputs, dim_outputs) def forward(self, x): return self.linear(x)
# Instantiate network network = Network(dim_inputs, dim_outputs)
# Instantiate optimizer optimizer = optim.Adam(network.parameters(), lr=0.0001)
Apprentissage par renforcement profond en Python

La boucle de base

for episode in range(1000):
  state, info = env.reset()
  done = False

while not done:
action = select_action(network, state)
next_state, reward, terminated, truncated, _ = ( env.step(action)) done = terminated or truncated
loss = calculate_loss(network, state, action, next_state, reward, done) optimizer.zero_grad() loss.backward() optimizer.step()
state = next_state


  • Boucle externe : itérer sur les épisodes
  • Boucle interne : itérer sur les étapes
    • Sélectionner une action
    • Observer le nouvel état et la récompense
    • Calculer la perte et mettre à jour le réseau
    • Mettre à jour l'état
  • (Perte ?)
Apprentissage par renforcement profond en Python

À suivre


  • Le DRL est puissant !
  • Approches par valeur et par politique
  • DQN et améliorations
  • Méthodes de gradient de politique

Une personne apprenante DataCamp plongeant pour découvrir les secrets du Deep Reinforcement Learning

Apprentissage par renforcement profond en Python

Passons à la pratique !

Apprentissage par renforcement profond en Python

Preparing Video For Download...