Gradient de politique et REINFORCE

Apprentissage par renforcement profond en Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Différences avec DQN
  • REINFORCE : Monte-Carlo, pas Temporal Difference
    • Mise à jour en fin d'épisode, pas à chaque pas
    • Peut aussi mettre à jour après plusieurs épisodes
  • Pas de fonction de valeur
  • Pas de réseau cible
  • Pas d'epsilon-greedy
  • Pas de replay d'expérience

Images représentant : la fonction de valeur d'action Q, le replay d'expérience, l'epsilon-greedy et des cibles Q figées, empilées et barrées

Apprentissage par renforcement profond en Python

Structure de la boucle d'entraînement REINFORCE


for episode in range(num_episodes):

# 1. Initialize episode
while not done:
# 2. Select action
# 3. Play action and obtain next state and reward
# 4. Add (discounted) reward to return
# 5. Update state
# 6. Calculate loss
# 7. Update policy network by gradient descent
Apprentissage par renforcement profond en Python

Sélection d'action


from torch.distributions import Categorical

def select_action(policy_network, state):
  action_probs = policy_network(state)

action_dist = Categorical(action_probs)
action = action_dist.sample()
log_prob = action_dist.log_prob(action)
return action.item(), log_prob.reshape(1)
action, log_prob = select_action( policy_network, state)


  • Obtenir les probabilités depuis le réseau
  • Échantillonner une action
  • Renvoyer l'action et les log-probabilités correspondantes


Indice d'action échantillonnée : 1
Log-probabilité de l'action échantillonnée : -1.38
Apprentissage par renforcement profond en Python

Calcul de la perte


Rappel du théorème du gradient de politique :
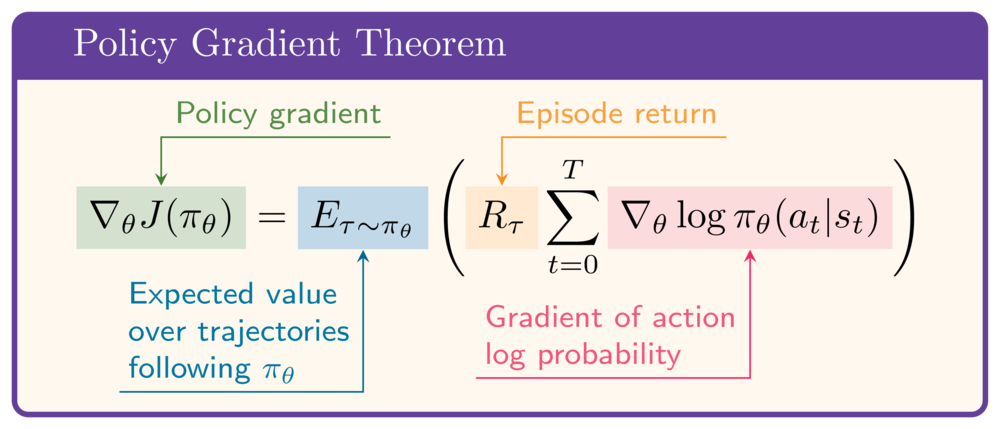
Le théorème du gradient de politique : le gradient de J(pi_theta) par rapport à theta est l'espérance, sur les trajectoires tau suivant pi_theta, du retour d'épisode multiplié par la somme des gradients des log-probabilités d'action, sommée sur toutes les actions de la trajectoire.

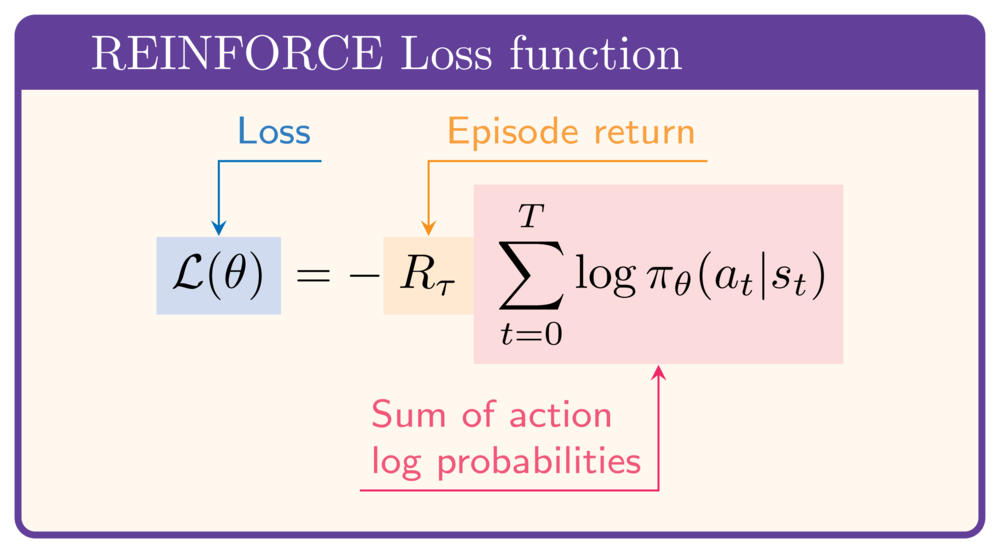
La fonction de perte REINFORCE pour un épisode : L(theta) est égale au moins le retour d'épisode multiplié par la somme des log-probabilités d'action.

En Python :

  • $R_{\tau}$ comme episode_return
  • Vecteur de $\log\pi_\theta(a_t|s_t)$ comme episode_log_probs
loss = -episode_return * episode_log_probs.sum()
Apprentissage par renforcement profond en Python

Boucle d'entraînement REINFORCE

for episode in range(50):
  state, info = env.reset(); done = False; step = 0;
  episode_log_probs = torch.tensor([])

R = 0
while not done: step += 1 action, log_prob = select_action(policy_network, state)
next_state, reward, terminated, truncated, _ = env.step(action) done = terminated or truncated
R += (gamma ** step) * reward
episode_log_probs = torch.cat((episode_log_probs, log_prob))
state = next_state
loss = - R * episode_log_probs.sum()
optimizer.zero_grad(); loss.backward(); optimizer.step()
Apprentissage par renforcement profond en Python

Passons à la pratique !

Apprentissage par renforcement profond en Python

Preparing Video For Download...