Prime d'entropie et PPO

Apprentissage par renforcement profond en Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Prime d'entropie


  • Les algorithmes de gradient de politique peuvent s'effondrer en politiques déterministes
  • Solution : ajouter une prime d'entropie
  • L'entropie mesure l'incertitude d'une distribution !

Un rover martien bloqué par un énorme rocher juste devant lui.

Apprentissage par renforcement profond en Python

Entropie d'une distribution de probabilité
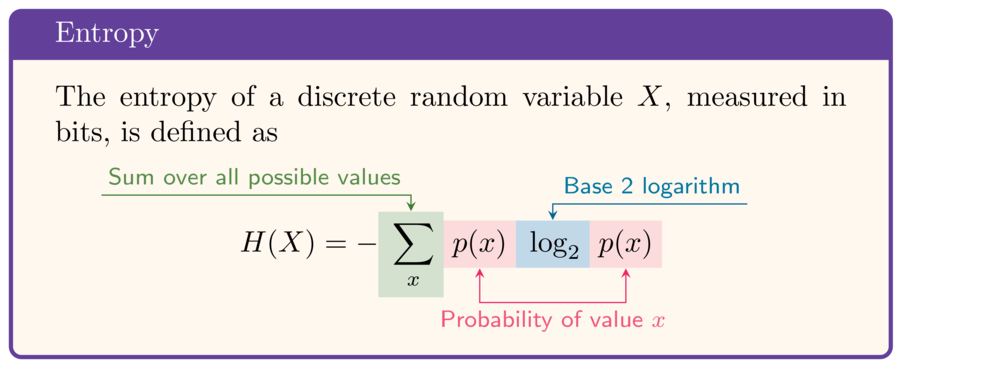
 

L'entropie d'une variable aléatoire discrète X, mesurée en bits, est définie par H(X) = - somme sur les valeurs x de p(x) log_2 p(x)

  • Avec $\ln$ au lieu de $\log_2$ : résultat en nats.
  • $1\ nat = \frac{1}{\ln 2}\ bit \approx 1{,}44\ bit$
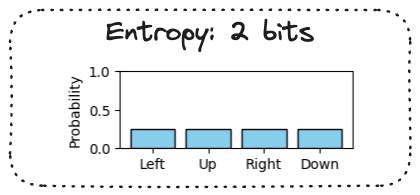
Premier de trois histogrammes montrant des politiques stochastiques sur 4 actions. Probabilité 0,25 pour chaque action ; entropie de 2 bits.

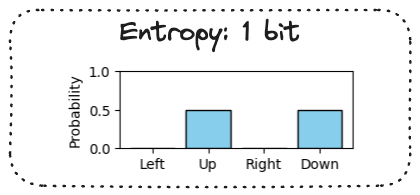
Deuxième histogramme : probabilité répartie également sur deux actions, 0 ailleurs ; entropie de 1 bit.

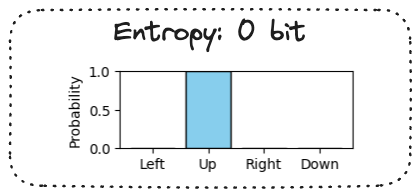
Troisième histogramme : toute la probabilité sur une seule action avec probabilité 1 ; entropie 0 bit.

Apprentissage par renforcement profond en Python

Implémenter la prime d'entropie

def select_action(policy_network, state):
  action_probs = policy_network(state)
  action_dist = Categorical(action_probs)
  action = action_dist.sample()
  log_prob = action_dist.log_prob(action)

# Obtain the entropy of the policy entropy = action_dist.entropy()
return (action.item(), log_prob.reshape(1), entropy)
  • Perte de l'acteur : actor_loss -= c_entropy * entropy
  • Remarque : Categorical.entropy() est en nats ; divisez par math.log(2) pour des bits
Apprentissage par renforcement profond en Python

Boucle d'entraînement PPO

for episode in range(10):
  state, info = env.reset()
  done = False
  while not done:
    action, action_log_prob, entropy = select_action(actor, state)
    next_state, reward, terminated, truncated, _ = env.step(action)
    done = terminated or truncated
    actor_loss, critic_loss = calculate_losses(critic, action_log_prob, action_log_prob,
                                               reward, state, next_state, done)
    actor_loss -= c_entropy * entropy
    actor_optimizer.zero_grad(); actor_loss.backward(); actor_optimizer.step()
    critic_optimizer.zero_grad(); critic_loss.backward(); critic_optimizer.step()
    state = next_state
Apprentissage par renforcement profond en Python

Vers PPO avec mises à jour par lot


  • Mettre à jour à chaque étape : on ne profite pas pleinement de l'objectif PPO
  • À chaque étape, $\theta$ coïncide en fait avec $\theta_{old}$.
  • Les implémentations complètes de PPO dissocient :
    • Mises à jour des paramètres (minibatches)
    • Mises à jour de la politique (rollouts)
Apprentissage par renforcement profond en Python

Passons à la pratique !

Apprentissage par renforcement profond en Python

Preparing Video For Download...