Introduction aux méthodes par gradient de politique

Apprentissage par renforcement profond en Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Introduction aux méthodes de politique en DRL


Q-learning :

  • Apprendre la fonction de valeur d'action Q
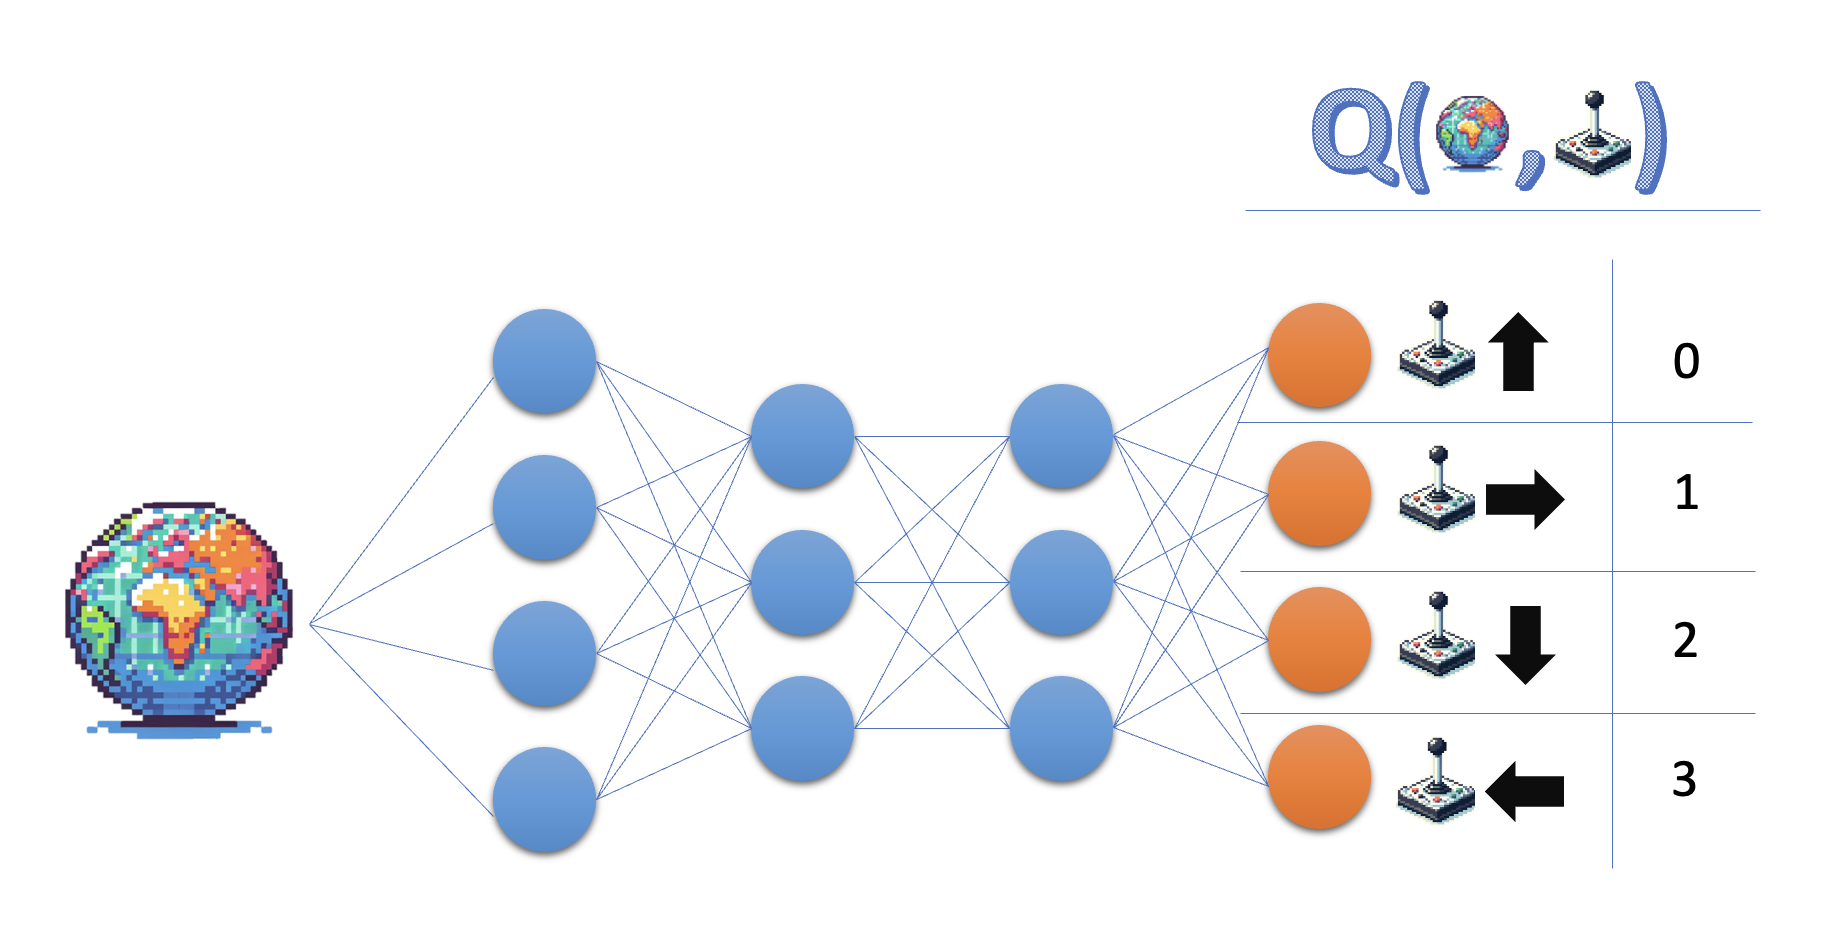
Un Q-network, avec l'état en entrée et les valeurs d'action en sortie

  • Politique : choisir l'action de valeur maximale


Apprentissage de politique :

  • Apprendre directement la politique

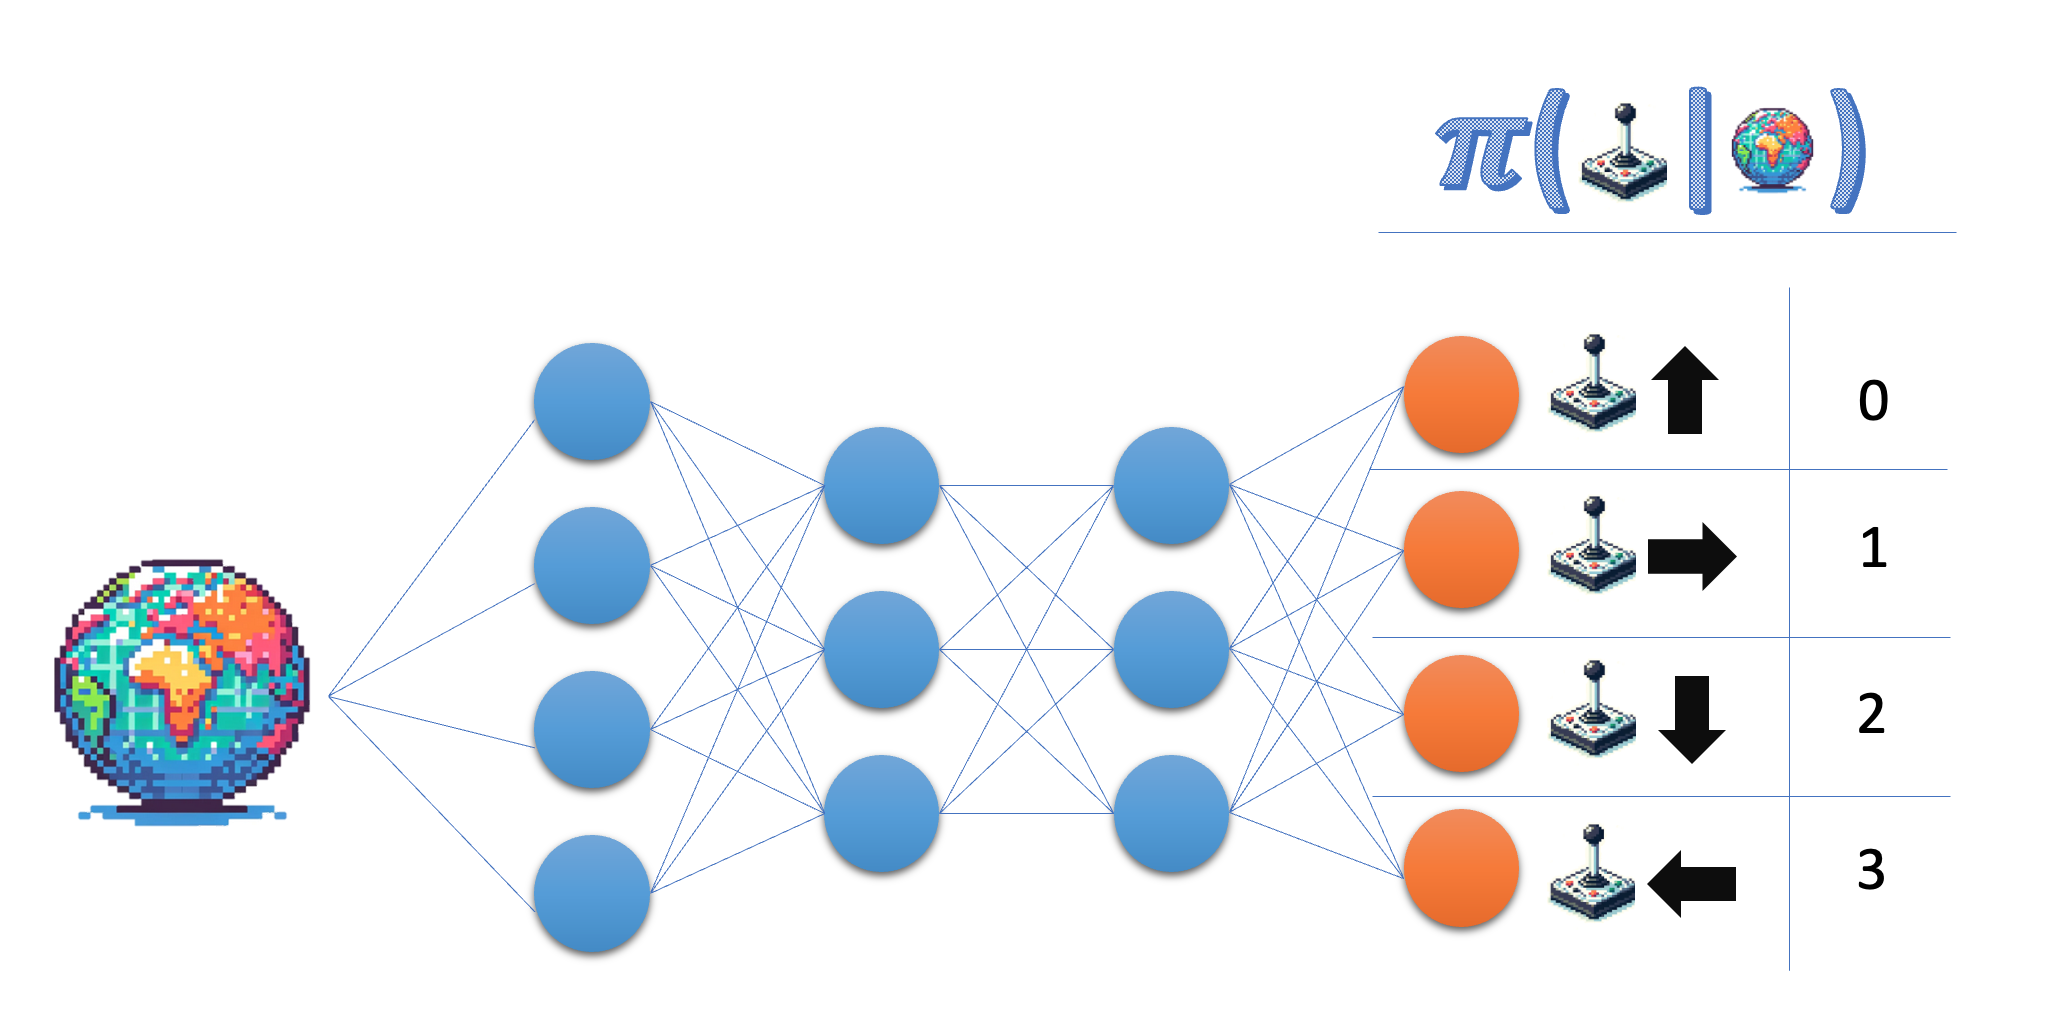
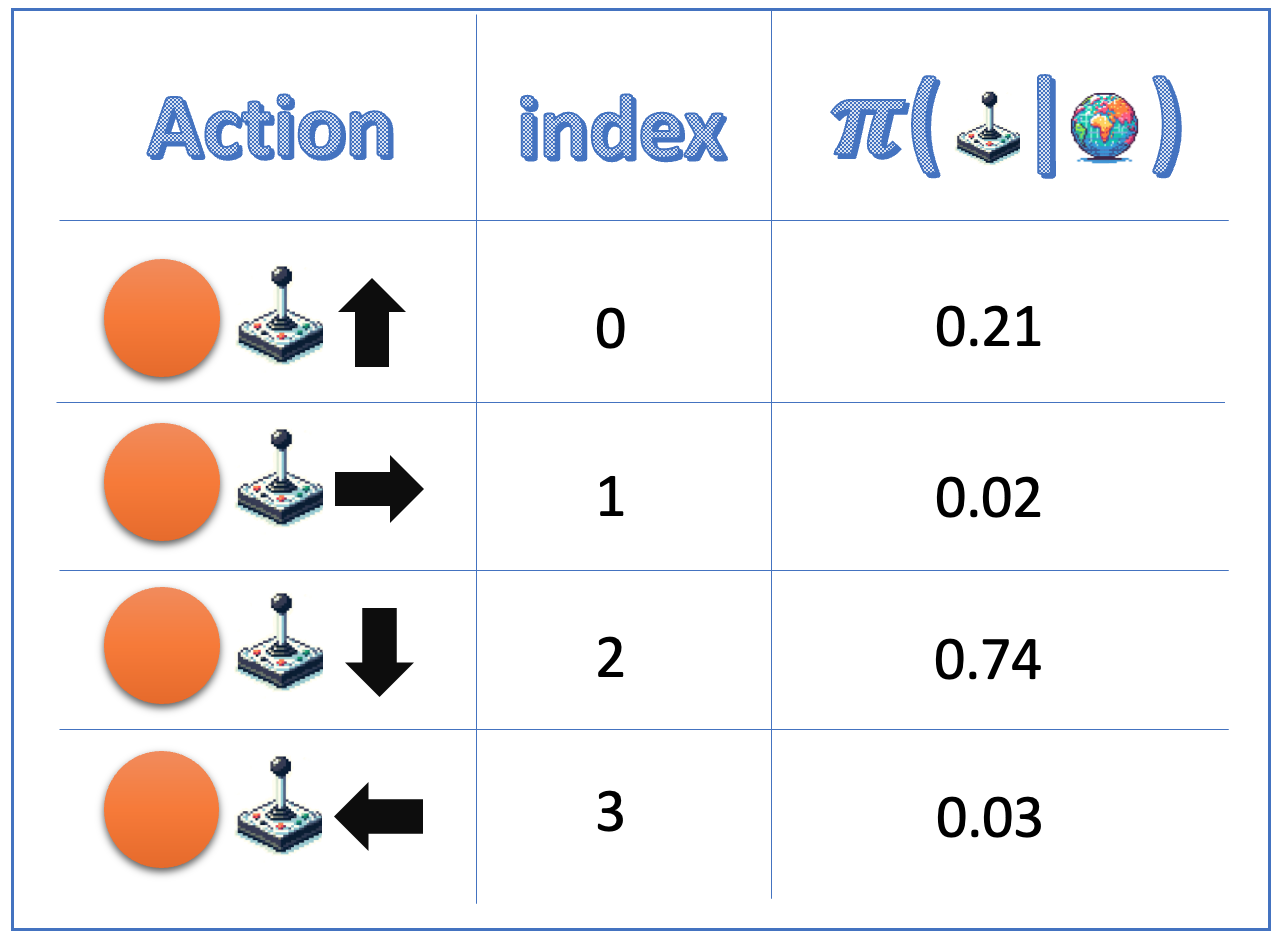
Un réseau de politique, avec l'état en entrée et les probabilités d'action en sortie

Apprentissage par renforcement profond en Python

Apprentissage de politique


  • Peut être stochastique
  • Gère des espaces continus
  • Optimise directement l'objectif
  • Forte variance
  • Moins efficace en échantillons


  • En Deep-Q learning : politiques déterministes


$\pi_\theta(a_t | s_t)$ :

  • Loi de probabilité de $a_t$ dans l'état $s_t$, avec :
    • $a_t$, $s_t$ : action et état à l'étape $t$
    • $\theta$ : paramètres de la politique (poids du réseau)
Apprentissage par renforcement profond en Python

Le réseau de politique (actions discrètes)
class PolicyNetwork(nn.Module):
  def __init__(self, state_size, action_size):
    super(PolicyNetwork, self).__init__()
    self.fc1 = nn.Linear(state_size, 64)
    self.fc2 = nn.Linear(64, 64)
    self.fc3 = nn.Linear(64, action_size)

  def forward(self, state):
    x = torch.relu(self.fc1(torch.tensor(state)))
    x = torch.relu(self.fc2(x))
    action_probs = torch.softmax(self.fc3(x), dim=-1)
    return action_probs

action_probs = policy_network(state) print('Action probabilities:', action_probs)
Action probabilities: tensor([0.21, 0.02, 0.74, 0.03])

Un tableau reliant chacune des quatre actions possibles à son indice et sa probabilité. L'action « up » a l'indice 0 et la probabilité 0,21 ; l'action « right » a l'indice 1 et la probabilité 0,02 ; l'action « down » a l'indice 2 et la probabilité 0,74 ; l'action « left » a l'indice 3 et la probabilité 0,03.

action_dist = (
    torch.distributions.Categorical(action_probs))

action = action_dist.sample()
Apprentissage par renforcement profond en Python

La fonction objectif


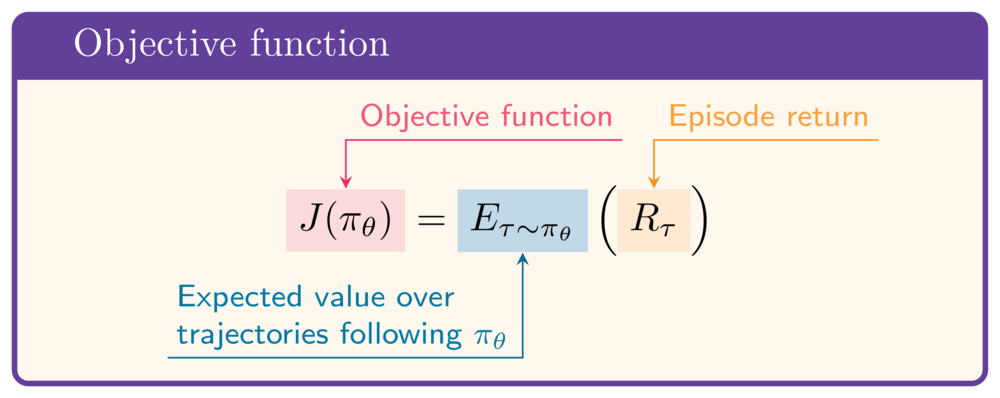
  • La politique doit maximiser le retour espéré

    • En supposant que l'agent suit $\pi_\theta$
    • En optimisant le paramètre de politique $\theta$
  • Fonction objectif :

Une équation : J(pi theta) = espérance sur les trajectoires tau suivant pi theta de R_tau, où R_tau est le retour de l'épisode


  • Pour maximiser $J$ : besoin du gradient par rapport à $\theta$ :
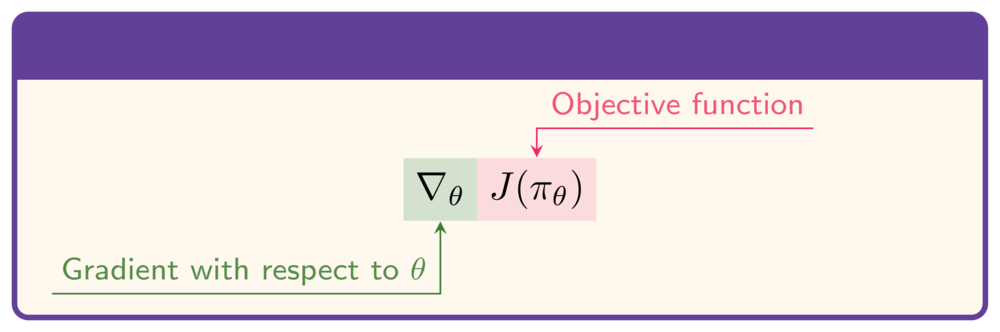
Gradient de J(pi_theta) par rapport à theta

Apprentissage par renforcement profond en Python

La fonction objectif


  • La politique doit maximiser le retour espéré

    • En supposant que l'agent suit $\pi_\theta$
    • En optimisant le paramètre de politique $\theta$
  • Fonction objectif :

La définition de J(pi theta), identique à la diapositive précédente


  • Pour maximiser $J$ : besoin du gradient par rapport à $\theta$ :
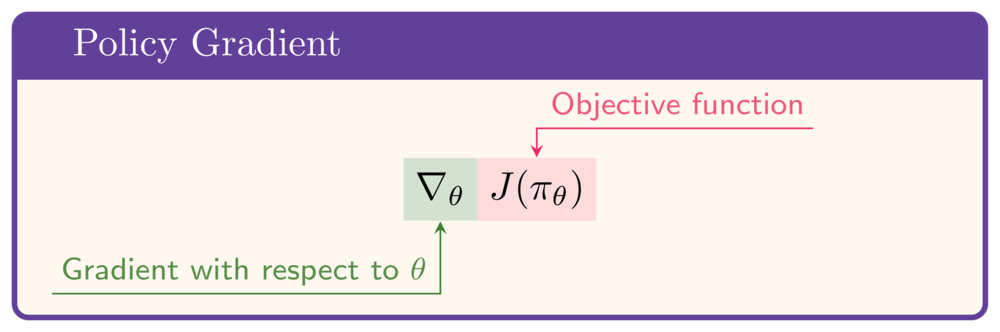
Le gradient de J(pi_theta) par rapport à theta est appelé policy gradient

Apprentissage par renforcement profond en Python

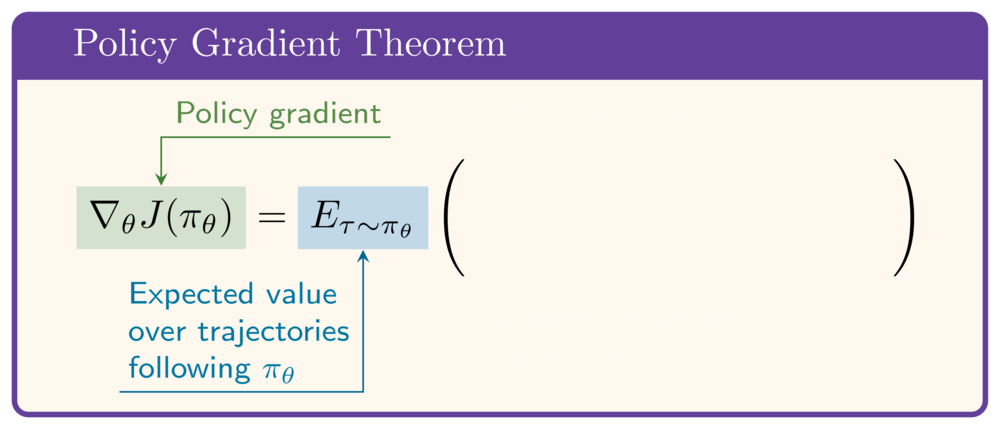
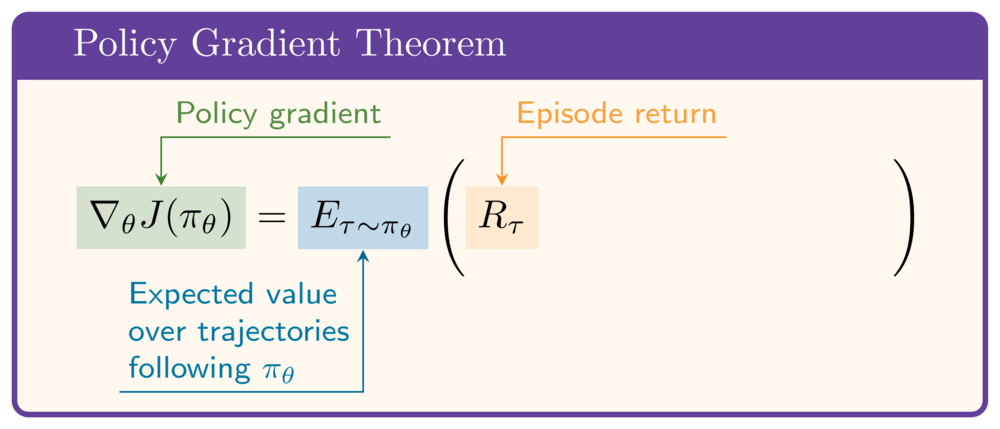
Le théorème du gradient de politique


  • Donne une expression praticable pour $\nabla_\theta J(\pi_\theta)$
  • Espérance sur des trajectoires suivant $\pi_\theta$
    • Collecter des trajectoires et observer les retours


Le théorème du gradient de politique : le gradient de J(pi_theta) par rapport à theta est l'espérance sur les trajectoires tau suivant pi_theta de...

Apprentissage par renforcement profond en Python

Le théorème du gradient de politique


  • Donne une expression praticable pour $\nabla_\theta J(\pi_\theta)$
  • Espérance sur des trajectoires suivant $\pi_\theta$
    • Collecter des trajectoires et observer les retours
  • Pour chaque trajectoire : considérer le retour $R_\tau$


Le théorème du gradient de politique : le gradient de J(pi_theta) par rapport à theta est l'espérance sur les trajectoires tau suivant pi_theta du retour d'épisode multiplié par...

Apprentissage par renforcement profond en Python

Le théorème du gradient de politique


  • Donne une expression praticable pour $\nabla_\theta J(\pi_\theta)$
  • Espérance sur des trajectoires suivant $\pi_\theta$
    • Collecter des trajectoires et observer les retours
  • Pour chaque trajectoire : considérer le retour $R_\tau$
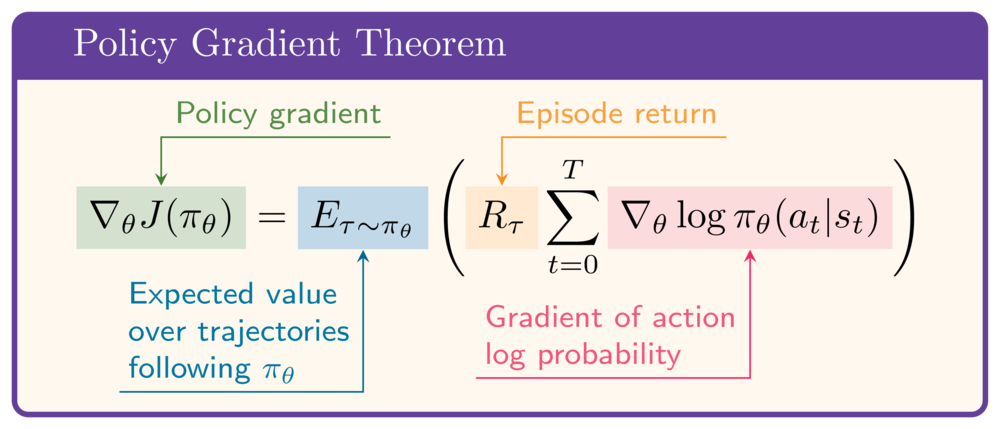
  • Multiplier par la somme des gradients des log-probabilités des actions choisies
  • Intuition : pousser $\theta$ à augmenter la probabilité de toutes les actions prises lors d'un « bon » épisode


Le théorème du gradient de politique : le gradient de J(pi_theta) par rapport à theta est l'espérance sur les trajectoires tau suivant pi_theta du retour d'épisode multiplié par la somme des gradients des log-probabilités d'action, sommée sur toutes les actions de la trajectoire.
Apprentissage par renforcement profond en Python


Un gif représentant une partie de Pong

Apprentissage par renforcement profond en Python

Passons à la pratique !

Apprentissage par renforcement profond en Python

Preparing Video For Download...