Proximal policy optimization

Apprentissage par renforcement profond en Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

A2C

  • Mises à jour de la stratégie A2C :
    • Basées sur des estimations volatiles
    • Peuvent être importantes et instables
  • Peut dégrader les performances

Un rover martien est en panne après un accident sur un terrain accidenté

PPO

  • PPO limite l'ampleur de chaque mise à jour de stratégie
  • Améliore la stabilité

Un rover martien roule sereinement à la surface de Mars

Apprentissage par renforcement profond en Python

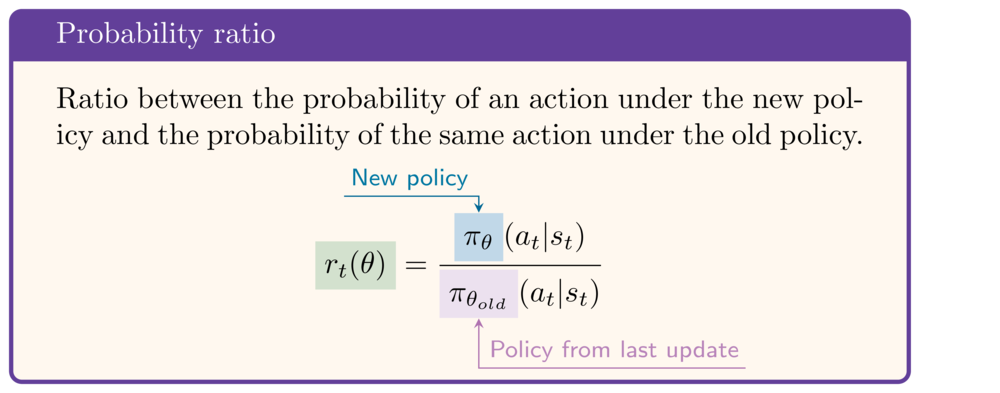
Le rapport de probabilités

  • Innovation majeure de PPO : une nouvelle fonction objectif
  • Au cœur :

Rapport de probabilités : rapport entre la probabilité d'une action sous la nouvelle stratégie et celle sous l'ancienne, noté r_t

  • L'action $a_t$ est-elle plus probable avec $\theta$ qu'avec $\theta_{old}$, et de combien ?


  ratio = action_log_prob.exp() / 
          old_action_log_prob.exp().detach()

# Or equivalently ratio = torch.exp(action_log_prob - old_action_log_prob.detach())
  • detach au dénominateur pour empêcher la propagation du gradient
Apprentissage par renforcement profond en Python

Tronquer le rapport de probabilités


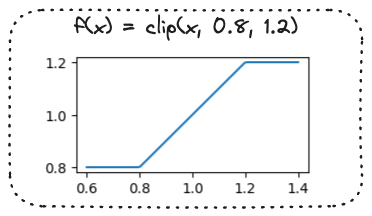
  • Fonction clip :

Un graphique de clip(x, 0.8, 1.2) entre x=0,6 et x=1,4 ; la fonction vaut 0,8 sous x=0,8 ; x entre 0,8 et 1,2 ; 1,2 au-dessus de 1,2.

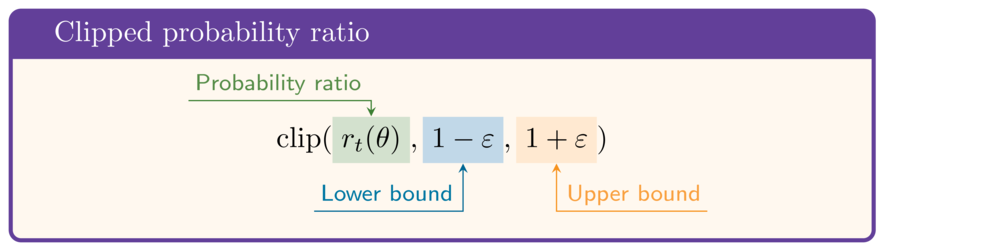
Le rapport de probabilités tronqué est clip(r_t, 1-epsilon, 1+epsilon)


clipped_ratio = torch.clamp(ratio,
                            1-epsilon, 
                            1+epsilon)
Apprentissage par renforcement profond en Python

La fonction calculate_ratios


def calculate_ratios(action_log_prob, action_log_prob_old, epsilon):

prob = action_log_prob.exp() prob_old = action_log_prob_old.exp() prob_old_detached = prob_old.detach() ratio = prob / prob_old_detached clipped_ratio = torch.clamp(ratio, 1-epsilon, 1+epsilon)
return (ratio, clipped_ratio)
Exemple avec epsilon = 0,2 :

Ratio : tensor(1.25)
Ratio tronqué : tensor(1.20)
Apprentissage par renforcement profond en Python

La fonction objectif de PPO


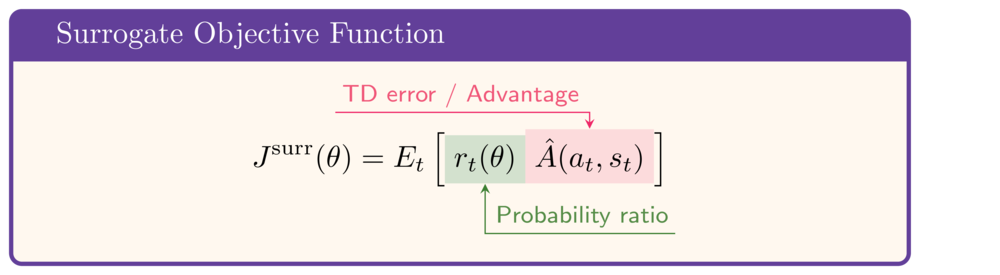
J surr = E_t(r_t * advantage)

surr1 = ratio * td_error.detach()

surr2 = clipped_ratio * td_error.detach()
objective = torch.min(surr1, surr2)


  • Surrogate avec ratio tronqué :

$$\mathrm{clip}(r_t(\theta),1-\varepsilon,1+\varepsilon)\hat{A}$$

  • Fonction objectif « clipped surrogate » de PPO :
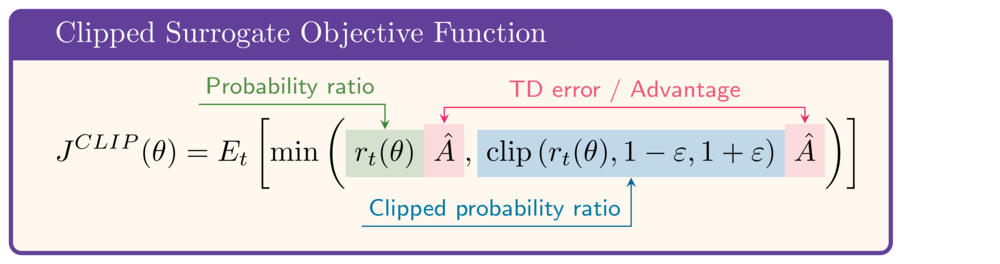
Fonction objectif « clipped surrogate » : espérance du minimum entre ratio * avantage et ratio tronqué * avantage.

  • Plus stable qu'A2C
Apprentissage par renforcement profond en Python

Calcul des pertes PPO


def calculate_losses(critic_network, 
                     action_log_prob,                                        
                     action_log_prob_old,
                     reward, state, next_state,
                     done
                     ):

    # calculate TD error (same as A2C)
    value = critic_network(state)
    next_value = critic_network(next_state)
    td_target = (reward + 
                 gamma * next_value * (1-done))
    td_error = td_target - value
    ...


    ...
    ratio, clipped_ratio = 
            calculate_ratios(action_log_prob, 
                             action_log_prob_old,
                             epsilon)

surr1 = ratio * td_error.detach()
surr2 = clipped_ratio * td_error.detach()
objective = torch.min(surr1, surr2)
actor_loss = -objective
critic_loss = td_error ** 2 return actor_loss, critic_loss
Apprentissage par renforcement profond en Python

Passons à la pratique !

Apprentissage par renforcement profond en Python

Preparing Video For Download...