Relecture d'expériences priorisée

Apprentissage par renforcement profond en Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Toutes les expériences ne se valent pas


  • Experience Replay :
    • L'échantillonnage uniforme peut ignorer des expériences clés
  • Prioritized Experience Replay :
    • Attribuer une priorité à chaque expérience, basée sur les erreurs TD
    • Se concentrer sur les expériences à fort potentiel d'apprentissage


Des étudiant·e·s révisent à la bibliothèque

Apprentissage par renforcement profond en Python

Prioritized Experience Replay (PER)


for step = 1 to T do:
    # Exécuter l'action optimale selon la fonction de valeur
    # Observer l'état suivant et la récompense
    # Ajouter la transition au tampon de relecture

# Lui donner la priorité la plus élevée (1)
# Échantillonner un lot de transitions passées
# Selon la priorité (2)
# Calculer les erreurs TD pour le lot
# Calculer la perte et mettre à jour le réseau Q
# Utiliser des poids d'échantillonnage par importance (4)
# Mettre à jour la priorité des transitions échantillonnées (3)
# Augmenter l'échantillonnage par importance au fil du temps. (5)

(1) Les nouvelles transitions sont ajoutées avec la priorité maximale $p_i = \max_k(p_k)$

(2) Échantillonner la transition $i$ avec la probabilité $$P(i) = p_i^{\alpha} / \sum_k p_k^{\alpha}\ \ \ \ \ \ \ \ (0<\alpha<1)$$

(3) Les transitions échantillonnées voient leur priorité mise à jour avec leur erreur TD : $p_i = |\delta_i| + \varepsilon$

(4) Utiliser des poids d'échantillonnage par importance $$w_i = \left( \frac{1}{N} \cdot \frac{1}{P(i)} \right)^\beta\ \ \ \ \ \ \ \ (0<\beta<1)$$

(5) Augmenter progressivement $\beta$ vers 1

Apprentissage par renforcement profond en Python

Implémenter PER

def __init__(self, capacity, alpha=0.6, beta=0.4, beta_increment=0.001, epsilon=0.001):
    # Initialiser le tampon mémoire
    self.memory = deque(maxlen=capacity)

# Stocker les paramètres et initialiser les priorités self.alpha, self.beta, self.beta_increment, self.epsilon = (alpha, beta, beta_increment, epsilon) self.priorities = deque(maxlen=capacity)
...
Apprentissage par renforcement profond en Python

Implémenter PER

...

def push(self, state, action, reward, next_state, done):
    # Ajouter l'expérience au tampon
    experience_tuple = (state, action, reward, next_state, done)
    self.memory.append(experience_tuple)

# Définir la priorité de la nouvelle transition au maximum max_priority = max(self.priorities) if self.memory else 1.0 self.priorities.append(max_priority)
...
Apprentissage par renforcement profond en Python

Implémenter PER

def sample(self, batch_size):
    priorities = np.array(self.priorities)
    # Calculer les probabilités d'échantillonnage
    probabilities = priorities**self.alpha / np.sum(priorities**self.alpha)

# Sélectionner aléatoirement les indices échantillonnés indices = np.random.choice(len(self.memory), batch_size, p=probabilities)
# Calculer les poids weights = (1 / (len(self.memory) * probabilities)) ** self.beta weights /= np.max(weights) states, actions, rewards, next_states, dones = zip(*[self.memory[idx] for idx in indices]) weights = [weights[idx] for idx in indices] states, actions, rewards, next_states, dones = (zip(*[self.memory[idx] for idx in indices]))
# Retourner des tenseurs states = torch.tensor(states, dtype=torch.float32) ... # À répéter pour rewards, next_states, dones, weights actions = torch.tensor(actions, dtype=torch.long).unsqueeze(1) return (states, actions, rewards, next_states, dones, indices, weights)
Apprentissage par renforcement profond en Python

Implémenter PER

...

def update_priorities(self, indices, td_errors: torch.Tensor):
    # Mettre à jour les priorités des transitions échantillonnées
    for idx, td_error in zip(indices, td_errors.abs()):
        self.priorities[idx] = abs(td_error.item()) + self.epsilon

def increase_beta(self): # Incrémenter beta vers 1 self.beta = min(1.0, self.beta + self.beta_increment)
Apprentissage par renforcement profond en Python

PER dans la boucle d'entraînement DQN


  1. Dans le pré-boucle :

    buffer = PrioritizedReplayBuffer(capacity)
    
  2. Au début de chaque épisode :

    buffer.increase_beta()
    

3. À chaque étape :

# Après la sélection d'une action
buffer.push(state, action, reward, 
            next_state, done)
...

# Avant de calculer les erreurs TD : replay_buffer.sample(batch_size) ...
# Après le calcul des erreurs TD buffer.update_priorities(indices, td_errors)
loss = torch.sum(weights * (td_errors ** 2))
Apprentissage par renforcement profond en Python

PER en action : CartPole

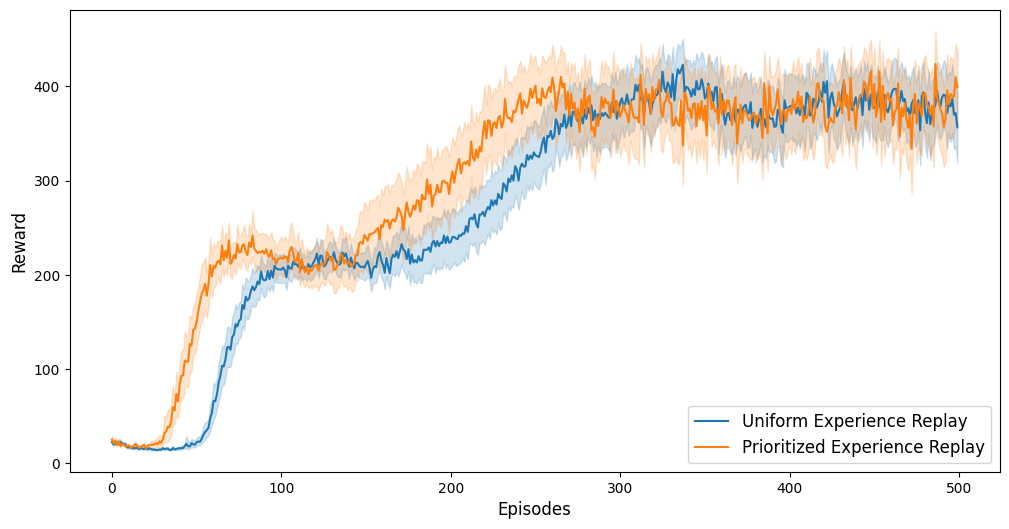
100 entraînements dans l'environnement CartPole :

  1. avec Prioritized Experience Replay
  2. avec Experience Replay uniforme
  • Apprentissage plus rapide et meilleures performances avec PER qu'avec l'uniforme

Courbes d'apprentissage : PER apprend plus vite


Après 100 époques : CartPole, instable après 100 époques


Après 400 époques : CartPole, stable après 400 époques

Apprentissage par renforcement profond en Python

PER en action : environnements Atari


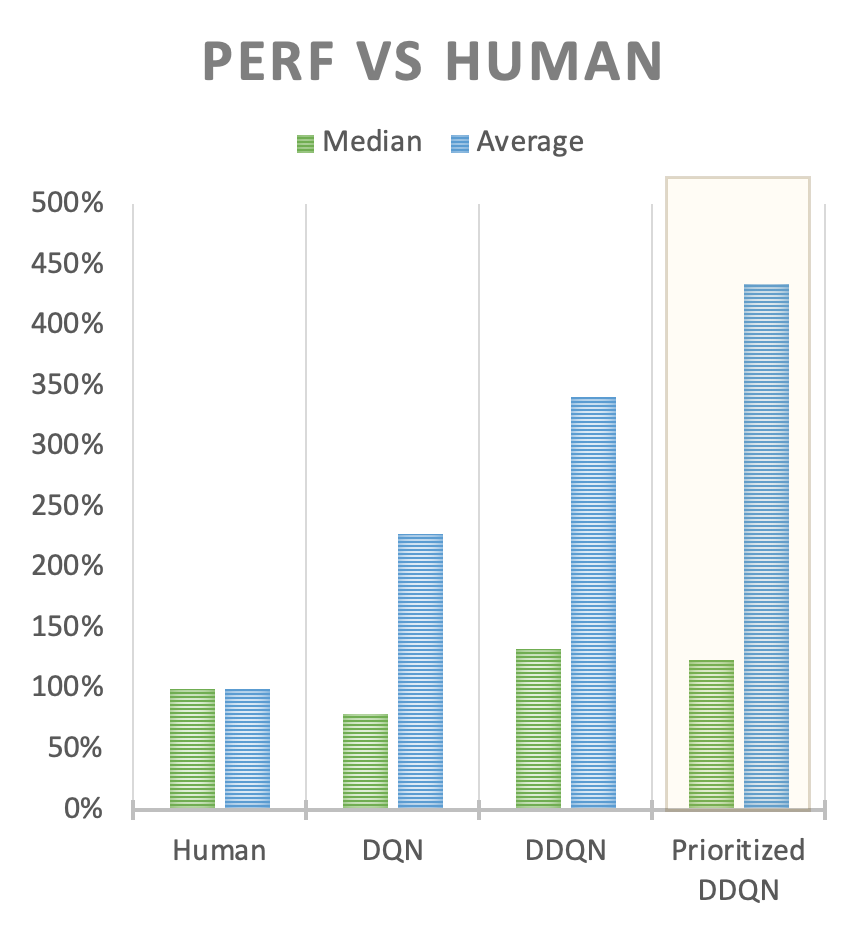
  • Gain de performance notable avec PER dans les environnements Atari

Histogramme comparant la performance des humains, DQN, DDQN, Dueling DDQN, Prioritized DDQN et Prioritized Dueling DQN. Les quatre premiers sont identiques à l'histogramme de la leçon précédente sur Dueling DQN. Le dernier montre que l'ajout de Prioritized Experience Replay améliore la performance de DDQN.

1 https://arxiv.org/abs/2303.11634
Apprentissage par renforcement profond en Python

Passons à la pratique !

Apprentissage par renforcement profond en Python

Preparing Video For Download...