Embeddings et encodage positionnel

Modèles Transformer avec PyTorch

James Chapman

Curriculum Manager, DataCamp

Embeddings et encodage positionnel dans les transformers
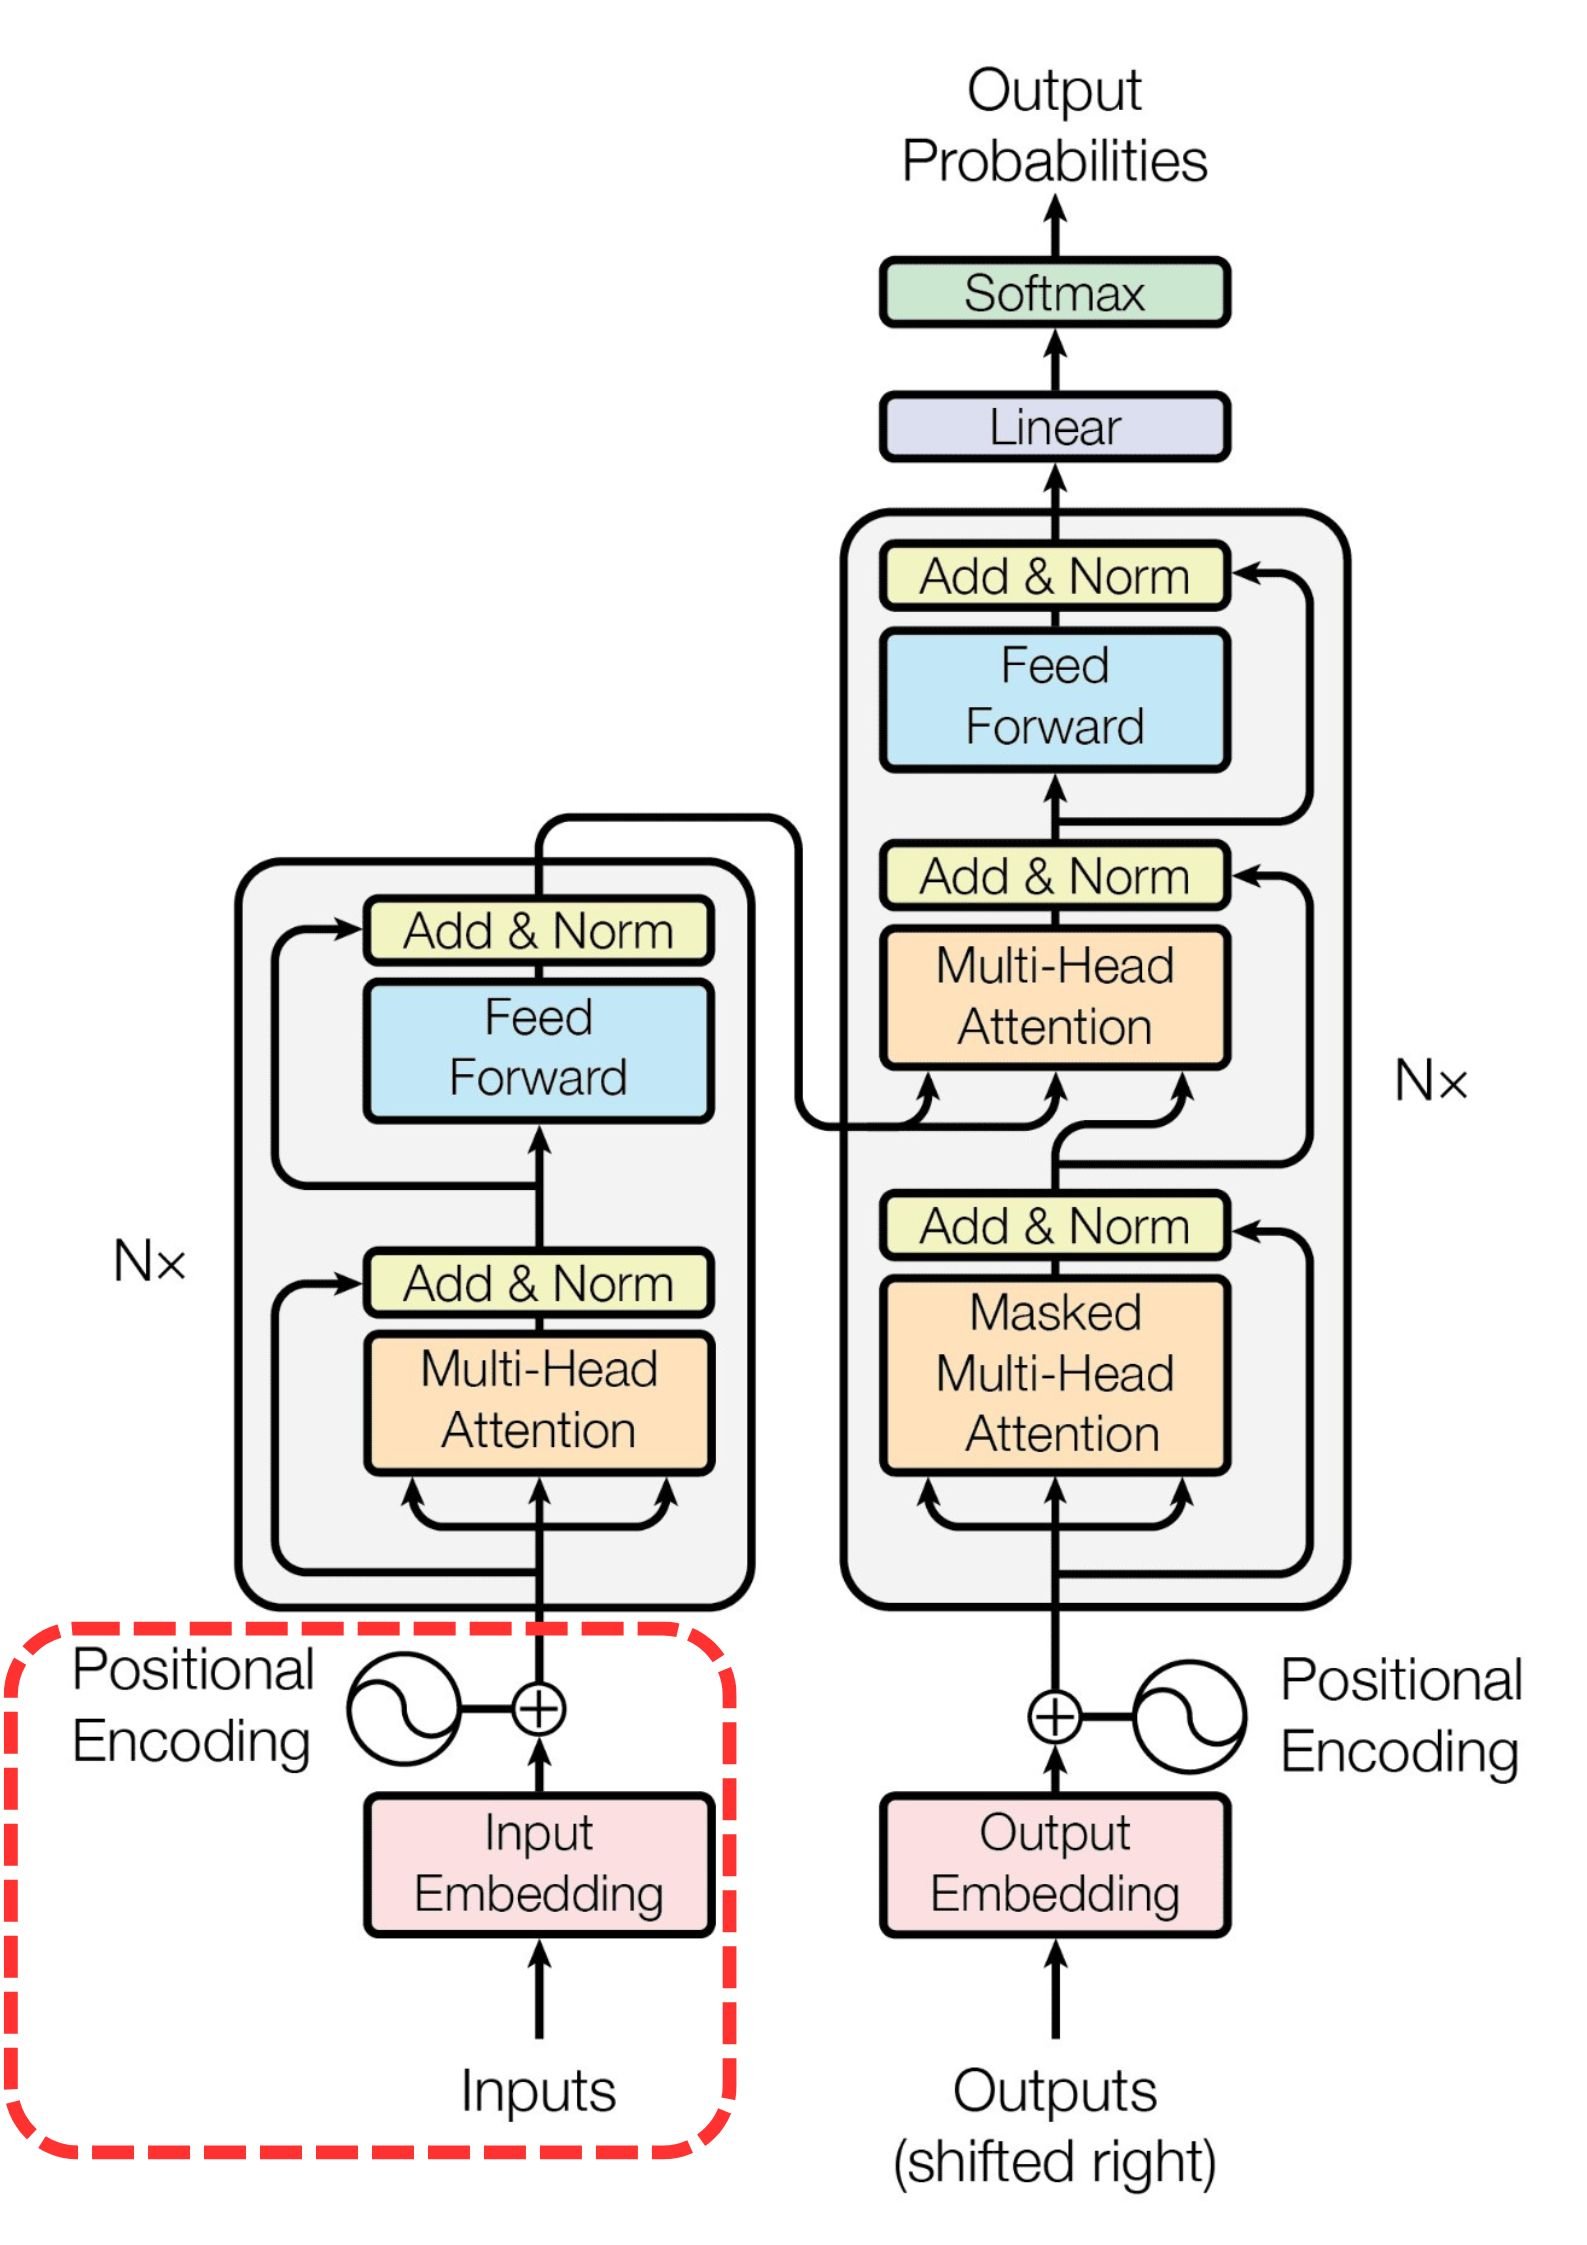
 

  • Embedding : tokens → vecteur d'embedding
  • Encodage positionnel : position du token + vecteur d'embedding → encodage positionnel

Les composants d'embedding de tokens et d'encodage positionnel mis en évidence dans l'architecture du transformer.

Modèles Transformer avec PyTorch

Encoder des séquences en embeddings

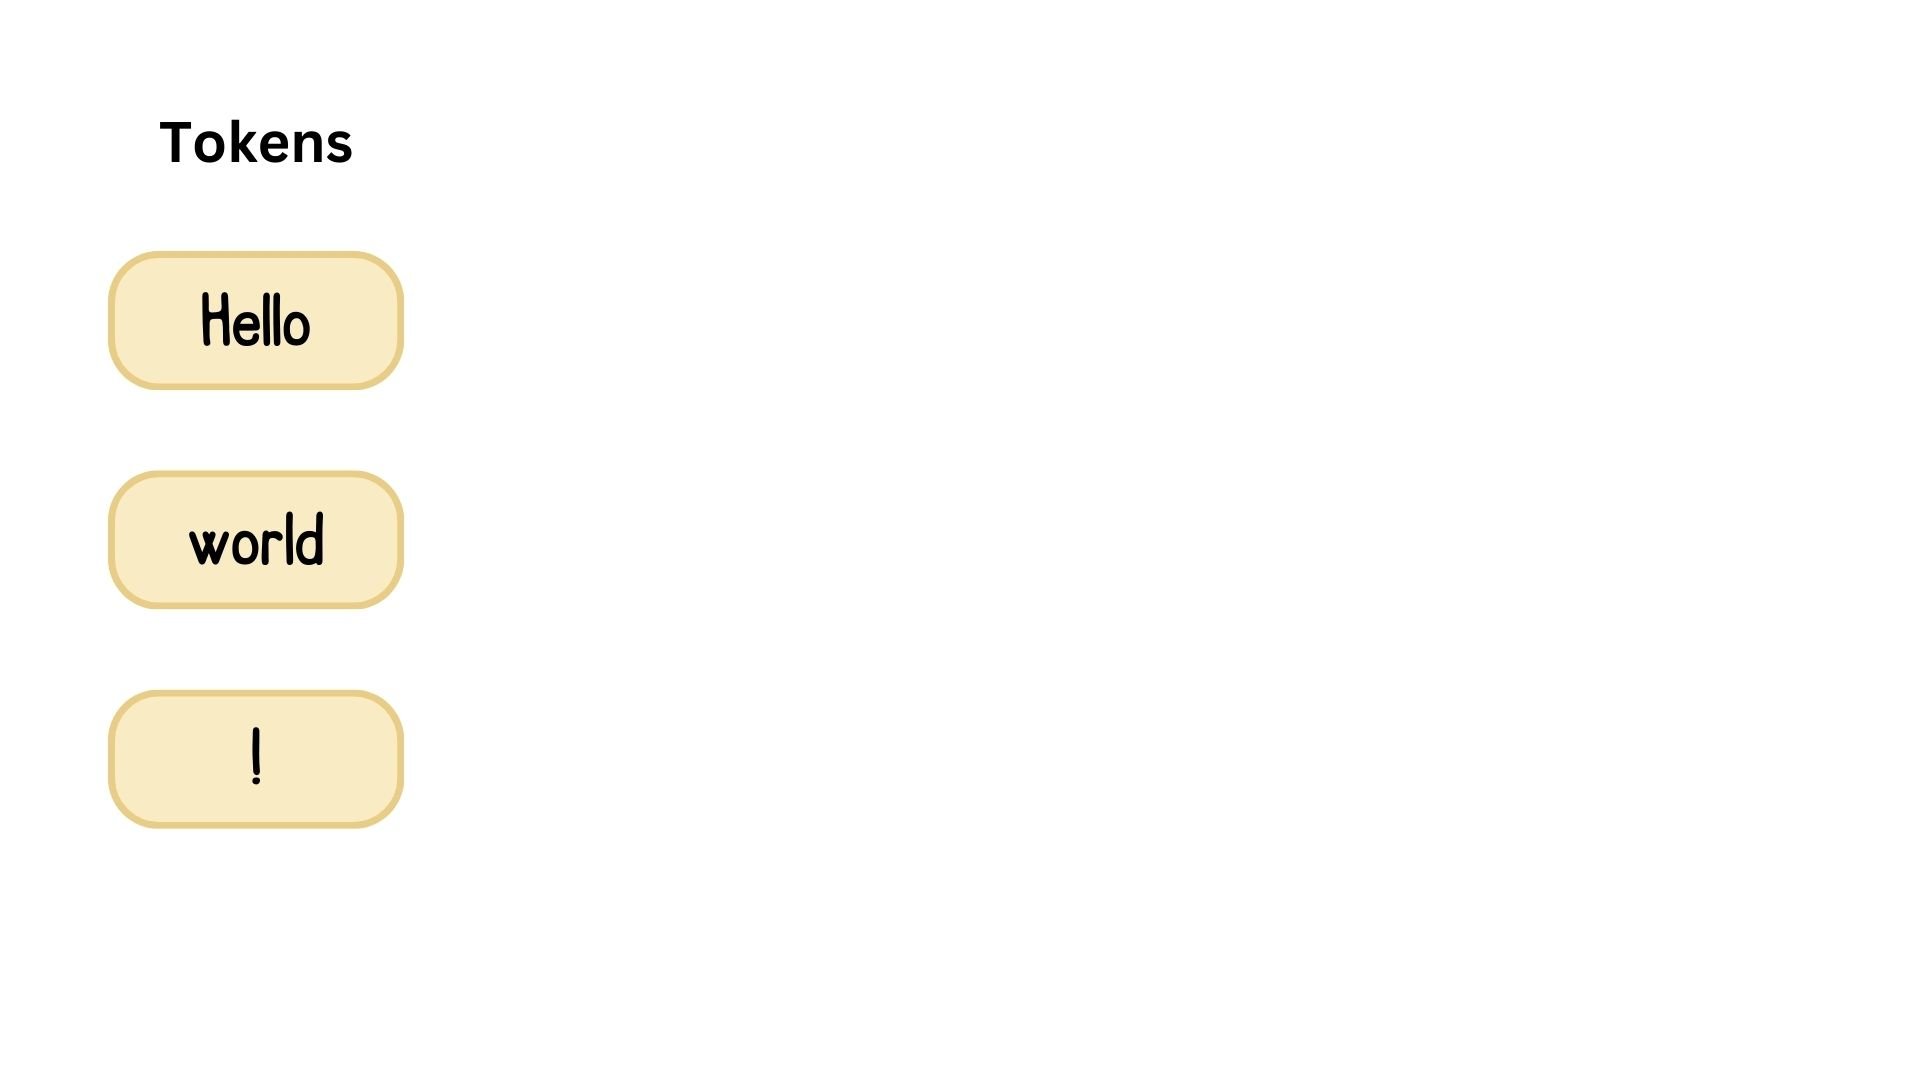
Trois tokens : Hello, world, et un point d'exclamation.

Modèles Transformer avec PyTorch

Encoder des séquences en embeddings

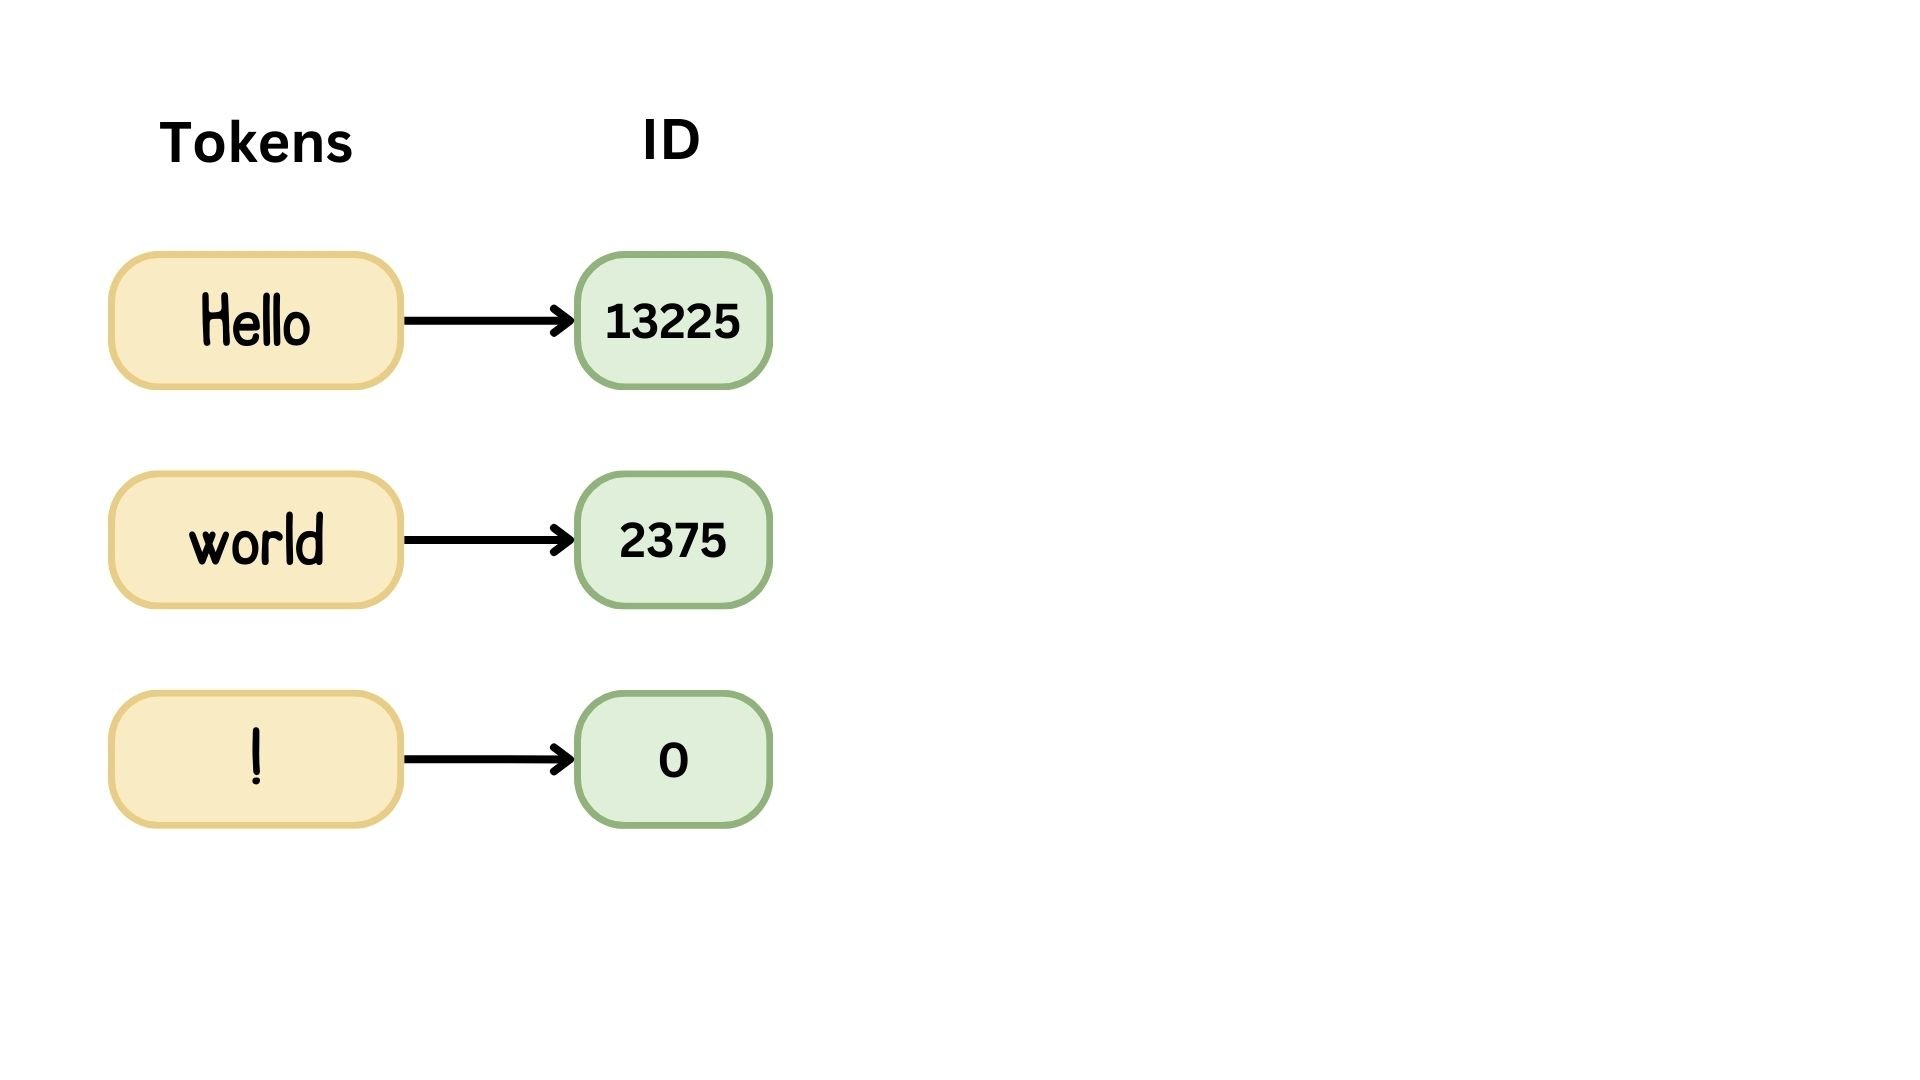
Les trois tokens convertis en IDs de tokens selon le vocabulaire du modèle.

Modèles Transformer avec PyTorch

Encoder des séquences en embeddings

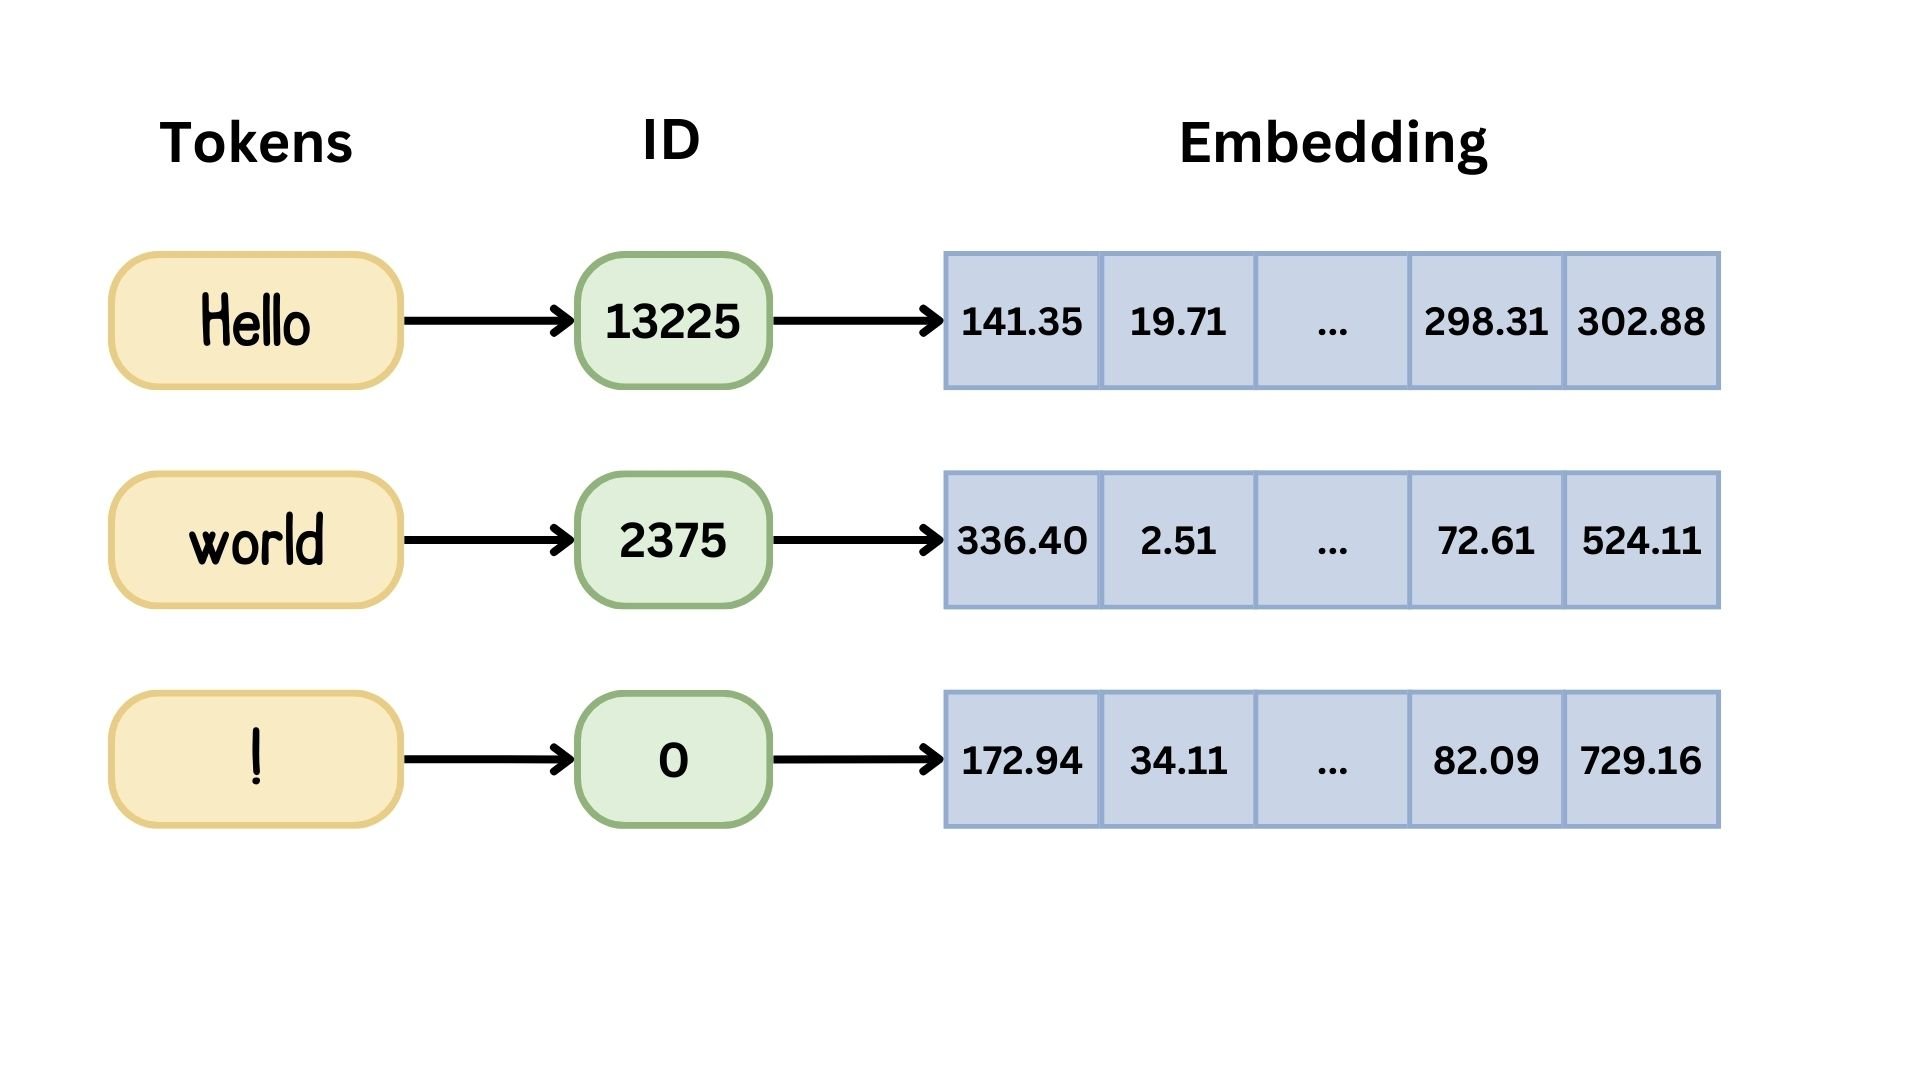
Les IDs de tokens convertis en vecteurs d'une certaine dimension.

Modèles Transformer avec PyTorch
import torch
import math
import torch.nn as nn

class InputEmbeddings(nn.Module):

def __init__(self, vocab_size: int, d_model: int) -> None: super().__init__() self.d_model = d_model self.vocab_size = vocab_size self.embedding = nn.Embedding(vocab_size, d_model)
def forward(self, x): return self.embedding(x) * math.sqrt(self.d_model)
  • Pratique standard : mise à l'échelle par $\sqrt{d_{model}}$
Modèles Transformer avec PyTorch

Créer des embeddings

embedding_layer = InputEmbeddings(vocab_size=10_000, d_model=512)

embedded_output = embedding_layer(torch.tensor([[1, 2, 3, 4], [5, 6, 7, 8]]))
print(embedded_output.shape)
torch.Size([2, 4, 512])
Modèles Transformer avec PyTorch

Encodage positionnel

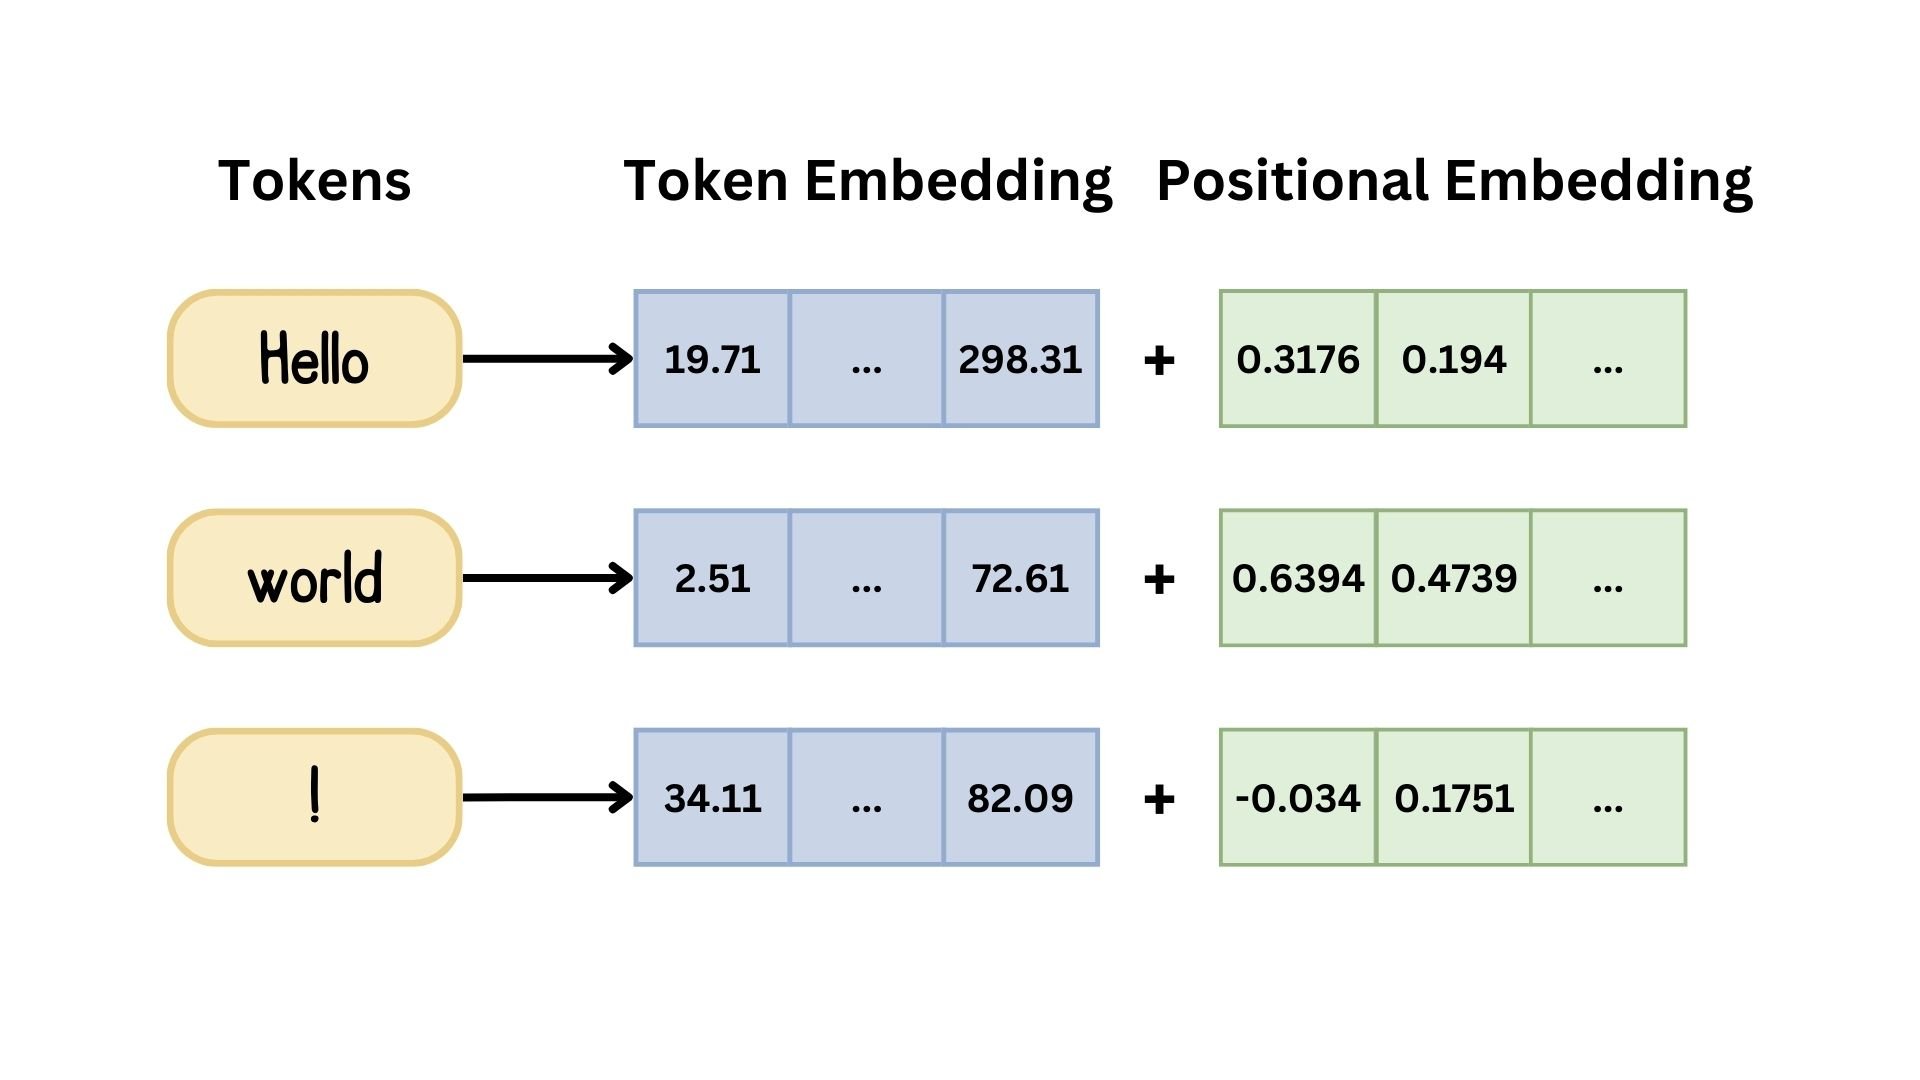
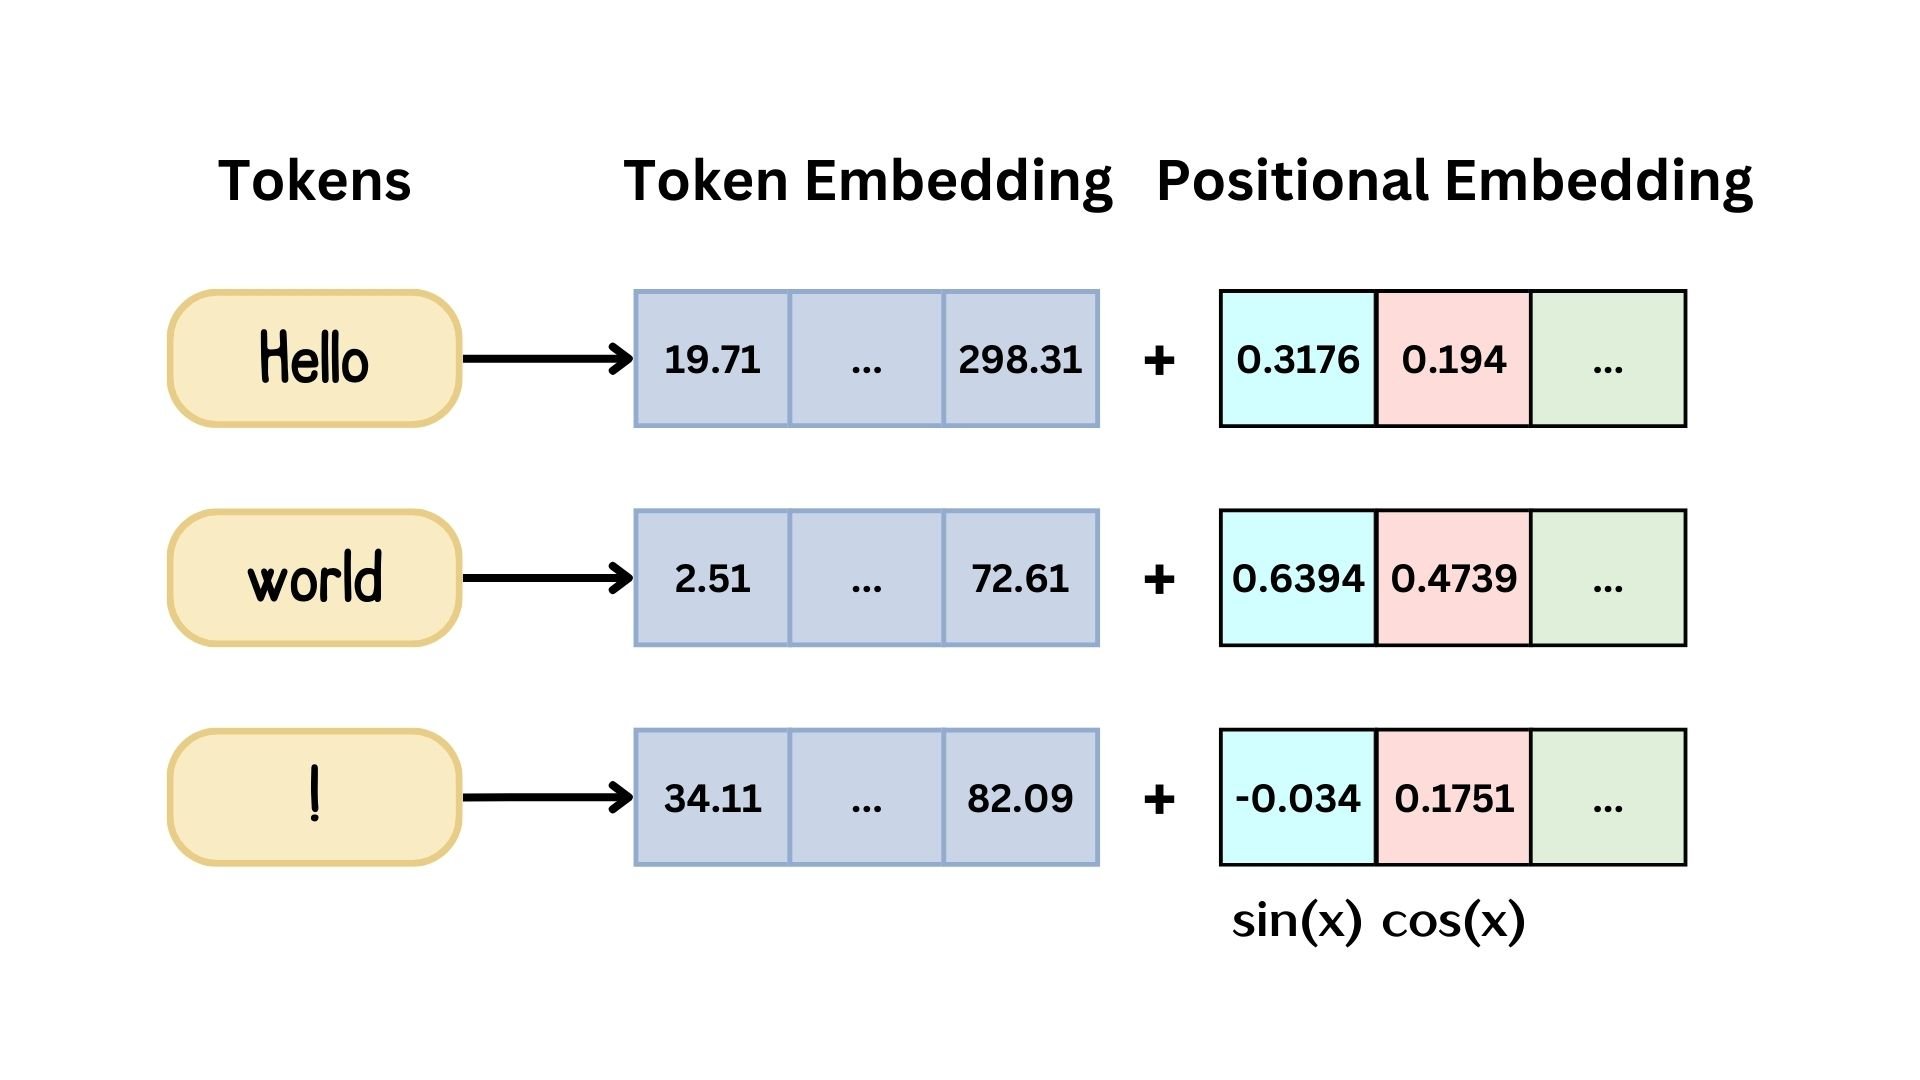
Les embeddings de tokens et positionnels sont additionnés pour ajouter l'information de position aux embeddings d'entrée.

Modèles Transformer avec PyTorch

Encodage positionnel

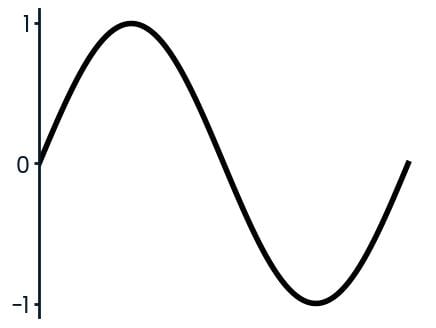
Les valeurs impaires de l'encodage positionnel utilisent la fonction sinus, et les valeurs paires utilisent la fonction cosinus.

Modèles Transformer avec PyTorch

sin(x)

La fonction sinus.


$$ PE_{(pos, 2i)}=\sin(\frac{pos}{10000^{2i/d_{model}}}) $$

cos(x)
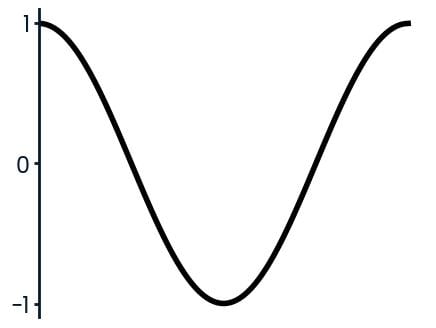
La fonction cosinus.


$$ PE_{(pos, 2i+1)}=\cos(\frac{pos}{10000^{2i/d_{model}}}) $$

Modèles Transformer avec PyTorch

Construire un encodeur positionnel

class PositionalEncoding(nn.Module):
    def __init__(self, d_model, max_seq_length):
        super().__init__()

        pe = torch.zeros(max_seq_length, d_model)

position = torch.arange(0, max_seq_length, dtype=torch.float).unsqueeze(1)
div_term = torch.exp(torch.arange(0, d_model, 2, dtype=torch.float) * -(math.log(10000.0) / d_model)) pe[:, 0::2] = torch.sin(position * div_term) pe[:, 1::2] = torch.cos(position * div_term)
self.register_buffer('pe', pe.unsqueeze(0))
def forward(self, x): return x + self.pe[:, :x.size(1)]
Modèles Transformer avec PyTorch

Créer des encodages positionnels

pos_encoding_layer = PositionalEncoding(d_model=512, max_seq_length=4)

pos_encoded_output = pos_encoding_layer(embedded_output)
print(pos_encoded_output.shape)
torch.Size([2, 4, 512])
Modèles Transformer avec PyTorch

Passons à la pratique !

Modèles Transformer avec PyTorch

Preparing Video For Download...