Validation croisée de données temporelles

Machine Learning for Time Series Data in Python

Chris Holdgraf

Fellow, Berkeley Institute for Data Science

Validation croisée avec scikit-learn

# Iterating over the "split" method yields train/test indices
for tr, tt in cv.split(X, y):
    model.fit(X[tr], y[tr])
    model.score(X[tt], y[tt])
Machine Learning for Time Series Data in Python

Types de validation croisée : KFold

  • La validation croisée KFold divise les données en « folds » de taille égale
  • C'est l'une des méthodes de validation croisée les plus courantes

      from sklearn.model_selection import KFold
      cv = KFold(n_splits=5)
      for tr, tt in cv.split(X, y):
          ...
    
Machine Learning for Time Series Data in Python

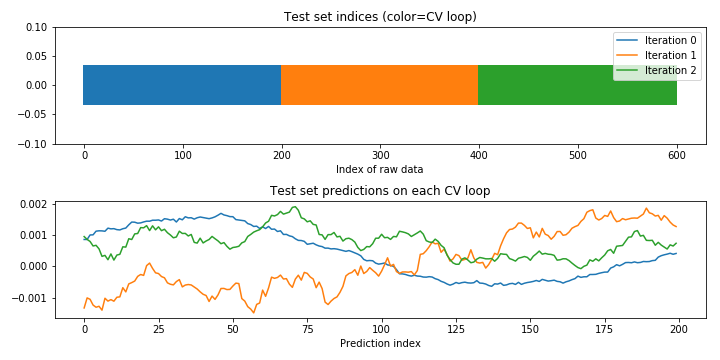
Visualiser les prédictions du modèle

fig, axs = plt.subplots(2, 1)

# Plot the indices chosen for validation on each loop
axs[0].scatter(tt, [0] * len(tt), marker='_', s=2, lw=40)
axs[0].set(ylim=[-.1, .1], title='Test set indices (color=CV loop)', 
           xlabel='Index of raw data')

# Plot the model predictions on each iteration
axs[1].plot(model.predict(X[tt]))
axs[1].set(title='Test set predictions on each CV loop', 
           xlabel='Prediction index')
Machine Learning for Time Series Data in Python

Visualiser le comportement de KFold

Machine Learning for Time Series Data in Python

À propos du mélange des données

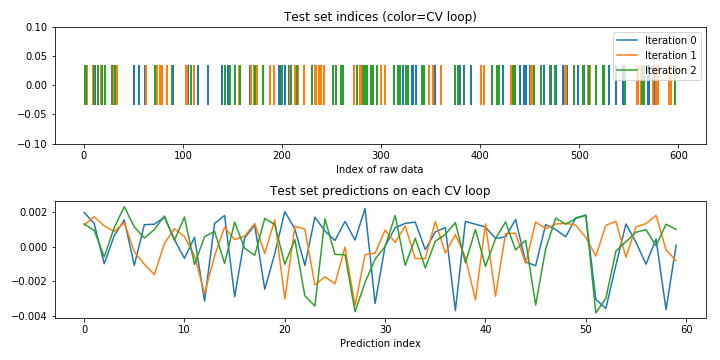
  • De nombreux itérateurs de VC permettent de mélanger les données pendant la validation croisée.
  • Cela ne fonctionne que si les données sont i.i.d., ce qui n'est généralement pas le cas des séries temporelles.
  • Il ne faut pas mélanger les données pour prédire avec des séries temporelles.

      from sklearn.model_selection import ShuffleSplit
    
      cv = ShuffleSplit(n_splits=3)
      for tr, tt in cv.split(X, y):
          ...
    
Machine Learning for Time Series Data in Python

Visualiser le comportement avec mélange
Machine Learning for Time Series Data in Python

Utiliser l'itérateur CV pour séries temporelles

  • Jusqu'ici, nous avons rompu la linéarité du temps dans la validation croisée
  • Cependant, il ne faut généralement pas utiliser des points futurs pour prédire le passé
  • Une approche : utiliser des données d'entraînement du passé pour prédire le futur
Machine Learning for Time Series Data in Python

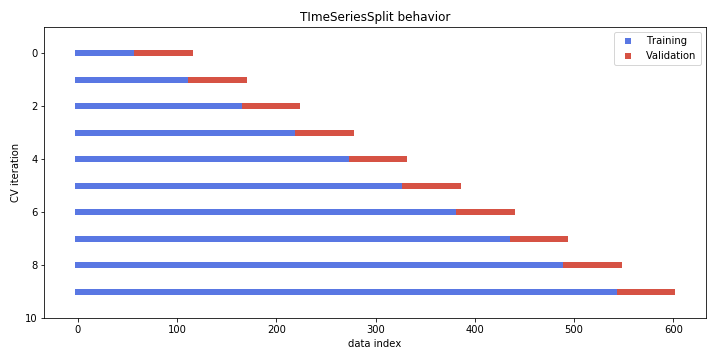
Visualiser les itérateurs de validation croisée temporelle

# Import and initialize the cross-validation iterator
from sklearn.model_selection import TimeSeriesSplit
cv = TimeSeriesSplit(n_splits=10)

fig, ax = plt.subplots(figsize=(10, 5))
for ii, (tr, tt) in enumerate(cv.split(X, y)):
    # Plot training and test indices
    l1 = ax.scatter(tr, [ii] * len(tr), c=[plt.cm.coolwarm(.1)], 
                    marker='_', lw=6)
    l2 = ax.scatter(tt, [ii] * len(tt), c=[plt.cm.coolwarm(.9)], 
                    marker='_', lw=6)
    ax.set(ylim=[10, -1], title='TimeSeriesSplit behavior', 
           xlabel='data index', ylabel='CV iteration')
    ax.legend([l1, l2], ['Training', 'Validation'])
Machine Learning for Time Series Data in Python

Visualiser l'itérateur TimeSeriesSplit
Machine Learning for Time Series Data in Python

Fonctions de score personnalisées dans scikit-learn

def myfunction(estimator, X, y):
    y_pred = estimator.predict(X)
    my_custom_score = my_custom_function(y_pred, y)
    return my_custom_score
Machine Learning for Time Series Data in Python

Une fonction de corrélation personnalisée pour scikit-learn

def my_pearsonr(est, X, y):
    # Generate predictions and convert to a vector 
    y_pred = est.predict(X).squeeze()

    # Use the numpy "corrcoef" function to calculate a correlation matrix
    my_corrcoef_matrix = np.corrcoef(y_pred, y.squeeze())

    # Return a single correlation value from the matrix
    my_corrcoef = my_corrcoef[1, 0]
    return my_corrcoef
Machine Learning for Time Series Data in Python

Passons à la pratique !

Machine Learning for Time Series Data in Python

Preparing Video For Download...