Améliorer les caractéristiques pour la classification

Machine Learning for Time Series Data in Python

Chris Holdgraf

Fellow, Berkeley Institute for Data Science

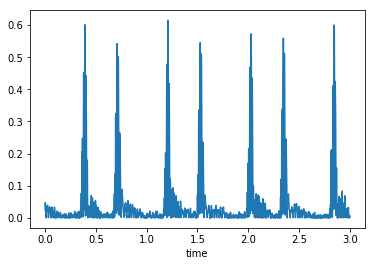
L'enveloppe auditive

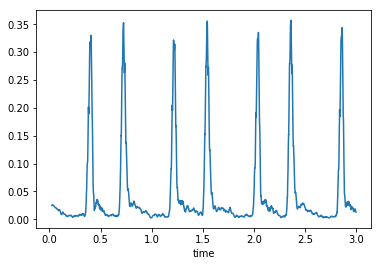
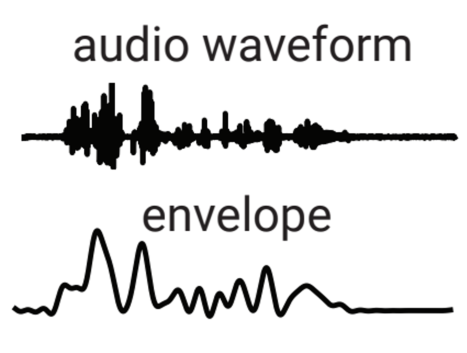
  • Lisser les données pour calculer l'enveloppe auditive
  • Liée à la quantité totale d'énergie audio présente à chaque instant
Machine Learning for Time Series Data in Python

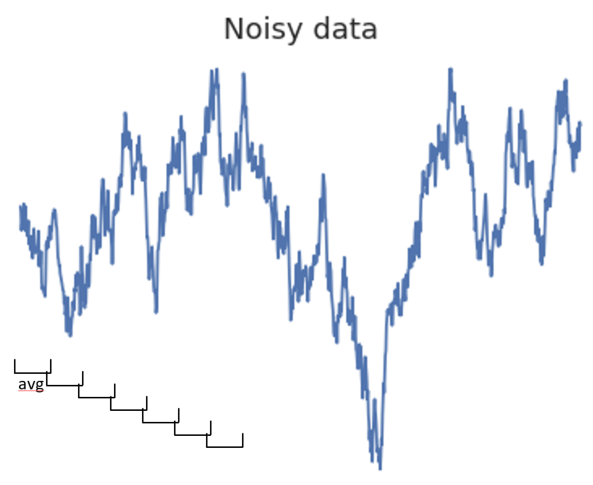
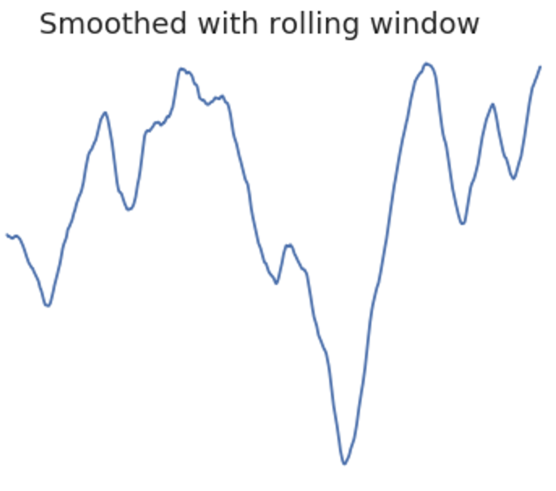
Lisser dans le temps

  • Au lieu de moyenner sur toute la durée, on peut faire une moyenne locale
  • C'est le lissage d'une série temporelle
  • Il supprime le bruit à court terme tout en gardant la tendance générale
Machine Learning for Time Series Data in Python

Lisser vos données

Machine Learning for Time Series Data in Python

Calculer une statistique en fenêtre glissante

# Audio est un DataFrame Pandas
print(audio.shape)  
# (n_times, n_audio_files)
(5000, 20)  
# Lisser nos données en prenant la moyenne glissante sur une fenêtre de 50 échantillons
window_size = 50
windowed = audio.rolling(window=window_size)
audio_smooth = windowed.mean()
Machine Learning for Time Series Data in Python

Calculer l'enveloppe auditive

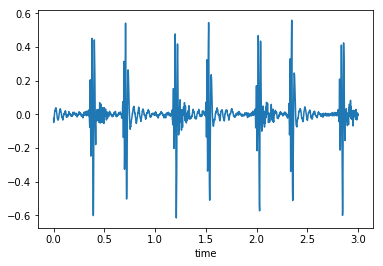
  • D'abord redresser l'audio, puis le lisser

      audio_rectified = audio.apply(np.abs)
      audio_envelope = audio_rectified.rolling(50).mean()
    
Machine Learning for Time Series Data in Python

Machine Learning for Time Series Data in Python

Machine Learning for Time Series Data in Python

Machine Learning for Time Series Data in Python

Concevoir des caractéristiques à partir de l'enveloppe

# Calculer plusieurs caractéristiques de l'enveloppe, une par son
envelope_mean = np.mean(audio_envelope, axis=0)
envelope_std = np.std(audio_envelope, axis=0)
envelope_max = np.max(audio_envelope, axis=0)

# Créer nos données d'entraînement pour un classificateur
X = np.column_stack([envelope_mean, envelope_std, envelope_max])
Machine Learning for Time Series Data in Python

Préparer nos caractéristiques pour scikit-learn

X = np.column_stack([envelope_mean, envelope_std, envelope_max])
y = labels.reshape(-1, 1)
Machine Learning for Time Series Data in Python

Validation croisée pour la classification

  • cross_val_score automatise :
    • La séparation entraînement / validation
    • L'ajustement du modèle sur l'entraînement
    • L'évaluation sur la validation
    • La répétition du processus
Machine Learning for Time Series Data in Python

Utiliser cross_val_score

from sklearn.model_selection import cross_val_score

model = LinearSVC()
scores = cross_val_score(model, X, y, cv=3) 
print(scores)
[0.60911642 0.59975305 0.61404035]
Machine Learning for Time Series Data in Python

Caractéristiques auditives : le tempogramme

  • On peut résumer des informations temporelles plus complexes avec des fonctions dédiées aux séries temporelles
  • librosa est une excellente bibliothèque pour l'ingénierie de caractéristiques audio et temporelles
  • Ici, nous calculons le tempogram, qui estime le tempo d'un son au fil du temps
  • On peut en extraire des statistiques de synthèse comme pour l'enveloppe
Machine Learning for Time Series Data in Python

Calculer le tempogramme

# Importer librosa et calculer le tempo d'un tableau audio 1-D
import librosa as lr
audio_tempo = lr.beat.tempo(y=audio, sr=sfreq, 
                            hop_length=2**6)
Machine Learning for Time Series Data in Python

Passons à la pratique !

Machine Learning for Time Series Data in Python

Preparing Video For Download...