Nettoyer et améliorer vos données

Machine Learning for Time Series Data in Python

Chris Holdgraf

Fellow, Berkeley Institute for Data Science

Des données désordonnées

  • Les données réelles sont souvent désordonnées
  • Les deux problèmes les plus courants sont les valeurs manquantes et les valeurs aberrantes
  • Cela vient souvent d'erreurs humaines, de capteurs défaillants, de pannes de base de données, etc.
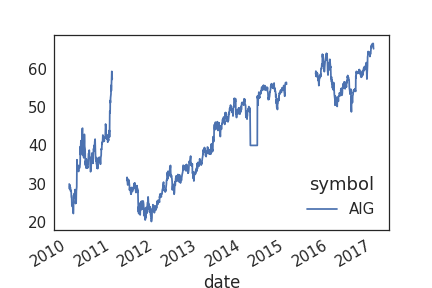
  • Visualiser vos données brutes aide à repérer ces problèmes
Machine Learning for Time Series Data in Python

À quoi ressemblent des données désordonnées
Machine Learning for Time Series Data in Python

Interpolation : utiliser le temps pour combler les manques

  • Une approche courante pour traiter les valeurs manquantes est d'interpoler les valeurs absentes
  • Avec des séries temporelles, le temps peut aider à l'interpolation.
  • Ici, l'interpolation consiste à utiliser les valeurs connues de part et d'autre d'un trou pour estimer ce qui manque.
Machine Learning for Time Series Data in Python

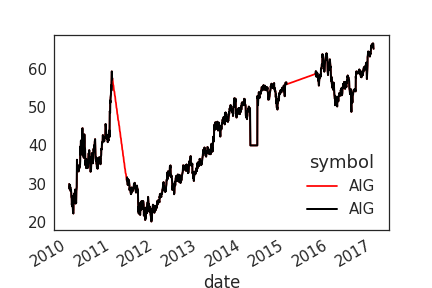
Interpolation avec Pandas

# Indique en booléen où les valeurs manquent
missing = prices.isna()

# Interpole linéairement dans les fenêtres manquantes
prices_interp = prices.interpolate('linear')

# Trace les données interpolées en rouge et celles avec valeurs manquantes en noir
ax = prices_interp.plot(c='r')
prices.plot(c='k', ax=ax, lw=2)
Machine Learning for Time Series Data in Python

Visualiser les données interpolées

Machine Learning for Time Series Data in Python

Transformer avec une fenêtre glissante

  • Un autre usage des fenêtres glissantes est de transformer les données
  • Nous l'avons déjà fait pour lisser la série
  • On peut aussi s'en servir pour des transformations plus complexes
Machine Learning for Time Series Data in Python

Transformer pour standardiser la variance

  • Une transformation fréquente consiste à standardiser la moyenne et la variance dans le temps. Plusieurs méthodes existent.
  • Ici, nous convertissons l'ensemble pour que chaque point représente le % de variation sur une fenêtre précédente.
  • Cela rend les instants plus comparables si les valeurs absolues varient beaucoup
Machine Learning for Time Series Data in Python

Transformer en pourcentage de variation avec Pandas

def percent_change(values):
    """Calculates the % change between the last value 
    and the mean of previous values"""
    # Séparer la dernière valeur et les précédentes
    previous_values = values[:-1]
    last_value = values[-1]

    # Calculer l'écart en % entre la dernière valeur 
    # et la moyenne des valeurs précédentes
    percent_change = (last_value - np.mean(previous_values)) \
    / np.mean(previous_values)
    return percent_change
Machine Learning for Time Series Data in Python

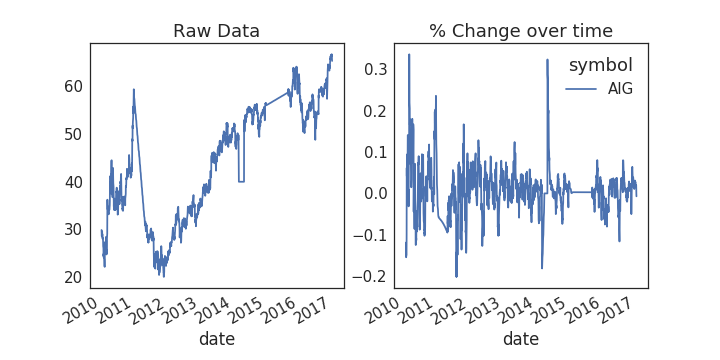
Appliquer ceci à nos données

# Tracer les données brutes
fig, axs = plt.subplots(1, 2, figsize=(10, 5))
ax = prices.plot(ax=axs[0])

# Calculer le % de variation et tracer
ax = prices.rolling(window=20).aggregate(percent_change).plot(ax=axs[1])
ax.legend_.set_visible(False)
Machine Learning for Time Series Data in Python

Détecter les valeurs aberrantes

  • Les valeurs aberrantes sont des points très différents statistiquement du reste du jeu de données.
  • Elles peuvent nuire au pouvoir prédictif du modèle en l'éloignant de sa « vraie » valeur
  • Une solution est de supprimer ou remplacer ces valeurs par une valeur plus représentative

Soyez très prudent : il est souvent difficile de distinguer une valeur vraiment extrême d'une aberration

Machine Learning for Time Series Data in Python

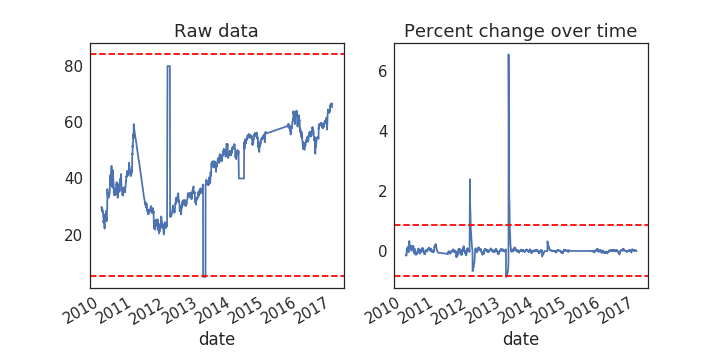
Tracer un seuil sur nos données

fig, axs = plt.subplots(1, 2, figsize=(10, 5))
for data, ax in zip([prices, prices_perc_change], axs):
    # Calculer la moyenne et l'écart-type
    this_mean = data.mean()
    this_std = data.std()

    # Tracer les données avec une bande à 3 écarts-types 
    # autour de la moyenne
    data.plot(ax=ax)
    ax.axhline(this_mean + this_std * 3, ls='--', c='r')
    ax.axhline(this_mean - this_std * 3, ls='--', c='r')
Machine Learning for Time Series Data in Python

Visualiser les seuils d'aberration

Machine Learning for Time Series Data in Python

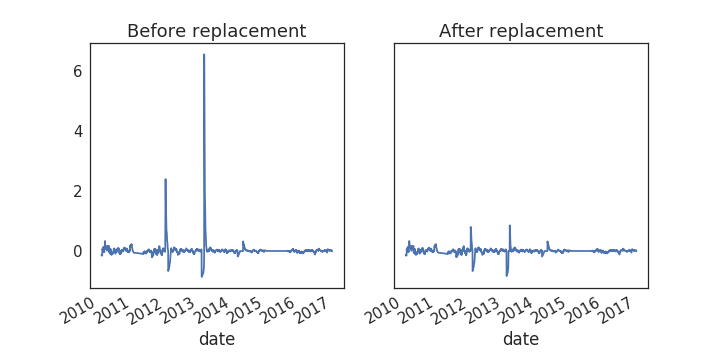
Remplacer les valeurs aberrantes avec le seuil

# Centrer les données pour une moyenne à 0
prices_outlier_centered = prices_outlier_perc - prices_outlier_perc.mean()

# Calculer l'écart-type
std = prices_outlier_perc.std()

# Utiliser la valeur absolue de chaque point 
# pour faciliter la détection des valeurs aberrantes
outliers = np.abs(prices_outlier_centered) > (std * 3)

# Remplacer les valeurs aberrantes par la médiane
# Utiliser np.nanmean car il peut y avoir des NaN autour des outliers
prices_outlier_fixed = prices_outlier_centered.copy()
prices_outlier_fixed[outliers] = np.nanmedian(prices_outlier_fixed)

Machine Learning for Time Series Data in Python

Visualiser les résultats

fig, axs = plt.subplots(1, 2, figsize=(10, 5))
prices_outlier_centered.plot(ax=axs[0])
prices_outlier_fixed.plot(ax=axs[1])
Machine Learning for Time Series Data in Python

Passons à la pratique !

Machine Learning for Time Series Data in Python

Preparing Video For Download...