Préparer les données pour l’analyse de clusters

Analyse de clusters en Python

Shaumik Daityari

Business Analyst

Pourquoi préparer les données pour le clustering ?

  • Unités incomparables entre variables (dimensions en cm, prix en $)
  • Échelles et variances très différentes malgré mêmes unités (dépenses en céréales, voyages)
  • Les données brutes peuvent biaiser le clustering
  • Les clusters peuvent dépendre fortement d’une variable
  • Solution : normaliser chaque variable
Analyse de clusters en Python

Normalisation des données

Normalisation : remise à l’échelle pour obtenir un écart type de 1

x_new = x / std_dev(x)

from scipy.cluster.vq import whiten
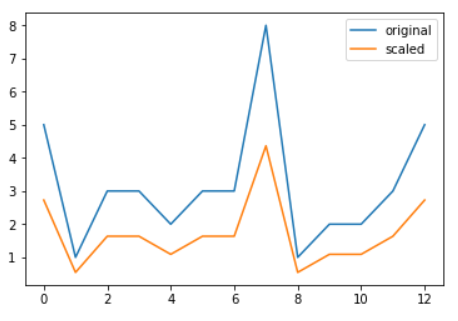
data = [5, 1, 3, 3, 2, 3, 3, 8, 1, 2, 2, 3, 5]
scaled_data = whiten(data)
print(scaled_data)
[2.73, 0.55, 1.64, 1.64, 1.09, 1.64, 1.64, 4.36, 0.55, 1.09, 1.09, 1.64, 2.73]
Analyse de clusters en Python

Illustration : normalisation des données

# Import plotting library
from matplotlib import pyplot as plt

# Initialize original, scaled data
plt.plot(data, 
         label="original")
plt.plot(scaled_data, 
         label="scaled")
# Show legend and display plot
plt.legend()
plt.show()

Analyse de clusters en Python

À suivre : quelques exercices pratiques

Analyse de clusters en Python

Preparing Video For Download...