Regroupement de documents

Analyse de clusters en Python

Shaumik Daityari

Business Analyst

Regroupement de documents : notions

  1. Nettoyer les données avant traitement
  2. Déterminer l’importance des termes d’un document (matrice TF‑IDF)
  3. Regrouper la matrice TF‑IDF
  4. Trouver les termes et documents clés de chaque cluster
Analyse de clusters en Python

Nettoyer et tokeniser les données

  • Convertir le texte en tokens et nettoyer pour le traitement
from nltk.tokenize import word_tokenize
import re

def remove_noise(text, stop_words = []):
    tokens = word_tokenize(text)

cleaned_tokens = [] for token in tokens: token = re.sub('[^A-Za-z0-9]+', '', token)
if len(token) > 1 and token.lower() not in stop_words: # Get lowercase cleaned_tokens.append(token.lower()) return cleaned_tokens
remove_noise("It is lovely weather we are having. I hope the weather continues.")
['lovely', 'weather', 'hope', 'weather', 'continues']
Analyse de clusters en Python

Matrice termes‑documents et matrices creuses

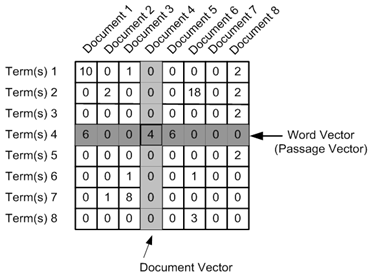
  • Matrice termes‑documents créée
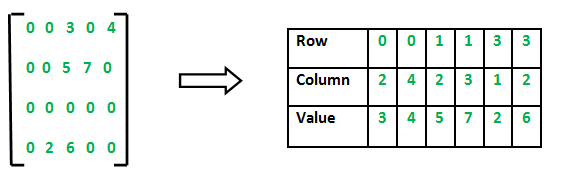
  • La plupart des éléments sont des zéros

Source

  • Création d’une matrice creuse

Source

Analyse de clusters en Python

TF‑IDF (Term Frequency - Inverse Document Frequency)

  • Mesure pondérée : évalue l’importance d’un mot pour un document dans un corpus
from sklearn.feature_extraction.text import TfidfVectorizer

tfidf_vectorizer = TfidfVectorizer(max_df=0.8, max_features=50, min_df=0.2, tokenizer=remove_noise)
tfidf_matrix = tfidf_vectorizer.fit_transform(data)
Analyse de clusters en Python

Clustering avec matrice creuse

  • kmeans() dans SciPy ne gère pas les matrices creuses
  • Utiliser .todense() pour convertir en matrice dense
cluster_centers, distortion = kmeans(tfidf_matrix.todense(), num_clusters)
Analyse de clusters en Python

Termes clés par cluster

  • Centres de clusters : listes de taille égale au nombre de termes
  • Chaque valeur du centre indique son importance
  • Créer un dictionnaire et afficher les termes clés
terms = tfidf_vectorizer.get_feature_names_out()

for i in range(num_clusters):
    center_terms = dict(zip(terms, list(cluster_centers[i])))

sorted_terms = sorted(center_terms, key=center_terms.get, reverse=True)
print(sorted_terms[:3])
['room', 'hotel', 'staff']

['bad', 'location', 'breakfast']
Analyse de clusters en Python

Autres points à noter

  • Gérer hyperliens, émoticônes, etc.
  • Normaliser les mots (run, ran, running -> run)
  • .todense() peut échouer sur de grands jeux de données
Analyse de clusters en Python

À suivre : exercices !

Analyse de clusters en Python

Preparing Video For Download...