Notions de base du k-means

Analyse de clusters en Python

Shaumik Daityari

Business Analyst

Pourquoi le k-means ?

  • Un inconvénient majeur du clustering hiérarchique : le temps d’exécution
  • K-means est nettement plus rapide sur les grands jeux de données
Analyse de clusters en Python

Étape 1 : Générer les centres

kmeans(obs, k_or_guess, iter, thresh, check_finite)
  • obs: observations standardisées
  • k_or_guess: nombre de clusters
  • iter: nombre d’itérations (par défaut : 20)
  • thres: seuil (par défaut : 1e-05)
  • check_finite: vérifier que les observations sont finies (par défaut : True)

Retourne deux objets : centres de clusters, distorsion

Analyse de clusters en Python

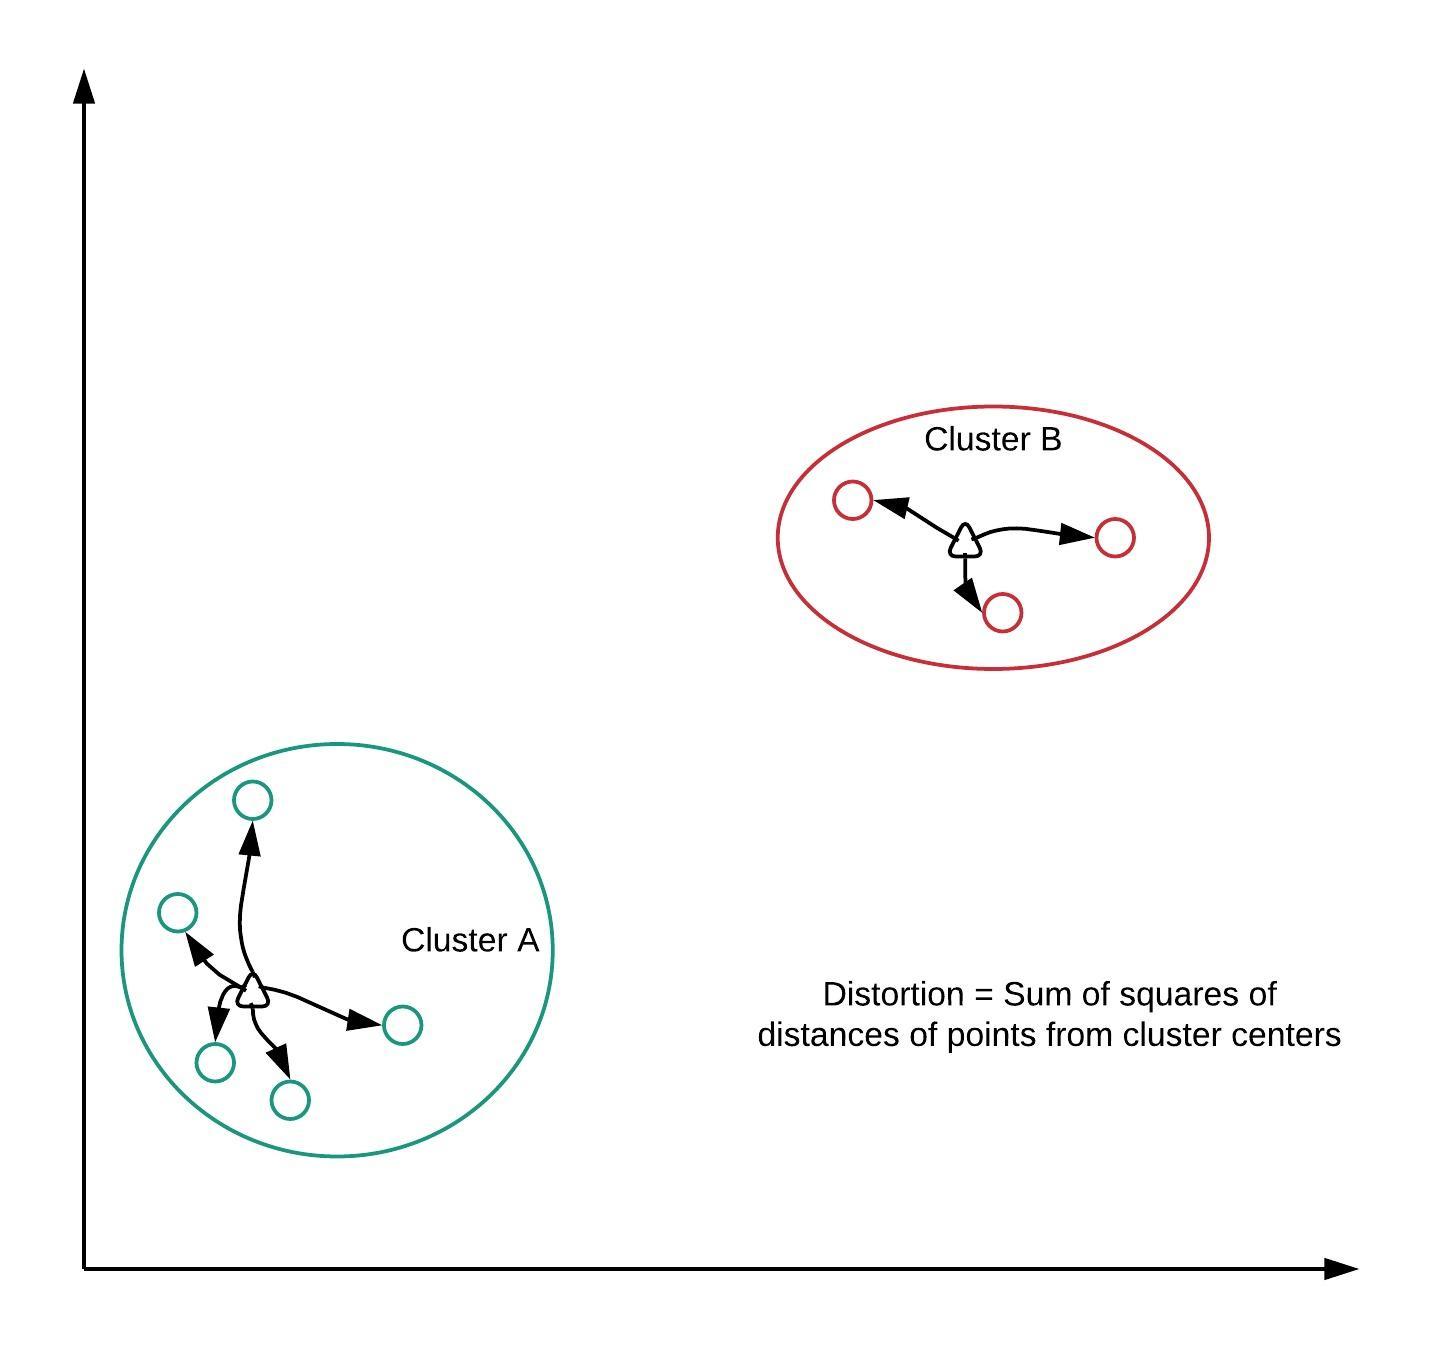
Comment calcule-t-on la distorsion ?

Analyse de clusters en Python

Étape 2 : Générer les labels

vq(obs, code_book, check_finite=True)
  • obs: observations standardisées
  • code_book: centres de clusters
  • check_finite: vérifier que les observations sont finies (par défaut : True)

Retourne deux objets : liste des labels de cluster, liste des distorsions

Analyse de clusters en Python

Remarque sur les distorsions

  • kmeans renvoie une valeur unique de distorsion
  • vq renvoie une liste de distorsions.
Analyse de clusters en Python

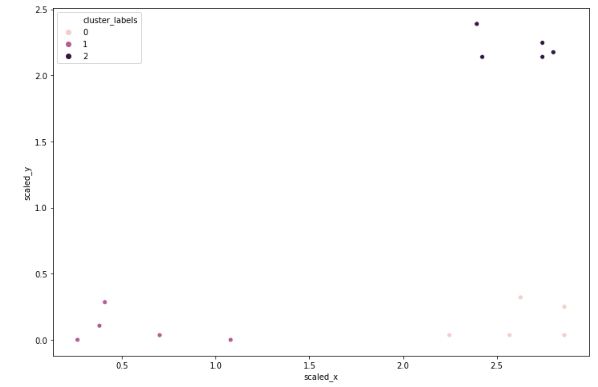
Exécuter k-means

# Import kmeans and vq functions
from scipy.cluster.vq import kmeans, vq
# Generate cluster centers and labels
cluster_centers, _ = kmeans(df[['scaled_x', 'scaled_y']], 3)
df['cluster_labels'], _ = vq(df[['scaled_x', 'scaled_y']], cluster_centers)
# Plot clusters
sns.scatterplot(x='scaled_x', y='scaled_y', hue='cluster_labels', data=df)
plt.show()
Analyse de clusters en Python

Analyse de clusters en Python

Ensuite : exercices !

Analyse de clusters en Python

Preparing Video For Download...