Ajustement efficace avec LoRA

Ajustement fin avec Llama 3

Francesca Donadoni

Curriculum Manager, DataCamp

Que se passe-t-il lors de l’entraînement d’un modèle ?
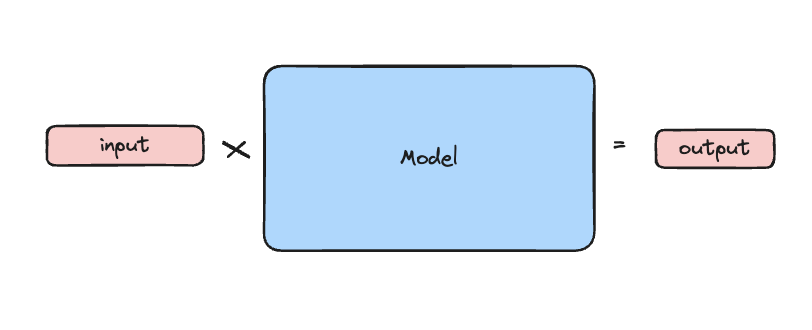
 

  • Les tokens sont des entrées formant un vecteur
  • Multiplication matricielle (modèle)
  • Produit des vecteurs de sortie
  • Les erreurs mettent à jour les poids
  • La taille du modèle détermine la difficulté

Matrices d’entrée et du modèle représentées visuellement

Ajustement fin avec Llama 3

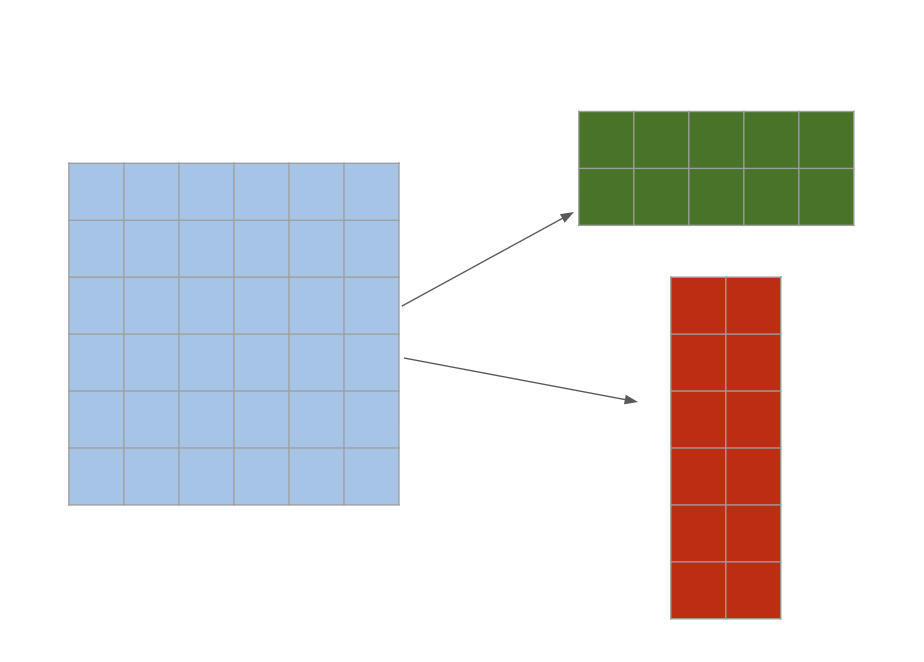
Qu’est-ce que LoRA


  • Décomposition de rang faible
  • Réduit les paramètres entraînables
  • Maintient les performances
  • Effet de régularisation

Une matrice bleue divisée en deux matrices décomposées qui, multipliées, reconstruisent l’originale.

Ajustement fin avec Llama 3

Implémenter LoRA avec PEFT

from peft import LoraConfig

lora_config = LoraConfig(
r=12,
lora_alpha=32,
lora_dropout=0.05,
bias="none",
task_type="CAUSAL_LM", target_modules=['q_proj', 'v_proj']
)
Ajustement fin avec Llama 3

Intégrer la configuration LoRA à l’entraînement

trainer = SFTTrainer(
    model=model,

train_dataset=ds,
max_seq_length=250, dataset_text_field='conversation',
tokenizer=tokenizer, args=training_arguments
peft_config=lora_config,
)
trainer.train()
Ajustement fin avec Llama 3

LoRA vs ajustement classique


  • TinyLlama/TinyLlama-1.1B-Chat-v1.0
  • 1,1 milliard de paramètres
  • 11k échantillons
  • ~30 minutes


  • nvidia/Llama3-ChatQA-1.5-8B
  • 8 milliards de paramètres
  • 11k échantillons
  • ~30 minutes
Ajustement fin avec Llama 3

Passons à la pratique !

Ajustement fin avec Llama 3

Preparing Video For Download...