Optimisation des hyperparamètres en Python
Alex Scriven
Data Scientist
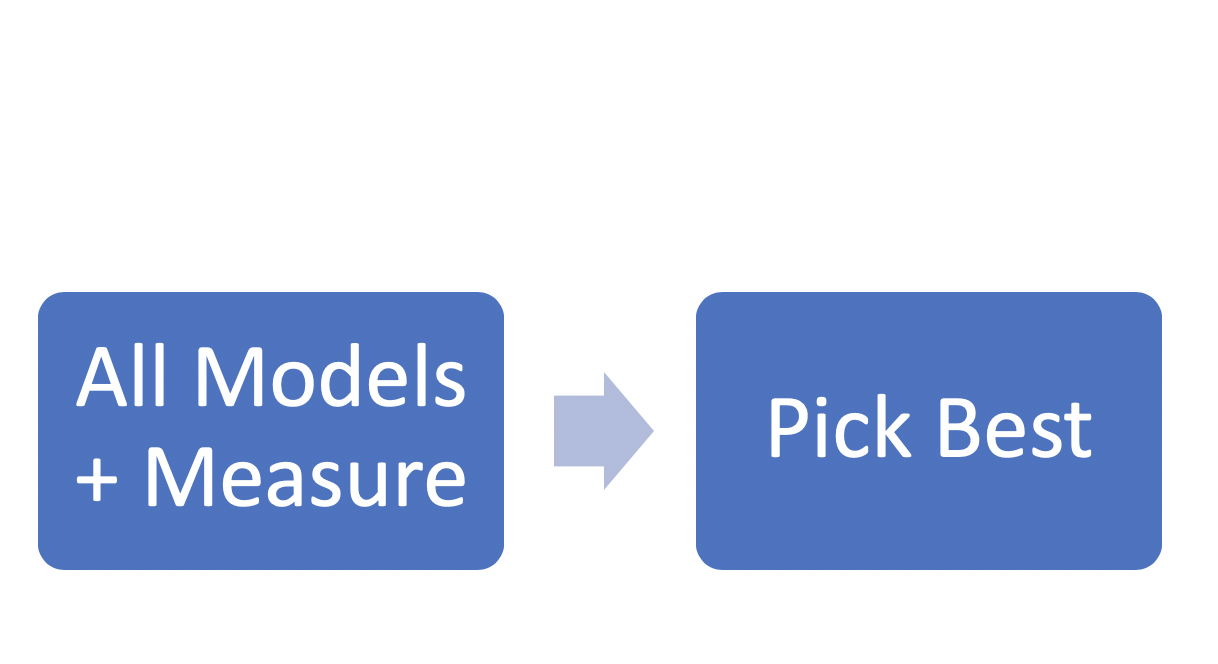
Jusqu'ici, tout relevait de la recherche non informée :
Recherche non informée : chaque itération d'ajustement d'hyperparamètres n'« apprend » pas des itérations précédentes.
C'est ce qui permet de paralléliser le travail. Mais est-ce vraiment efficace ?
Le processus jusqu'ici :

Une autre approche :
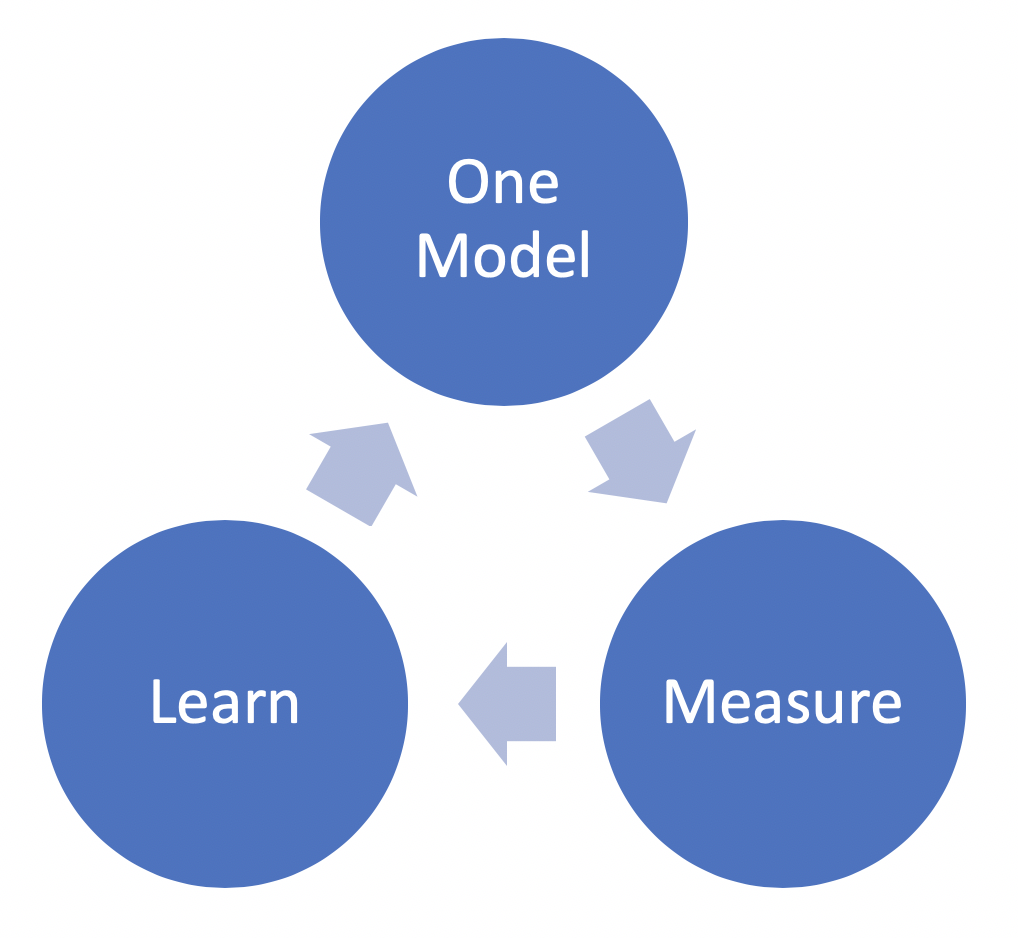
Une méthodologie informée simple :
Commencez large et aléatoire, puis affinez itérativement la recherche.
Le processus :
Vous pouvez remplacer (3) par d'autres recherches aléatoires avant la grille.
Le réglage du grossier au précis a des atouts :
Inutile d'explorer des espaces peu performants !
Remarque : l'information vient de lots de modèles, pas d'un seul.
Prenons un exemple avec ces plages d'hyperparamètres :
max_depth_list entre 1 et 65min_sample_list entre 3 et 17learn_rate_list 150 valeurs entre 0.01 et 150Combien de modèles possibles ?
combinations_list = [list(x) for x in product(max_depth_list, min_sample_list, learn_rate_list)]
print(len(combinations_list))
134400
Lançons une recherche aléatoire sur 500 combinaisons.
Voici la distribution des scores d'exactitude :
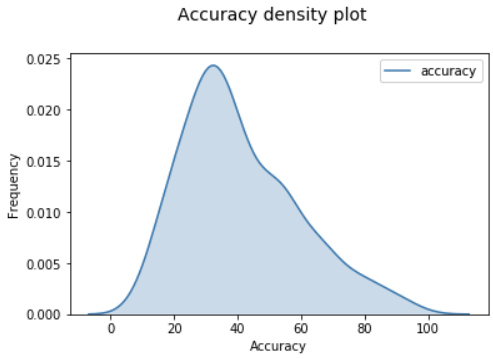
Quels modèles sont les meilleurs ?
Meilleurs résultats :
| max_depth | min_samples_leaf | learn_rate | accuracy |
|---|---|---|---|
| 10 | 7 | 0.01 | 96 |
| 19 | 7 | 0.023355705 | 96 |
| 30 | 6 | 1.038389262 | 93 |
| 27 | 7 | 1.11852349 | 91 |
| 16 | 7 | 0.597651007 | 91 |
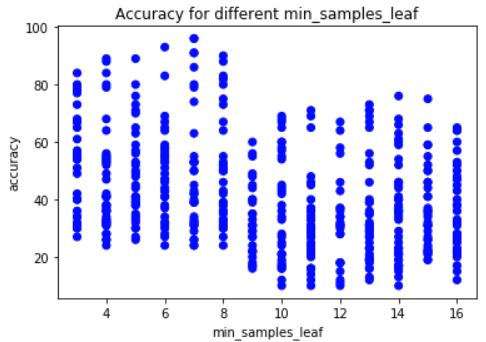
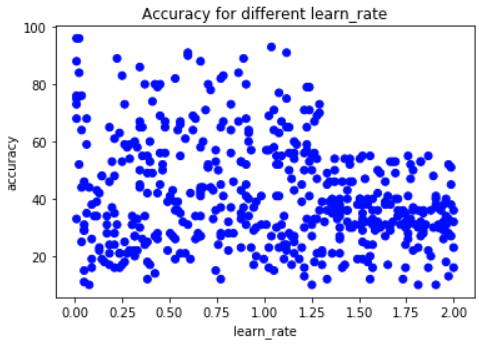
Visualisons max_depth vs le score d'exactitude :
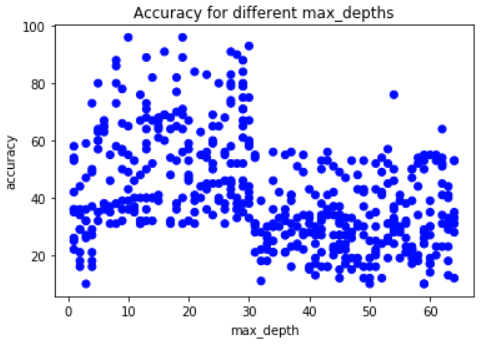
min_samples_leaf meilleur en dessous de 8
learn_rate moins bon au-dessus de 1.3
Ce que l'on retient de la première itération :
max_depth entre 8 et 30learn_rate inférieur à 1.3min_samples_leaf peut-être inférieur à 8Et maintenant ? Nouvelle recherche aléatoire ou en grille avec ces infos !
Remarque : ce n'était qu'une analyse bivariée. On peut explorer plusieurs hyperparamètres (3, 4 ou plus) sur un même graphique, mais cela dépasse le cadre de ce cours.
Optimisation des hyperparamètres en Python