Aperçu des hyperparamètres

Optimisation des hyperparamètres en Python

Alex Scriven

Data Scientist

Qu'est-ce qu'un hyperparamètre ?

Hyperparamètres :

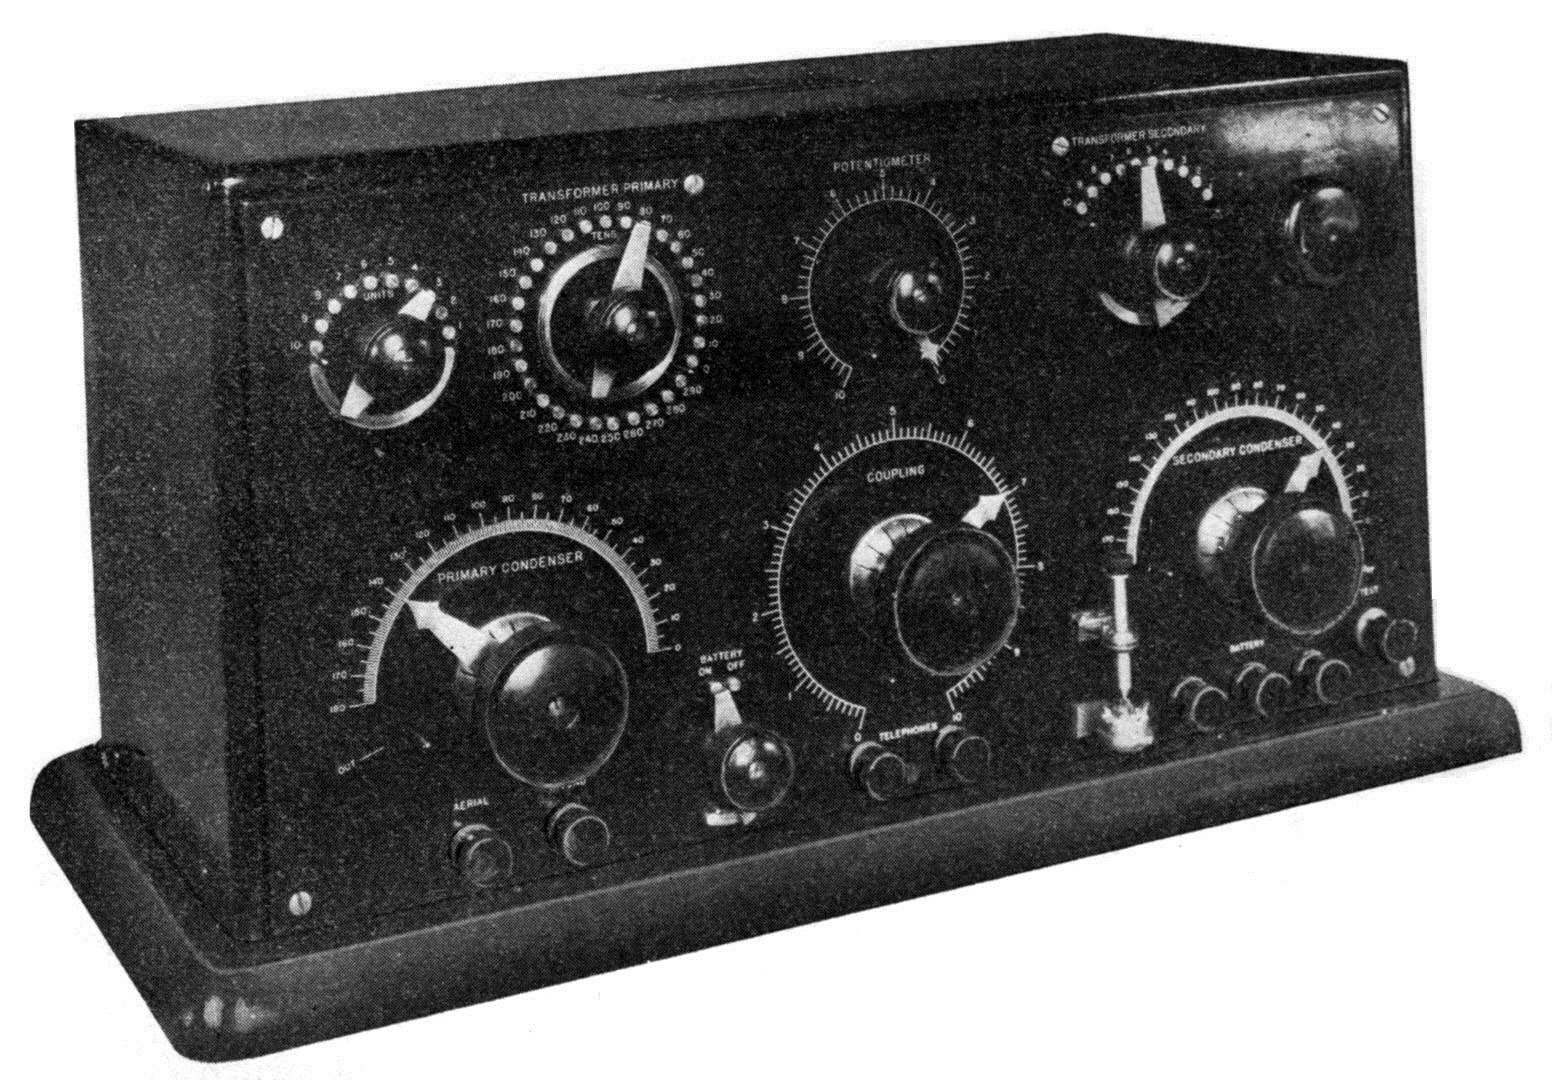
  • Paramètres que vous définissez avant l'entraînement (comme des boutons sur un vieux poste radio)
    • Vous pouvez aussi « régler » vos hyperparamètres !
  • L'algorithme ne les apprend pas

Vieux poste radio avec des boutons

Optimisation des hyperparamètres en Python

Hyperparamètres dans Random Forest

Créez un estimateur Random Forest simple et affichez-le :

rf_clf = RandomForestClassifier()
print(rf_clf)

RandomForestClassifier(n_estimators='warn', criterion='gini', max_depth=None, max_features='auto', max_leaf_nodes=None, min_impurity_decrease=0.0, min_impurity_split=None, min_samples_leaf=1, min_samples_split=2, min_weight_fraction_leaf=0.0, n_jobs=None, oob_score=False, random_state=None, verbose=0,bootstrap=True, class_weight=None, warm_start=False)

Plus d'infos : http://scikit-learn.org

Optimisation des hyperparamètres en Python

Un hyperparamètre isolé

Prenez le paramètre n_estimators.

Type et valeur par défaut :

n_estimators : entier, optionnel (par défaut = 10)

Définition :

Nombre d'arbres dans la forêt.

Optimisation des hyperparamètres en Python

Définir des hyperparamètres

Définissez quelques hyperparamètres à la création de l'estimateur :

rf_clf = RandomForestClassifier(n_estimators=100, criterion='entropy')
print(rf_clf)
RandomForestClassifier(n_estimators=100, criterion='entropy',
            max_depth=None, max_features='auto', max_leaf_nodes=None,
            min_impurity_decrease=0.0, min_impurity_split=None,
            min_samples_leaf=1, min_samples_split=2,
            min_weight_fraction_leaf=0.0, n_jobs=None,
            oob_score=False, random_state=None, verbose=0,bootstrap=True,
            class_weight=None, warm_start=False)
Optimisation des hyperparamètres en Python

Hyperparamètres en régression logistique

Trouvez les hyperparamètres d'une régression logistique :

log_reg_clf = LogisticRegression()

print(log_reg_clf) LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True, intercept_scaling=1, max_iter=100, multi_class='warn', n_jobs=None, penalty='l2', random_state=None, solver='warn', tol=0.0001, verbose=0, warm_start=False)

Il y a moins d'hyperparamètres à régler avec cet algorithme !

Optimisation des hyperparamètres en Python

Importance des hyperparamètres


Certains hyperparamètres sont plus importants que d'autres.

Certains n'améliorent pas les performances :

Pour le classifieur Random Forest :

  • n_jobs
  • random_state
  • verbose

Tous les hyperparamètres n'ont pas vocation à être « entraînés »

Optimisation des hyperparamètres en Python

Random Forest : hyperparamètres clés


Hyperparamètres importants :

  • n_estimators (valeur élevée)
  • max_features (tester plusieurs valeurs)
  • max_depth et min_sample_leaf (clé contre le surapprentissage)
  • (peut-être) criterion

Rappel : ce n'est qu'un guide

Optimisation des hyperparamètres en Python

Comment repérer les hyperparamètres importants ?


Ressources pour progresser :

  • Articles académiques
  • Blogs et tutoriels de sources fiables (comme DataCamp !)
  • Documentation de Scikit-learn
  • Expérience
Optimisation des hyperparamètres en Python

Passons à la pratique !

Optimisation des hyperparamètres en Python

Preparing Video For Download...