Optimisation des hyperparamètres en Python
Alex Scriven
Data Scientist
Analysons les sorties de GridSearchCV.
Trois groupes de propriétés pour GridSearchCV :
cv_results_best_index_, best_params_ et best_score_scorer_, n_splits_ et refit_time_
On accède aux propriétés avec la notation par point.
Par exemple :
grid_search_object.property
Où property est la propriété à récupérer.
La propriété cv_results_ :
Lisez-la dans un DataFrame pour l'afficher et l'analyser :
cv_results_df = pd.DataFrame(grid_rf_class.cv_results_)
print(cv_results_df.shape)
(12, 23)
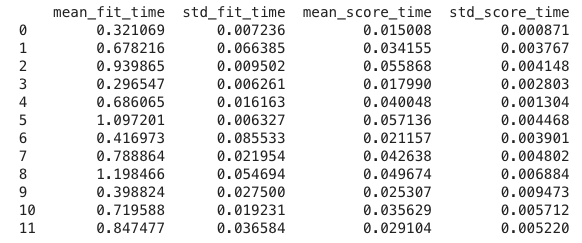
Les colonnes time indiquent le temps nécessaire pour entraîner (et évaluer) le modèle.
Souvenez-vous : nous avons fait une validation croisée en 5 plis. Cela s'exécute 5 fois et stocke la moyenne et l'écart type des temps en secondes.
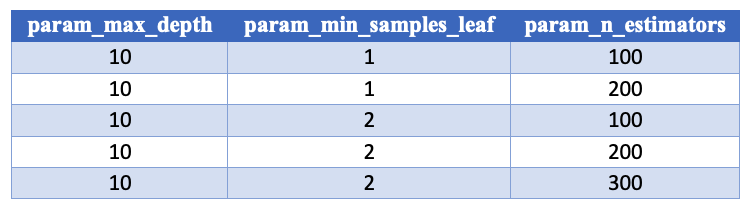
Les colonnes param_ stockent les hyperparamètres testés sur chaque ligne, une colonne par paramètre.
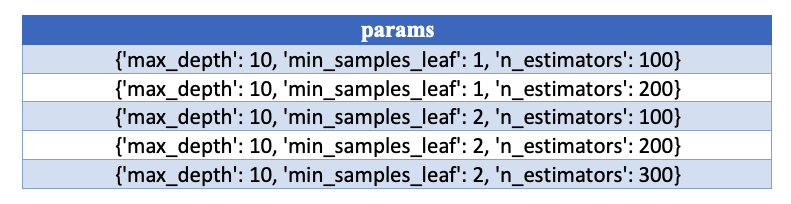
La colonne params contient le dictionnaire de tous les paramètres :
pd.set_option("display.max_colwidth", -1)
print(cv_results_df.loc[:, "params"])
Les colonnes test_score contiennent les scores sur notre jeu de test pour chaque pli, ainsi que des statistiques récapitulatives :
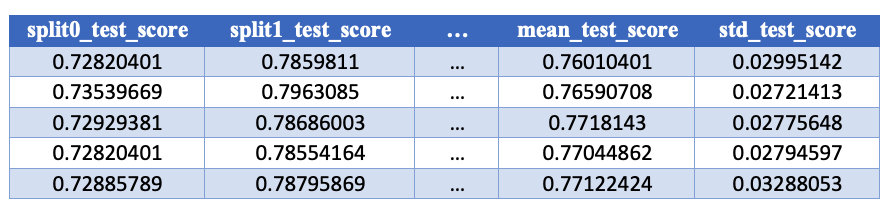
La colonne de rang ordonne mean_test_score du meilleur au moins bon :
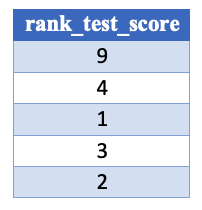
On peut sélectionner facilement la meilleure case de la grille depuis cv_results_ via la colonne rank_test_score
best_row = cv_results_df[cv_results_df["rank_test_score"] == 1]
print(best_row)
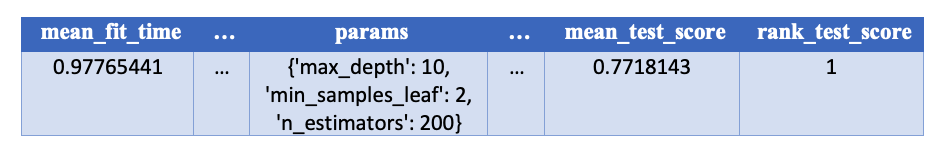
Les colonnes test_score sont ensuite dupliquées pour les training_scores.
Points importants à retenir :
return_train_score doit être à True pour inclure les colonnes d'entraînement.
Il n'y a pas de colonne de rang pour les scores d'entraînement, car seule la performance sur le test compte.
Les infos sur la meilleure case de grille sont résumées dans ces trois propriétés :
best_params_, le dictionnaire des paramètres donnant le meilleur score.
best_score_, le meilleur score obtenu.
best_index_, la ligne de cv_results_.rank_test_score correspondant au meilleur.
La propriété best_estimator_ est un estimateur entraîné avec les meilleurs paramètres trouvés.
Ici, c'est un estimateur Random Forest :
type(grid_rf_class.best_estimator_)
sklearn.ensemble.forest.RandomForestClassifier
Vous pouvez aussi utiliser directement cet objet comme estimateur si vous le souhaitez.
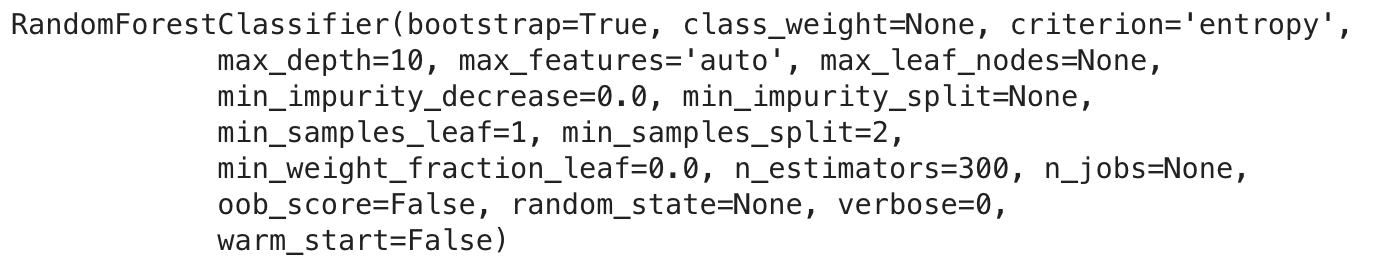
print(grid_rf_class.best_estimator_)

Des informations supplémentaires sont disponibles via :
scorer_Fonction d'évaluation utilisée sur les données de validation (nous l'avons réglée sur l'AUC).
n_splits_Nombre de divisions de validation croisée (réglé à 5).
refit_time_Temps (en secondes) pour réentraîner le meilleur modèle sur tout le jeu de données.
Optimisation des hyperparamètres en Python