Valeurs d'hyperparamètres

Optimisation des hyperparamètres en Python

Alex Scriven

Data Scientist

Valeurs d'hyperparamètres


Certains hyperparamètres sont prioritaires à régler en premier.

Mais quelles valeurs tester pour les hyperparamètres ?

  • Spécifiques à chaque algorithme et hyperparamètre
  • Il existe des bonnes pratiques et astuces

Voyons quelques conseils clés !

Optimisation des hyperparamètres en Python

Choix d'hyperparamètres incompatibles

Attention aux hyperparamètres incompatibles.

  • Options conflictuelles de solver et penalty dans LogisticRegression().
The 'newton-cg', 'sag' and 'lbfgs' solvers support only l2 penalties.

Parfois ce n'est pas explicite : ils sont juste « ignorés » (ex. ElasticNet avec l'hyperparamètre normalize) :

This parameter is ignored when fit_intercept is set to False

Consultez la documentation Scikit‑Learn !

Optimisation des hyperparamètres en Python

Valeurs d'hyperparamètres farfelues


Attention aux valeurs « farfelues » selon l'algorithme :

  • Random forest avec très peu d'arbres
    • Est‑ce vraiment une « forêt » avec seulement 2 arbres ?
  • 1 voisin dans l'algorithme KNN
    • Faire la moyenne des « votes » d'une seule personne n'est pas très robuste !
  • Augmenter un hyperparamètre d'une quantité infime

Documenter des valeurs raisonnables pour les hyperparamètres est un investissement utile.

Optimisation des hyperparamètres en Python

Automatiser le choix des hyperparamètres


Dans l'exercice précédent, nous avons construit des modèles ainsi :

knn_5 =  KNeighborsClassifier(n_neighbors=5)
knn_10 = KNeighborsClassifier(n_neighbors=10)
knn_20  = KNeighborsClassifier(n_neighbors=20)

C'est assez inefficace. Peut‑on faire mieux ?

Optimisation des hyperparamètres en Python

Automatiser l'ajustement des hyperparamètres

Essayez une boucle for pour parcourir les options :

neighbors_list = [3,5,10,20,50,75]

accuracy_list = []
for test_number in neighbors_list: model = KNeighborsClassifier(n_neighbors=test_number) predictions = model.fit(X_train, y_train).predict(X_test)
accuracy = accuracy_score(y_test, predictions) accuracy_list.append(accuracy)
Optimisation des hyperparamètres en Python

Automatiser l'ajustement des hyperparamètres

On peut stocker les résultats dans un DataFrame pour les visualiser :

results_df = pd.DataFrame({'neighbors':neighbors_list, 'accuracy':accuracy_list})
print(results_df)
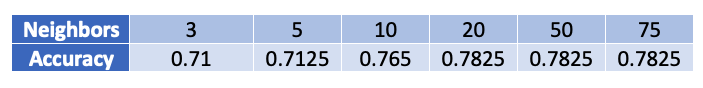
Précision selon le nombre de voisins : tableau

Optimisation des hyperparamètres en Python

Courbes d'apprentissage

Traçons une courbe d'apprentissage

Cette fois, testons bien plus de valeurs

neighbors_list = list(range(5,500, 5))

accuracy_list = [] for test_number in neighbors_list: model = KNeighborsClassifier(n_neighbors=test_number) predictions = model.fit(X_train, y_train).predict(X_test) accuracy = accuracy_score(y_test, predictions) accuracy_list.append(accuracy) results_df = pd.DataFrame({'neighbors':neighbors_list, 'accuracy':accuracy_list})
Optimisation des hyperparamètres en Python

Courbes d'apprentissage

Traçons le DataFrame plus grand :

plt.plot(results_df['neighbors'], 
    results_df['accuracy'])

# Ajouter les libellés et le titre plt.gca().set(xlabel='n_neighbors', ylabel='Accuracy', title='Accuracy for different n_neighbors') plt.show()
Optimisation des hyperparamètres en Python

Courbes d'apprentissage

Notre graphique :
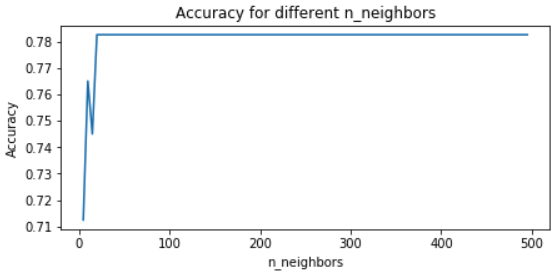
précision vs nombre de voisins : courbe d'apprentissage pour KNN

Optimisation des hyperparamètres en Python

Une astuce pour générer des valeurs

La fonction range de Python ne gère pas les pas décimaux.

Astuce pratique : utilisez np.linspace(start, end, num) de NumPy.

  • Crée un nombre de valeurs (num) uniformément espacées dans un intervalle (start, end) que vous précisez.
print(np.linspace(1,2,5))
[1.   1.25 1.5  1.75 2.  ]
Optimisation des hyperparamètres en Python

Passons à la pratique !

Optimisation des hyperparamètres en Python

Preparing Video For Download...