Recherche aléatoire dans Scikit Learn
Optimisation des hyperparamètres en Python

Alex Scriven
Data Scientist
Comparaison avec GridSearchCV
Inutile de réinventer la roue. Rappelons les étapes d'une recherche par grille :
- Choisir un algorithme/estimateur
- Définir les hyperparamètres à ajuster
- Définir un intervalle de valeurs pour chaque hyperparamètre
- Fixer un schéma de validation croisée ; et
- Définir une fonction de score
- Ajouter des infos ou fonctions utiles
Comparaison avec la recherche par grille
Il n'y a qu'une différence :
- Étape 7 = Déterminer combien d'échantillons prendre (puis échantillonner)
C'est tout ! (ou presque)
Comparer les modules Scikit Learn
Les modules sont proches aussi :
GridSearchCV :
sklearn.model_selection.GridSearchCV(estimator, param_grid,
        scoring=None, fit_params=None,
        n_jobs=None,
        refit=True, cv='warn', verbose=0,
        pre_dispatch='2*n_jobs',
        error_score='raise-deprecating',
        return_train_score='warn')
RandomizedSearchCV :
sklearn.model_selection.RandomizedSearchCV(estimator,
        param_distributions, n_iter=10,
        scoring=None, fit_params=None,
        n_jobs=None, refit=True,
        cv='warn', verbose=0,
        pre_dispatch='2*n_jobs',
        random_state=None,
        error_score='raise-deprecating',
        return_train_score='warn')
Différences clés
Deux différences clés :
n_iter: nombre d'échantillons tirés au hasard depuis votre grille. Dans l'exemple précédent, vous en avez pris 300.param_distributionsdiffère légèrement deparam_gridet permet, en option, de définir une distribution d'échantillonnage.- Par défaut, toutes les combinaisons ont la même probabilité d'être choisies.
Créer un objet RandomizedSearchCV
Nous pouvons maintenant créer un objet de recherche aléatoire comme pour la grille, avec une petite modification :
# Set up the sample space learn_rate_list = np.linspace(0.001,2,150) min_samples_leaf_list = list(range(1,51)) # Create the grid parameter_grid = { 'learning_rate' : learn_rate_list, 'min_samples_leaf' : min_samples_leaf_list}# Define how many samples number_models = 10
Créer un objet RandomizedSearchCV
Créons maintenant l'objet :
# Create a random search object
random_GBM_class = RandomizedSearchCV(
    estimator = GradientBoostingClassifier(),
    param_distributions = parameter_grid,
    n_iter = number_models,
    scoring='accuracy',
    n_jobs=4,
    cv = 10,
    refit=True,
    return_train_score = True)
# Fit the object to our data
random_GBM_class.fit(X_train, y_train)
Analyser la sortie
La sortie est identique !
Comment voir les hyperparamètres retenus ?
Le dictionnaire cv_results_ (dans les colonnes param_ concernées) !
Extraire les listes :
rand_x = list(random_GBM_class.cv_results_['param_learning_rate'])
rand_y = list(random_GBM_class.cv_results_['param_min_samples_leaf'])
Analyser la sortie
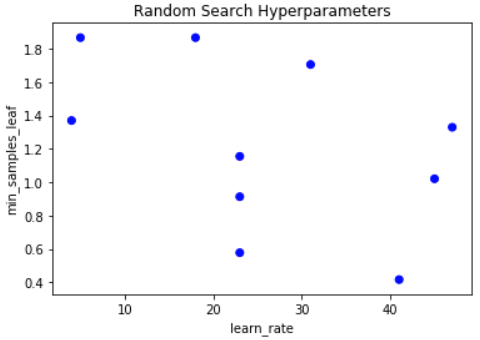
Construire notre visualisation :
# Make sure we set the limits of Y and X appriately x_lims = [np.min(learn_rate_list), np.max(learn_rate_list)] y_lims = [np.min(min_samples_leaf_list), np.max(min_samples_leaf_list)]# Plot grid results plt.scatter(rand_y, rand_x, c=['blue']*10) plt.gca().set(xlabel='learn_rate', ylabel='min_samples_leaf', title='Random Search Hyperparameters') plt.show()
Analyser la sortie
Un graphique similaire au précédent :
Passons à la pratique !
Optimisation des hyperparamètres en Python

