Bases de spaCy
Traitement du langage naturel avec spaCy

Azadeh Mobasher
Principal Data Scientist
Pipeline NLP de spaCy
import spacynlp = spacy.load("en_core_web_sm")doc = nlp("Here's my spaCy pipeline.")
- Importer
spaCy - Utiliser
spacy.load()pour obtenirnlp, une classeLanguage- L'objet
Languageest le pipeline de traitement du texte
- L'objet
- Appliquer
nlp()à un texte pour obtenir un conteneurDoc
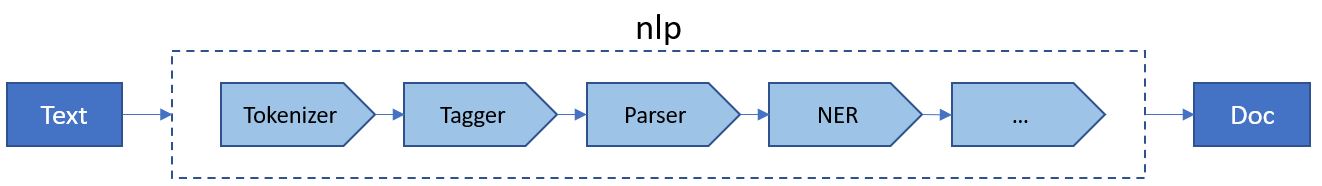
Pipeline NLP de spaCy
spaCy applique plusieurs étapes de traitement via sa classe Language :
Objets conteneurs dans spaCy
- Plusieurs structures de données représentent le texte dans
spaCy:
| Nom | Description |
|---|---|
Doc |
Conteneur donnant accès aux annotations linguistiques du texte |
Span |
Tranche d'un objet Doc |
Token |
Jeton individuel : mot, ponctuation, espace, etc. |
Composants du pipeline
- Le pipeline de traitement
spaCydépend toujours du modèle chargé et de ses capacités.
| Composant | Nom | Description |
|---|---|---|
| Tokenizer | Tokenizer | Segmenter le texte en jetons et créer l'objet Doc |
| Tagger | Tagger | Attribuer les étiquettes de parties du discours |
| Lemmatizer | Lemmatizer | Réduire les mots à leur forme de base |
| EntityRecognizer | NER | Détecter et étiqueter les entités nommées |
Composants du pipeline
Chaque composant offre des fonctions spécifiques pour traiter le texte
- Language
- DependencyParser
- Sentencizer
Tokenisation
- Toujours la première opération
- Toutes les autres opérations nécessitent des jetons
- Les jetons peuvent être des mots, des nombres ou de la ponctuation
import spacy nlp = spacy.load("en_core_web_sm") doc = nlp("Tokenization splits a sentence into its tokens.")print([token.text for token in doc])
['Tokenization', 'splits', 'a', 'sentence', 'into', 'its', 'tokens', '.']
Segmentation en phrases
- Plus complexe que la tokenisation
- Fait partie du composant
DependencyParser
import spacy nlp = spacy.load("en_core_web_sm") text = "We are learning NLP. This course introduces spaCy." doc = nlp(text)for sent in doc.sents: print(sent.text)
We are learning NLP.
This course introduces spaCy.
Lemmatisation
- Un lemme est la forme de base d'un jeton
- Le lemme de eats et ate est eat
- Améliore la précision des modèles de langue
import spacy nlp = spacy.load("en_core_web_sm") doc = nlp("We are seeing her after one year.")print([(token.text, token.lemma_) for token in doc])
[('We', 'we'), ('are', 'be'), ('seeing', 'see'), ('her', 'she'),
('after', 'after'), ('one', 'one'), ('year', 'year'), ('.', '.')]
Passons à la pratique !
Traitement du langage naturel avec spaCy

