Traitement du langage naturel avec spaCy
Azadeh Mobasher
Principal Data Scientist
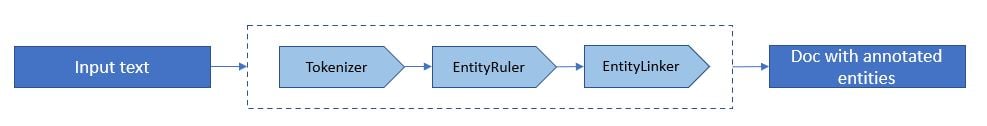
spaCy commence par tokenizer le texte pour produire un objet DocDoc est traité en plusieurs étapes d'une pipeline de traitement
import spacy
nlp = spacy.load("en_core_web_sm")
doc = nlp(example_text)
spaCy pour NER :print([ent.text for ent in doc.ents])
sentencizer : composant de pipeline spaCy pour la segmentation en phrases.text = " ".join(["This is a test sentence."]*10000)en_core_sm_nlp = spacy.load("en_core_web_sm") start_time = time.time() doc = en_core_sm_nlp(text)print(f"Finished processing with en_core_web_sm model in {round((time.time() - start_time)/60.0 , 5)} minutes")
>>> Finished processing with en_core_web_sm model in 0.09332 minutes
sentencizer :blank_nlp = spacy.blank("en")blank_nlp.add_pipe("sentencizer")start_time = time.time() doc = blank_nlp(text) print(f"Finished processing with blank model in {round((time.time() - start_time)/60.0 , 5)} minutes")
>>> Finished processing with blank model in 0.00091 minutes
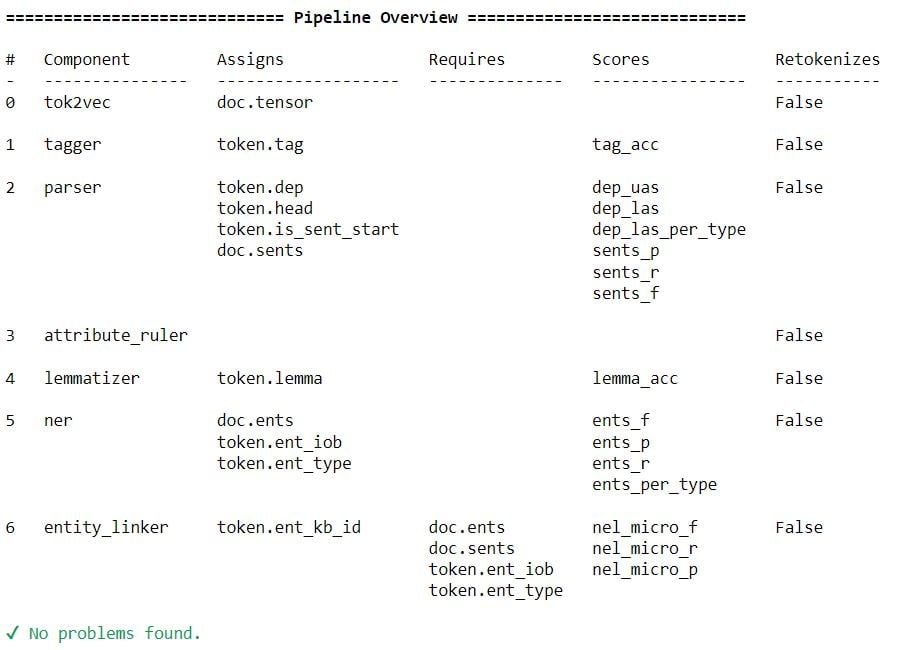
nlp.analyze_pipes() analyse une pipeline spaCy pour déterminer :
pretty à True affiche un tableau au lieu de retourner seulement les données structurées.import spacy
nlp = spacy.load("en_core_web_sm")
analysis = nlp.analyze_pipes(pretty=True)
Traitement du langage naturel avec spaCy