Croyance a priori

Analyse de données bayésienne en Python

Michal Oleszak

Machine Learning Engineer

Loi a priori

  • La loi a priori reflète ce que nous savons du paramètre avant d'observer des données :
    • rien   →   loi uniforme (toutes les valeurs sont aussi probables)
    • ancien a posteriori   →   se met à jour avec de nouvelles données


  • On peut choisir n'importe quelle loi de probabilité comme a priori pour intégrer des infos externes au modèle :
    • avis d'expert
    • savoir commun
    • recherches antérieures
    • croyance subjective
Analyse de données bayésienne en Python

Impact de l'a priori

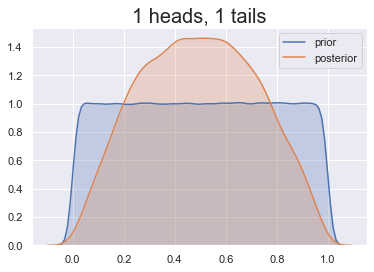
Deux courbes de densité superposées : l'une pour l'a priori, l'autre pour l'a posteriori. L'a priori est uniforme, l'a posteriori est en cloche, un peu plus haut.

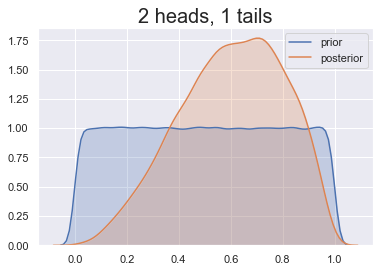
Deux courbes de densité superposées : l'une pour l'a priori, l'autre pour l'a posteriori. L'a priori est uniforme, l'a posteriori est en cloche, un peu plus haut et asymétrique à droite.

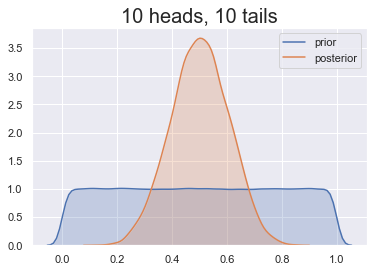
Deux courbes de densité superposées : l'une pour l'a priori, l'autre pour l'a posteriori. L'a priori est uniforme, l'a posteriori est en cloche, bien plus haut.

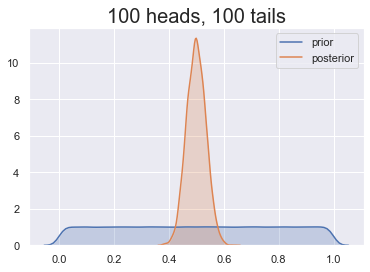
Deux courbes de densité superposées : l'une pour l'a priori, l'autre pour l'a posteriori. L'a priori est uniforme, l'a posteriori est en cloche, beaucoup plus haut.

Analyse de données bayésienne en Python

Loi a priori

  • L'a priori est choisi avant de voir les données.
  • Ce choix peut influer sur l'a posteriori (surtout avec peu de données).
  • Pour éviter le tri sélectif, les choix d'a priori doivent être :
    • explicités clairement,
    • justifiables : fondés sur des recherches antérieures, des hypothèses raisonnables, un avis d'expert, etc.
Analyse de données bayésienne en Python

Choisir le bon a priori

Notre croyance a priori : pile moins probable
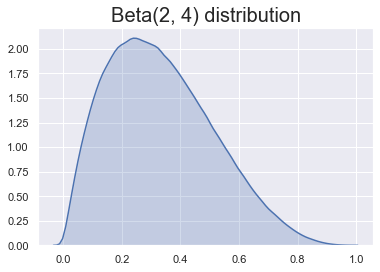
Une courbe de densité en cloche, asymétrique à gauche, avec un pic vers 0,25.

Certains choix sont meilleurs que d'autres !
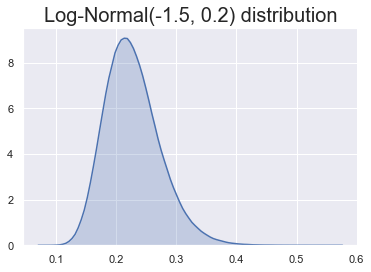
 

Une courbe de densité en cloche, asymétrique à gauche, avec un pic vers 0,25, un peu plus étroite que la précédente.

Analyse de données bayésienne en Python

A priori conjugués

  • Certains a priori, multipliés par des vraisemblances données, donnent des a posteriori connus.
  • On les appelle des a priori conjugués.
  • Pour le lancer de pièce :
    • si l'on choisit un a priori Beta(a, b),
    • alors l'a posteriori est Beta(#piles + a, #lancers - #piles + b)
  • On peut échantillonner l'a posteriori avec numpy.
  • get_heads_prob() du chapitre 1 :
    def get_heads_prob(tosses):
      num_heads = np.sum(tosses)
      # prior: Beta(1,1)
      return np.random.beta(num_heads + 1, len(tosses) - num_heads + 1, 1000)
    
Analyse de données bayésienne en Python

Deux façons d'obtenir l'a posteriori

Simulation

  • Si l'a posteriori est connu, on peut y échantillonner avec numpy :
    draws = np.random.beta(2, 4, 1000)
    
  • Résultat : un tableau de 1000 tirages a posteriori :
    array([0.05941031, ..., 0.70015975])
    
  • Peut être tracé avec
    sns.kdeplot(draws)
    

Calcul

  • Si l'a posteriori est inconnu, on peut le calculer par approximation sur grille.
  • Résultat : probabilité a posteriori pour chaque élément de la grille :
           head_prob  posterior_prob
    0           0.00        0.009901
    1           0.01        0.003624
               ...           ...
    10199       0.99        0.003624
    10200       1.00        0.009901
    
  • Peut être tracé avec
    sns.lineplot(df["head_prob"], df["posterior_prob"])
    
Analyse de données bayésienne en Python

Passons à la pratique !

Analyse de données bayésienne en Python

Preparing Video For Download...