Analyse de données bayésienne en Python
Michal Oleszak
Machine Learning Engineer
posterior_draws
array([8.02800413, 8.97359548, 7.57437476, ..., 5.85264609, 7.92875104,
7.41463758])
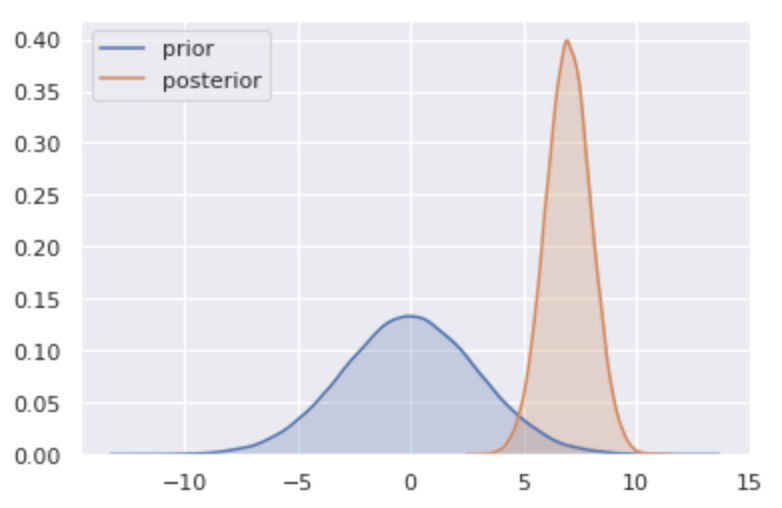
sns.kdeplot(prior_draws, shade=True, label="prior")
sns.kdeplot(posterior_draws, shade=True, label="posterior")


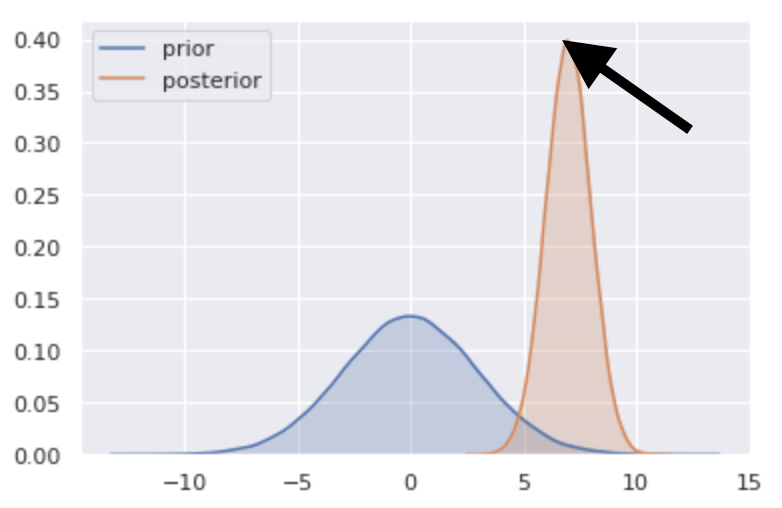
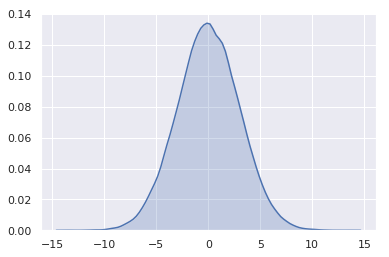
Aucun nombre unique ne résume toute l'information d'une distribution
Mais il faut parfois une estimation ponctuelle d'un paramètre

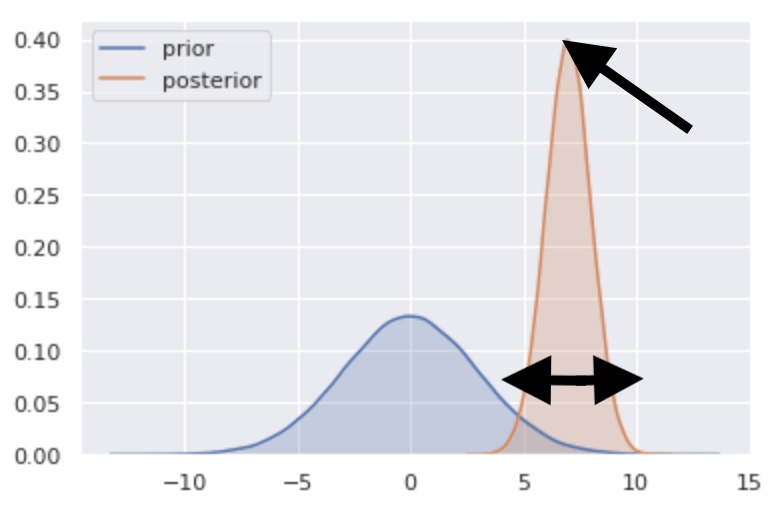
Aucun nombre unique ne résume toute l'information d'une distribution
Mais il faut parfois une estimation ponctuelle d'un paramètre
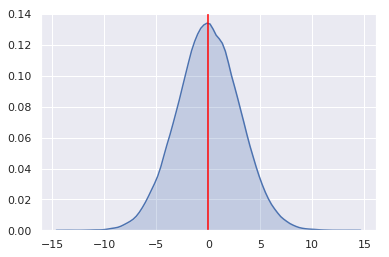
posterior_mean = np.mean(posterior_draws)

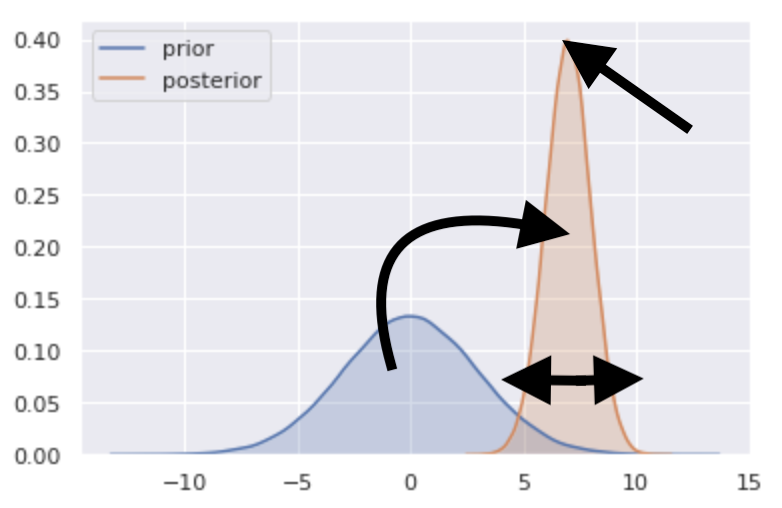
Aucun nombre unique ne résume toute l'information d'une distribution
Mais il faut parfois une estimation ponctuelle d'un paramètre
posterior_mean = np.mean(posterior_draws)
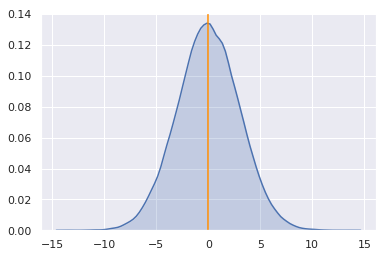
posterior_median = np.median(posterior_draws)

Aucun nombre unique ne résume toute l'information d'une distribution
Mais il faut parfois une estimation ponctuelle d'un paramètre
posterior_mean = np.mean(posterior_draws)
posterior_median = np.median(posterior_draws)
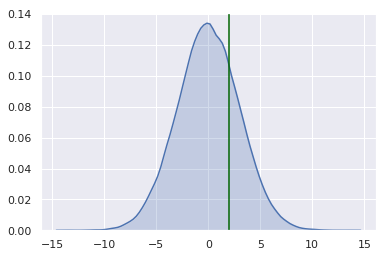
posterior_p75 = np.percentile(posterior_draws, 75)


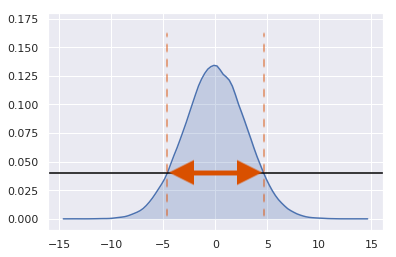
import arviz as az
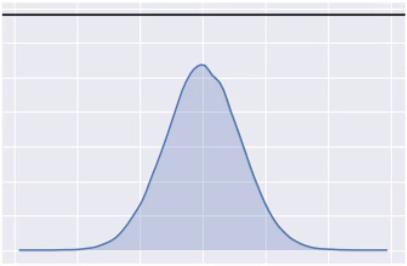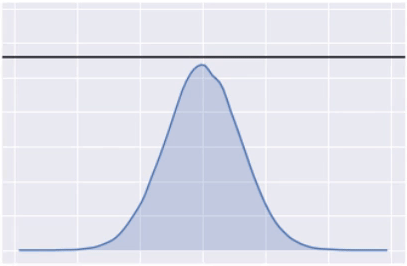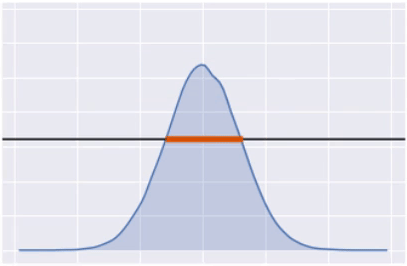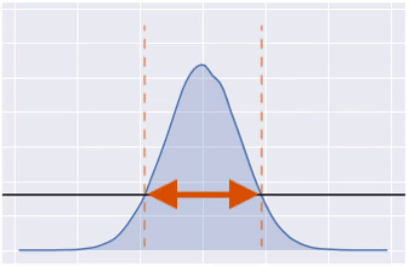
hpd = az.hdi(posterior_draws,
hdi_prob=0.9)
print(hpd)
[-4.86840193 4.96075498]
Analyse de données bayésienne en Python