Introduction à la modélisation linéaire en Python
Jason Vestuto
Data Scientist


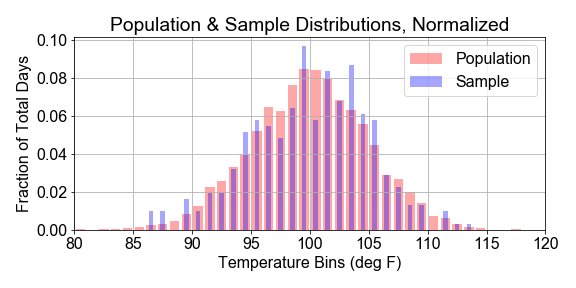
# Utiliser l'échantillon comme modèle de la population
population_model = august_daily_highs_for_2017
# Simuler des acquisitions répétées en rééchantillonnant le "modèle"
for nr in range(num_resamples):
bootstrap_sample = np.random.choice(population_model, size=resample_size, replace=True)
bootstrap_means[nr] = np.mean(bootstrap_sample)
# Calculer la moyenne de la distribution des moyennes bootstrap
estimate_temperature = np.mean(bootstrap_means)
# Calculer l'écart-type de la distribution des moyennes bootstrap
estimate_uncertainty = np.std(bootstrap_means)
# Définir l'échantillon de notes
sample = ['A', 'B', 'C', 'D', 'E', 'F', 'G']
# replace = True, répétitions autorisées
bootstrap_sample = np.random.choice(sample, size=4, replace=True)
print(bootstrap_sample)
C C F G
# replace = False
bootstrap_sample = np.random.choice(sample, size=4, replace=False)
print(bootstrap_sample)
C G A F
# replace = True, échantillons plus longs possibles
bootstrap_sample = np.random.choice(sample, size=16, replace=True)
print(bootstrap_sample)
C C F G C G A E F D G B B A E C
Introduction à la modélisation linéaire en Python