Erreurs de modèle et hasard

Introduction à la modélisation linéaire en Python

Jason Vestuto

Data Scientist

Types d'erreurs

  1. Erreurs de mesure
    • ex. : capteur défectueux, mesures mal saisies
  2. Biais d'échantillonnage
    • ex. : températures uniquement en août, quand il fait le plus chaud
  3. Hasard
Introduction à la modélisation linéaire en Python

Hypothèse nulle

Question : notre effet est-il dû à une relation ou au hasard ?

Réponse : vérifier l'hypothèse nulle.

Introduction à la modélisation linéaire en Python

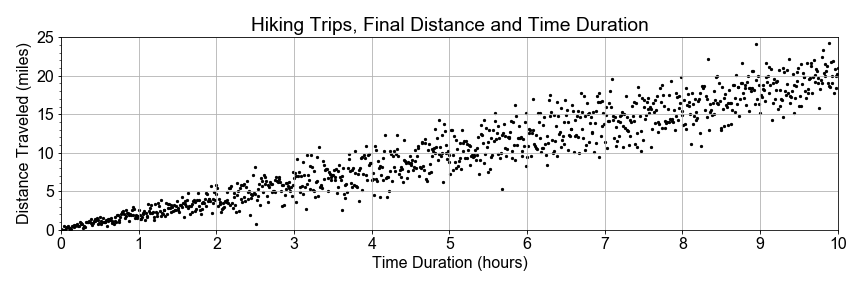
Données ordonnées

Nuage de points de données de randonnée, axes distance parcourue en miles et durée en heures

Introduction à la modélisation linéaire en Python

Regrouper les données

Nuage de points de données de randonnée, axes distance en miles et durée en heures, durées < 5 h en rouge, > 5 h en bleu

Introduction à la modélisation linéaire en Python

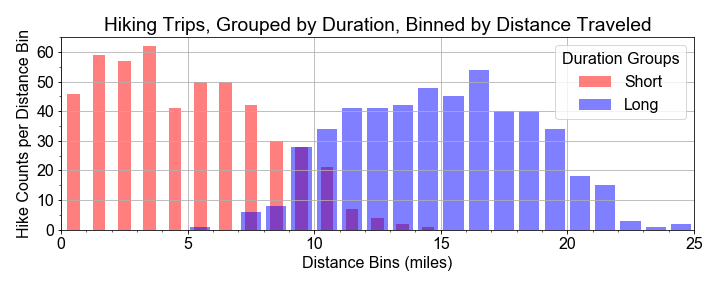
Regrouper les données

Deux histogrammes en cloche : rouge pour les durées courtes centré vers 5 miles, bleu pour les durées longues centré vers 15 miles

  • Groupe « Durée courte », moyenne = 5
  • Groupe « Durée longue », moyenne = 15
Introduction à la modélisation linéaire en Python

Statistique de test

# Group into early and late times
group_short = sample_distances[times < 5]
group_long = sample_distances[times > 5]
# Resample distributions
resample_short = np.random.choice(group_short, size=500, replace=True)
resample_long = np.random.choice(group_long, size=500, replace=True)
# Test Statistic
test_statistic = resample_long - resample_short
# Effect size as mean of test statistic distribution
effect_size = np.mean(test_statistic)
Introduction à la modélisation linéaire en Python

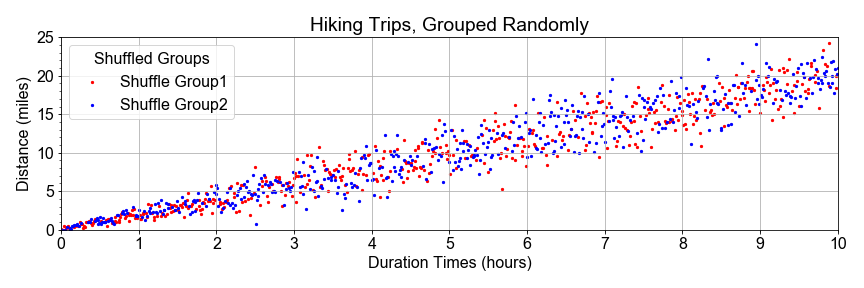
Mélanger et regrouper

Nuage de points de données de randonnée, axes distance en miles et durée en heures, avec rouge et bleu mêlés pour toutes les durées

Introduction à la modélisation linéaire en Python

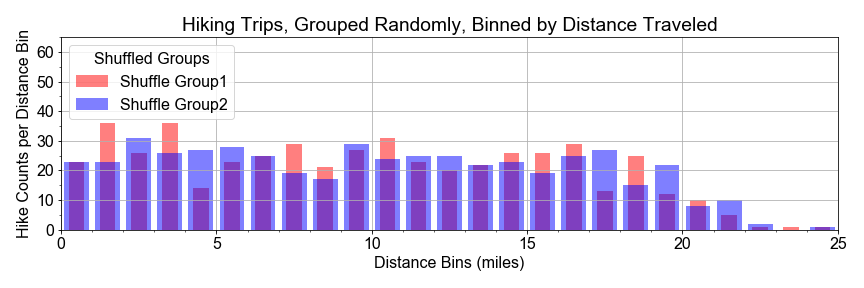
Mélange et nouveau regroupement

Deux histogrammes quasi superposés, de 0 à 25 miles, de forme semblable

Introduction à la modélisation linéaire en Python

Mélanger et découper

# Concatenate and Shuffle
shuffle_bucket = np.concatenate((group_short, group_long))
np.random.shuffle(shuffle_bucket)
# Split in the middle
slice_index = len(shuffle_bucket)//2
shuffled_half1 = shuffle_bucket[0:slice_index]
shuffled_half2 = shuffle_bucket[slice_index+1:]
Introduction à la modélisation linéaire en Python

Rééchantillonner et retester

# Resample shuffled populations
shuffled_sample1 = np.random.choice(shuffled_half1, size=500, replace=True)
shuffled_sample2 = np.random.choice(shuffled_half2, size=500, replace=True)
# Recompute effect size
shuffled_test_statistic = shuffled_sample2 - shuffled_sample1
effect_size = np.mean(shuffled_test_statistic)
Introduction à la modélisation linéaire en Python

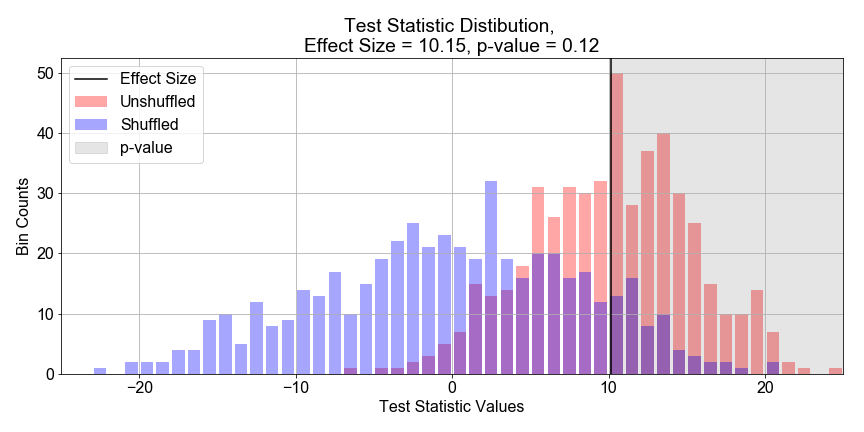
Valeur p

Histogrammes des valeurs de la statistique de test : en bleu centré sur x=0 et large, en rouge centré sur x=10 plus étroit, avec une ligne verticale noire à x=10

Introduction à la modélisation linéaire en Python

Passons à la pratique !

Introduction à la modélisation linéaire en Python

Preparing Video For Download...