Concevoir des expériences reproductibles

Développer des modèles de Machine Learning pour la production

Sinan Ozdemir

Data Scientist and Author

Expériences reproductibles

  • Garantir la précision et la fiabilité.
  • Faciliter la réplication des résultats.
  • Favoriser une meilleure collaboration.
  • Réduire le risque de biais dans les modèles de ML.
  • Renforcer l'intégrité du processus de recherche.
Développer des modèles de Machine Learning pour la production

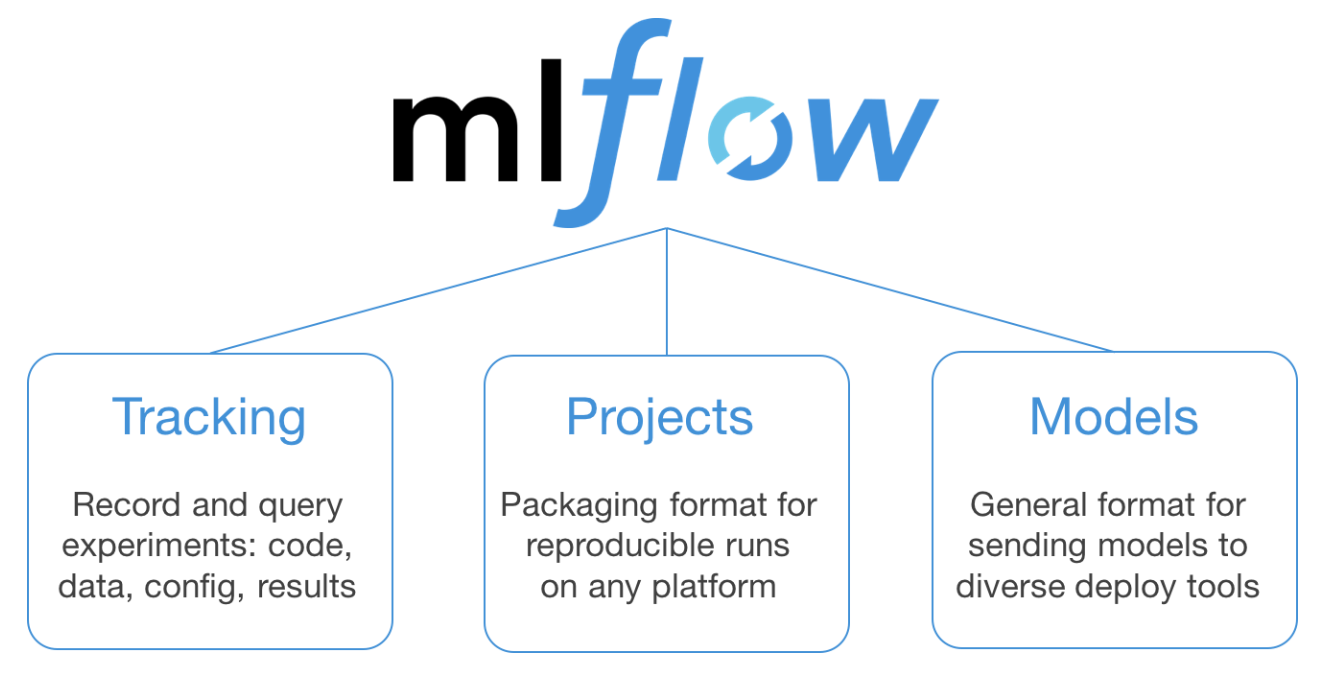
MLflow

Une plateforme open source pour suivre et gérer les expériences de Machine Learning. MLflow permet de :

  • Créer des pipelines ML reproductibles
  • Suivre et gérer :
    • les dépendances des packages
    • les versions de code
    • les paramètres d'expérience
  • Permettre l'accès aux expériences par plusieurs utilisateurs

mlflow

1 https://www.databricks.com/blog/2018/06/05/introducing-mlflow-an-open-source-machine-learning-platform.html
Développer des modèles de Machine Learning pour la production

Exemple d'utilisation de MLflow

# standard scikit-learn imports
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# new imports from MLflow
import mlflow
import mlflow.sklearn
Développer des modèles de Machine Learning pour la production

Exemple d'utilisation de MLflow (suite)

with mlflow.start_run():  # Start an MLflow run assuming we have data prepared

    # Build and train model
    rf = RandomForestClassifier()
    rf.fit(X_train, y_train)

    # Log parameters and model information
    mlflow.log_param("n_estimators", rf.n_estimators)
    mlflow.sklearn.log_model(rf, "model")

    y_pred = rf.predict(X_test)  # Evaluate model
    accuracy = accuracy_score(y_test, y_pred)
    mlflow.log_metric("accuracy", accuracy)  # log the test accuracy metric
Développer des modèles de Machine Learning pour la production

Suivi du code

  • Consigner les versions et changements de code avec MLflow
  • Comparer différentes versions de code
  • Identifier la version de code utilisée pour un jeu de résultats donné
  • Reproduire facilement des expériences
  • Faciliter le débogage et la résolution de problèmes
Développer des modèles de Machine Learning pour la production

Registres de modèles

  • Référentiel centralisé de modèles et de leurs métadonnées
  • MLflow permet d'enregistrer, stocker et comparer différentes versions de modèles
  • Reproduire des pipelines ML complets
  • Comparer des modèles
  • Garantir la précision et la fiabilité des modèles
stockage

Développer des modèles de Machine Learning pour la production

Reproductibilité des expériences

  • Suivre et consigner les données d'entrée, le code et les paramètres
  • Reproduire des pipelines ML complets
  • Renforcer la confiance dans les résultats des modèles de Machine Learning
  • Permettre à d'autres de vérifier et d'étendre le travail
  • Assurer la cohérence des résultats entre exécutions

Développer des modèles de Machine Learning pour la production

Revoir la documentation

  • La documentation est essentielle à une ML reproductible et doit inclure :
    • Les données d'entrée des modèles.
    • Le code utilisé pour créer les modèles.
    • Les paramètres utilisés dans une expérience.
    • Les résultats de l'expérience (modèle choisi, etc.)
  • La documentation doit être accessible
  • Elle doit constituer un enregistrement complet de l'expérience
Développer des modèles de Machine Learning pour la production

Passons à la pratique !

Développer des modèles de Machine Learning pour la production

Preparing Video For Download...