Augmenter les détections réussies grâce au rééchantillonnage des données

Détection de fraude en Python

Charlotte Werger

Data Scientist

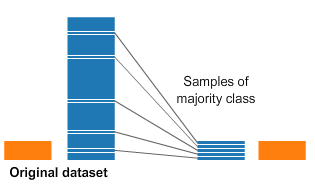
Sous-échantillonnage
Détection de fraude en Python

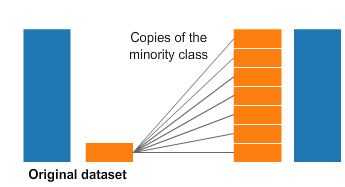
Sur-échantillonnage

Détection de fraude en Python

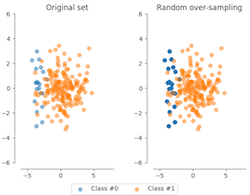
Sur-échantillonnage en Python

from imblearn.over_sampling import RandomOverSampler

method = RandomOverSampler() X_resampled, y_resampled = method.fit_resample(X, y)
compare_plots(X_resampled, y_resampled, X, y)
Détection de fraude en Python

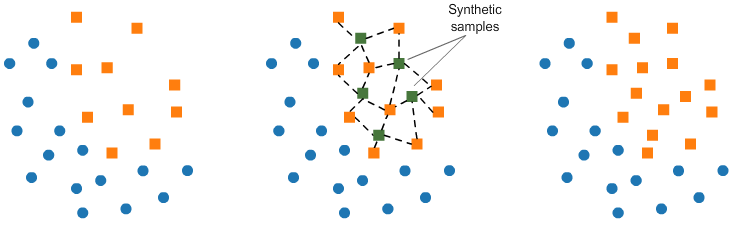
Synthetic Minority Oversampling Technique (SMOTE)
1 https://www.kaggle.com/rafjaa/resampling-strategies-for-imbalanced-datasets
Détection de fraude en Python

Quelle méthode de rééchantillonnage utiliser ?

  • Random Under Sampling (RUS) : élimine des données, efficace en calcul
  • Random Over Sampling (ROS) : simple et direct, mais entraîne sur de nombreux doublons
  • Synthetic Minority Oversampling Technique (SMOTE) : jeu de données plus sophistiqué et réaliste, mais vous entraînez sur des données « fausses »
Détection de fraude en Python

Quand utiliser le rééchantillonnage

from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression

# Define resampling method and split into train and test method = SMOTE() X_train, X_test, y_train, y_test = train_test_split(X, y, train_size=0.8, random_state=0)
# Apply resampling to the training data only X_resampled, y_resampled = method.fit_resample(X_train, y_train)
# Continue fitting the model and obtain predictions model = LogisticRegression() model.fit(X_resampled, y_resampled)
# Get your performance metrics predicted = model.predict(X_test) print (classification_report(y_test, predicted))
Détection de fraude en Python

Passons à la pratique !

Détection de fraude en Python

Preparing Video For Download...