Autres méthodes de détection de fraude par regroupement

Détection de fraude en Python

Charlotte Werger

Data Scientist

De nombreuses méthodes de regroupement existent
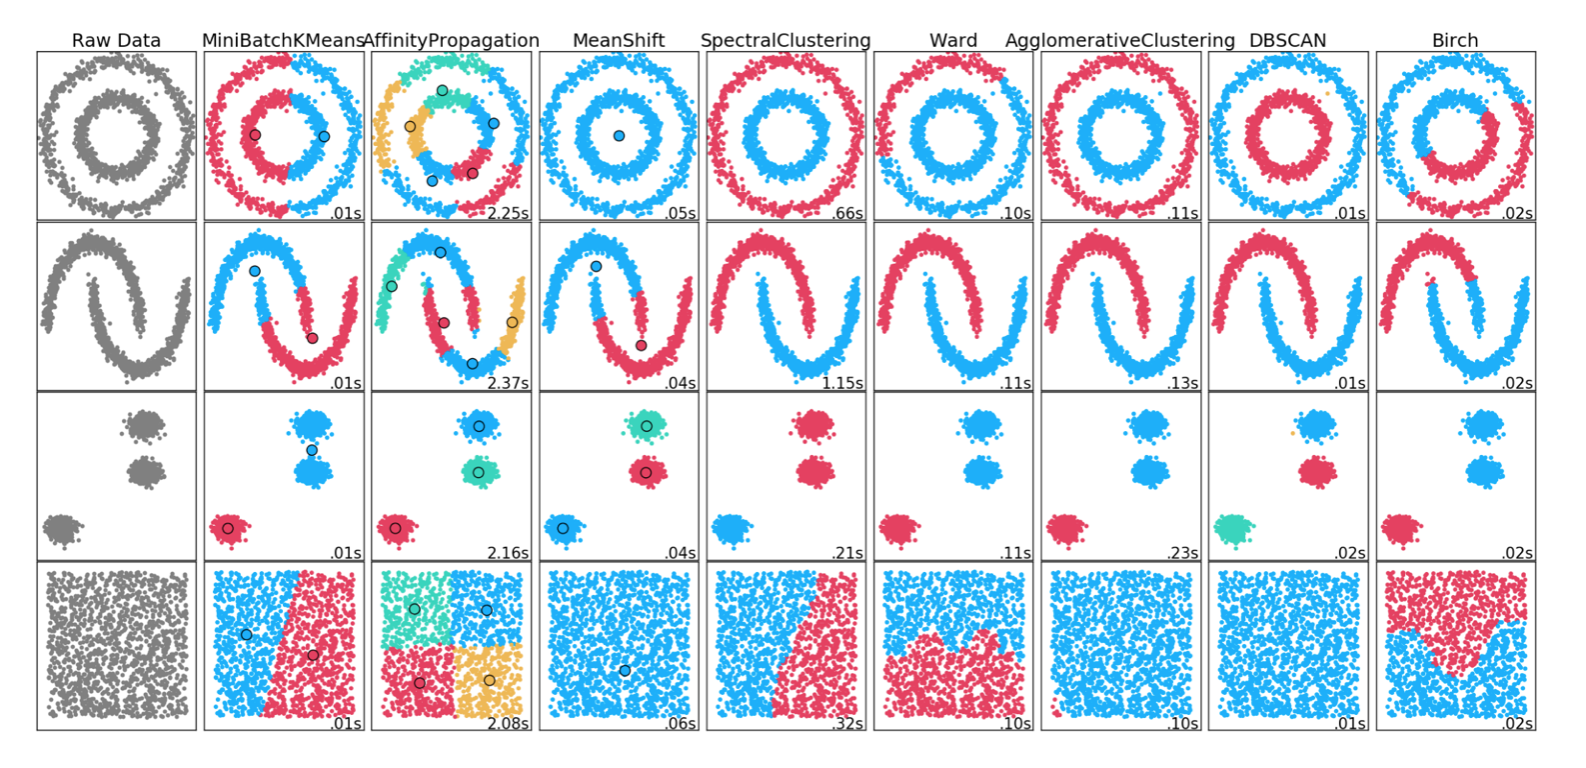
Détection de fraude en Python

Et plusieurs façons de signaler la fraude : utiliser les plus petits groupes
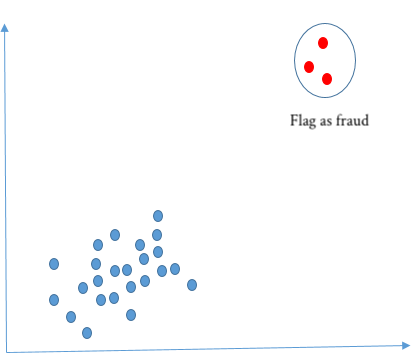
Détection de fraude en Python

En pratique, cela ressemble plutôt à ceci
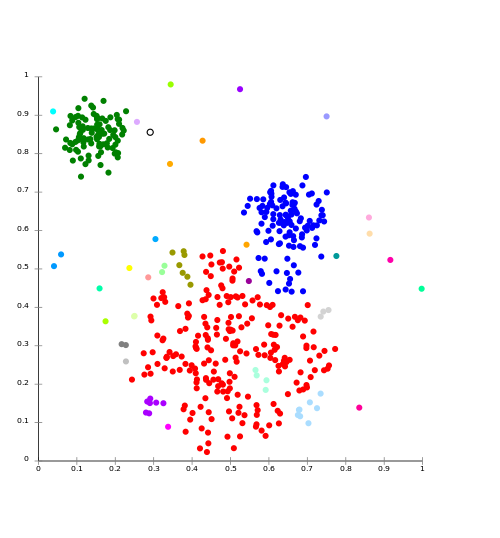
Détection de fraude en Python

DBSCAN versus K-means

  • Pas besoin de prédéfinir le nombre de groupes
  • Régler la distance maximale entre points d'un même groupe
  • Fixer un nombre minimal d'observations par groupe
  • Meilleures performances sur des formes atypiques
  • Mais… coût de calcul plus élevé
Détection de fraude en Python

Implémenter DBSCAN

from sklearn.cluster import DBSCAN
db = DBSCAN(eps=0.5, min_samples=10, n_jobs=-1).fit(X_scaled)

# Get the cluster labels (aka numbers) pred_labels = db.labels_
# Count the total number of clusters n_clusters_ = len(set(pred_labels)) - (1 if -1 in pred_labels else 0) # Print model results print('Estimated number of clusters: %d' % n_clusters_)
Estimated number of clusters: 31
Détection de fraude en Python

Vérifier la taille des groupes

# Print model results
print("Silhouette Coefficient: %0.3f" % metrics.silhouette_score(X_scaled, pred_labels))
Silhouette Coefficient: 0.359
# Get sample counts in each cluster 
counts = np.bincount(pred_labels[pred_labels>=0])
print (counts)
[ 763  496  840  355 1086  676   63  306  560  134   28   18  262  128  332  22  
   22   13   31   38   36   28   14   12   30   10   11   10   21   10    5]
Détection de fraude en Python

Passons à la pratique !

Détection de fraude en Python

Preparing Video For Download...