Modélisation de thèmes sur la fraude

Détection de fraude en Python

Charlotte Werger

Data Scientist

Modélisation de thèmes : révéler des motifs cachés dans les textes

  1. Découvrir des thèmes dans des textes
  2. « De quoi parle le texte »
  3. Concept proche du clustering
  4. Comparer les thèmes des fraudes vs non-fraudes et les utiliser comme variable ou indicateur
  5. Ou… un thème particulier semble-t-il signaler une fraude ?
Détection de fraude en Python

Latent Dirichlet Allocation (LDA)

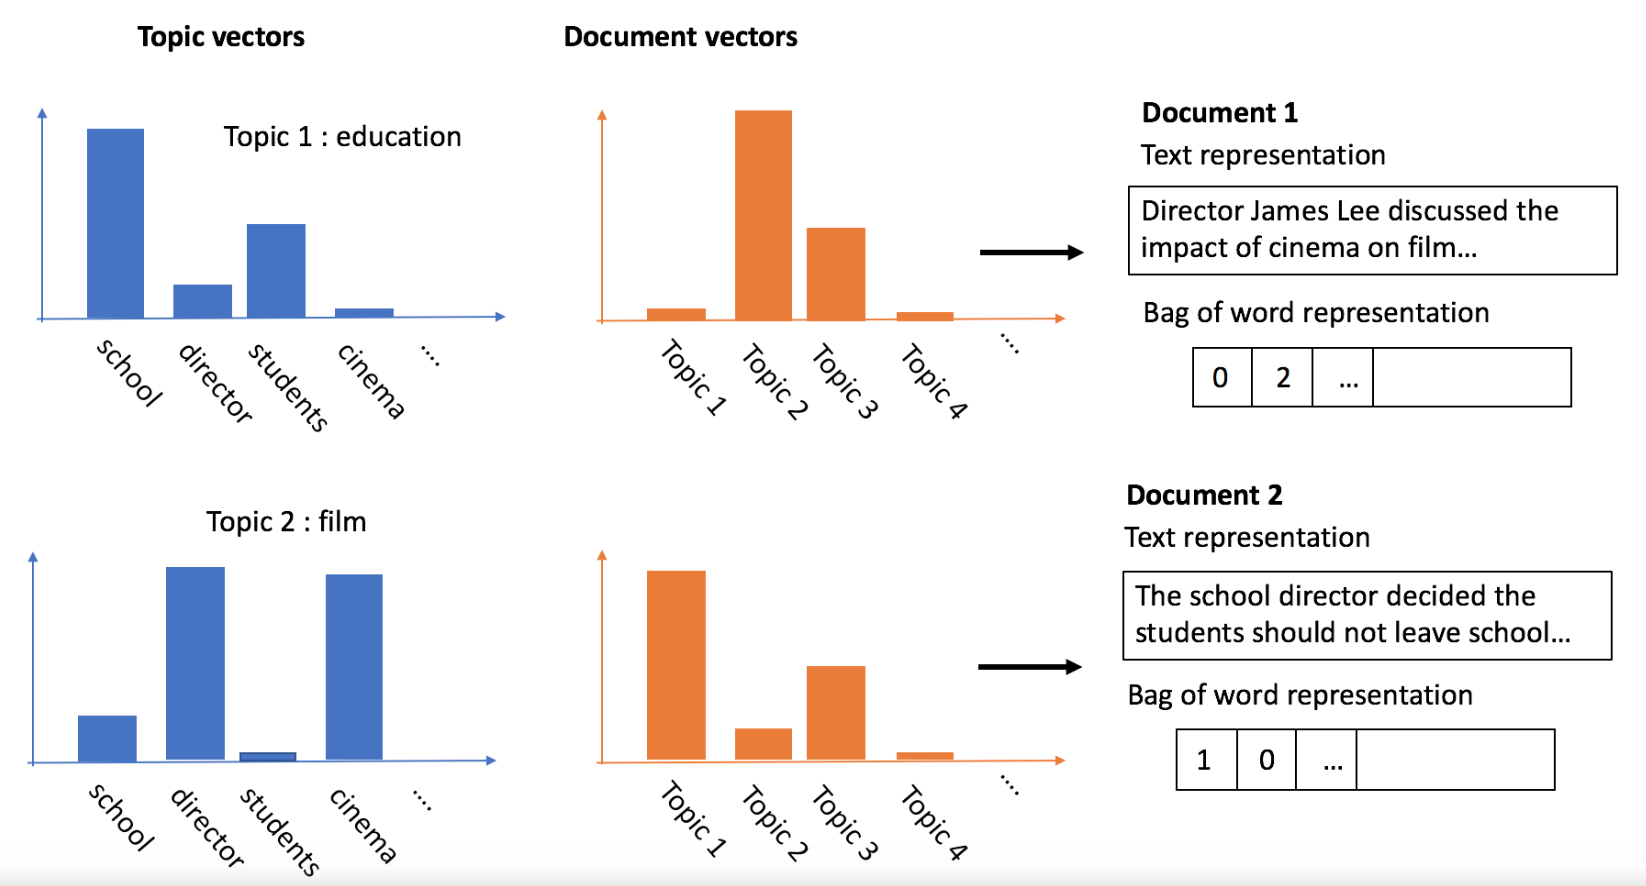
Avec LDA, vous obtenez :

  1. Modèle « thèmes par document » (probabilités)
  2. Modèle « mots par thème »

Créer votre propre modèle de thèmes :

  1. Nettoyer les données
  2. Créer un sac de mots avec dictionnaire et corpus
  3. Alimenter le modèle LDA avec le dictionnaire et le corpus
Détection de fraude en Python

Latent Dirichlet Allocation (LDA)

Détection de fraude en Python

Sac de mots : dictionnaire et corpus

from gensim import corpora
# Create dictionary number of times a word appears
dictionary = corpora.Dictionary(cleaned_emails)
# Filter out (non)frequent words 
dictionary.filter_extremes(no_below=5, keep_n=50000)
# Create corpus
corpus = [dictionary.doc2bow(text) for text in cleaned_emails]
Détection de fraude en Python

Latent Dirichlet Allocation (LDA) avec gensim

import gensim
# Define the LDA model
ldamodel = gensim.models.ldamodel.LdaModel(corpus, num_topics = 3, 
id2word=dictionary, passes=15)
# Print the three topics from the model with top words
topics = ldamodel.print_topics(num_words=4)
for topic in topics:
    print(topic)
(0, 0.029*"email" + 0.016*"send" + 0.016*"results" + 0.016*"invoice")
(1, 0.026*"price" + 0.026*"work" + 0.026*"management" + 0.026*"sell")
(2, 0.029*"distribute" + 0.029*"contact" + 0.016*"supply" + 0.016*"fast")
Détection de fraude en Python

Passons à la pratique !

Détection de fraude en Python

Preparing Video For Download...