Gagner une compétition Kaggle en Python
Yauhen Babakhin
Kaggle Grandmaster

Fuite dans les features – utilisation de données indisponibles en production
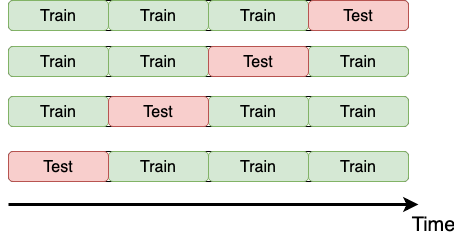
Fuite dans la stratégie de validation – stratégie différente de la réalité


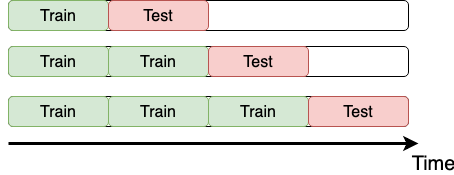
# Importer TimeSeriesSplit
from sklearn.model_selection import TimeSeriesSplit
# Créer un objet TimeSeriesSplit
time_kfold = TimeSeriesSplit(n_splits=5)
# Trier train par date
train = train.sort_values('date')
# Boucler sur chaque split de validation croisée
for train_index, test_index in time_kfold.split(train):
cv_train, cv_test = train.iloc[train_index], train.iloc[test_index]
# Liste des résultats fold_metrics = []for train_index, test_index in CV_STRATEGY.split(train): cv_train, cv_test = train.iloc[train_index], train.iloc[test_index]# Entraîner un modèle model.fit(cv_train)# Faire des prédictions predictions = model.predict(cv_test)# Calculer la métrique metric = evaluate(cv_test, predictions) fold_metrics.append(metric)
| N° de fold | MSE Modèle A | MSE Modèle B |
|---|---|---|
| Fold 1 | 2.95 | 2.97 |
| Fold 2 | 2.84 | 2.45 |
| Fold 3 | 2.62 | 2.73 |
| Fold 4 | 2.79 | 2.83 |
import numpy as np
# Moyenne simple sur les folds
mean_score = np.mean(fold_metrics)
# Score de validation global
overall_score_minimizing = np.mean(fold_metrics) + np.std(fold_metrics)
# Ou
overall_score_maximizing = np.mean(fold_metrics) - np.std(fold_metrics)
| N° de fold | MSE Modèle A | MSE Modèle B |
|---|---|---|
| Fold 1 | 2.95 | 2.97 |
| Fold 2 | 2.84 | 2.45 |
| Fold 3 | 2.62 | 2.73 |
| Fold 4 | 2.79 | 2.83 |
| Moyenne | 2.80 | 2.75 |
| Global | 2.919 | 2.935 |
Gagner une compétition Kaggle en Python