Similitudes basées sur le texte

Créer des moteurs de recommandation en Python

Rob O'Callaghan

Director of Data

Travailler sans attributs clairs
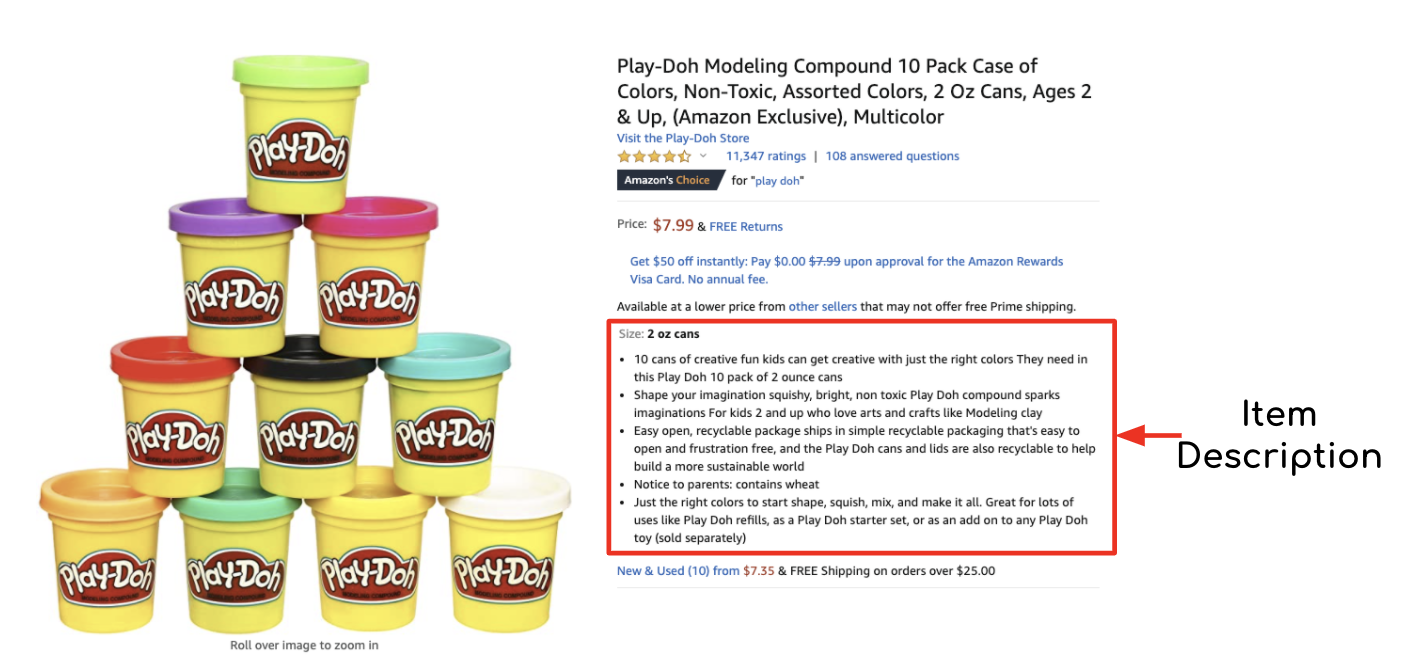
Exemple de description d'un article sur Amazon.

Créer des moteurs de recommandation en Python

Term frequency–inverse document frequency

$$ \Large{\text{TF-IDF} = \frac{\frac{\text{Nombre d'occurrences du mot}}{\text{Total de mots du document}}}{\log({\frac{\text{Nombre de documents contenant le mot}}{\text{Nombre total de documents}}})}} $$

Créer des moteurs de recommandation en Python

Nos données

book_summary_df:

Livre Description
The Hobbit "Bilbo Baggins mène une vie simple avec ses semblables hobbits dans la Comté..."
The Great Gatsby "Situé dans le New York des Années folles, le roman raconte l'histoire tragique de Jay ..."
A Game of Thrones "15 ans ont passé depuis la rébellion de Robert, avec une guerre de neuf ans ..."
Macbeth "Un vaillant général écossais reçoit une prophétie d'un trio de sorcières ..."
... ...
Créer des moteurs de recommandation en Python

Instancier le vectoriseur

from sklearn.feature_extraction.text import TfidfVectorizer
tfidfvec = TfidfVectorizer(        ,           )
Créer des moteurs de recommandation en Python

Filtrer les données

from sklearn.feature_extraction.text import TfidfVectorizer
tfidfvec = TfidfVectorizer(min_df=2,           )
Créer des moteurs de recommandation en Python

Filtrer les données

from sklearn.feature_extraction.text import TfidfVectorizer
tfidfvec = TfidfVectorizer(min_df=2, max_df=0.7)
Créer des moteurs de recommandation en Python

Vectoriser les données

vectorized_data = tfidfvec.fit_transform(book_summary_df['Descriptions'])

print(tfidfvec.get_feature_names)
['age', 'ancient', 'angry', 'brave', 'battle', 'fellow', 'game', 'general', ...]
print(vectorized_data.to_array())
[[0.21,      0.53,    0.41,    0.64,     0.01,     0.02,     ...
 [0.31,      0.00,    0.42,    0.03,     0.00,     0.73,     ...
 [...,        ...,     ...,     ...,      ...,      ...,     ...
Créer des moteurs de recommandation en Python

Mettre en forme les données

tfidf_df = pd.DataFrame(vectorized_data.toarray(),
                        columns=tfidfvec.get_feature_names())

tfidf_df.index = book_summary_df['Book']
print(tfidf_df)
                   | 'age'| 'ancient'| 'angry'| 'brave'| 'battle'| 'fellow'|...
|------------------|------|----------|--------|--------|---------|---------|...
| The Hobbit       |  0.21|      0.53|    0.41|    0.64|     0.01|     0.02|...
| The Great Gatsby |  0.31|      0.00|    0.42|    0.03|     0.00|     0.73|...
| A Game of Thrones|  0.61|      0.42|    0.77|    0.31|     0.83|     0.03|...
|               ...|   ...|       ...|     ...|     ...|      ...|      ...|...
Créer des moteurs de recommandation en Python

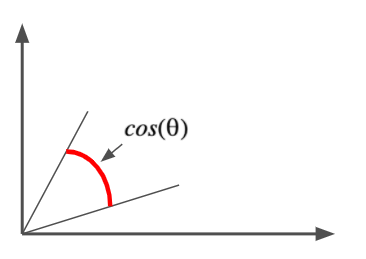
Similarité cosinus

Distance cosinus : $$cos(\theta)=\frac{A.B }{||A||\cdot||B||}$$
Créer des moteurs de recommandation en Python

Similarité cosinus

from sklearn.metrics.pairwise import cosine_similarity

# Find similarity between all items
cosine_similarity_array = cosine_similarity(tfidf_summary_df)
# Find similarity between two items
cosine_similarity(tfidf_df.loc['The Hobbit'].values.reshape(1, -1),
                  tfidf_df.loc['Macbeth'].values.reshape(1, -1))
Créer des moteurs de recommandation en Python

Passons à la pratique !

Créer des moteurs de recommandation en Python

Preparing Video For Download...