Introduction à XPATH

Web scraping en R

Timo Grossenbacher

Instructor

XML Path Language

  • Un chemin dans un arbre HTML se formule, p. ex. //div/p[@class = "blue"] (équivalent à div > p.blue)
  • Sélectionner des nœuds selon les propriétés d'autres nœuds
  • Sélections plus avancées et personnalisées possibles
  • Exemple : sélectionner des éléments selon les propriétés de leurs enfants, p. ex. uniquement les div contenant des nœuds a avec une classe special
Web scraping en R

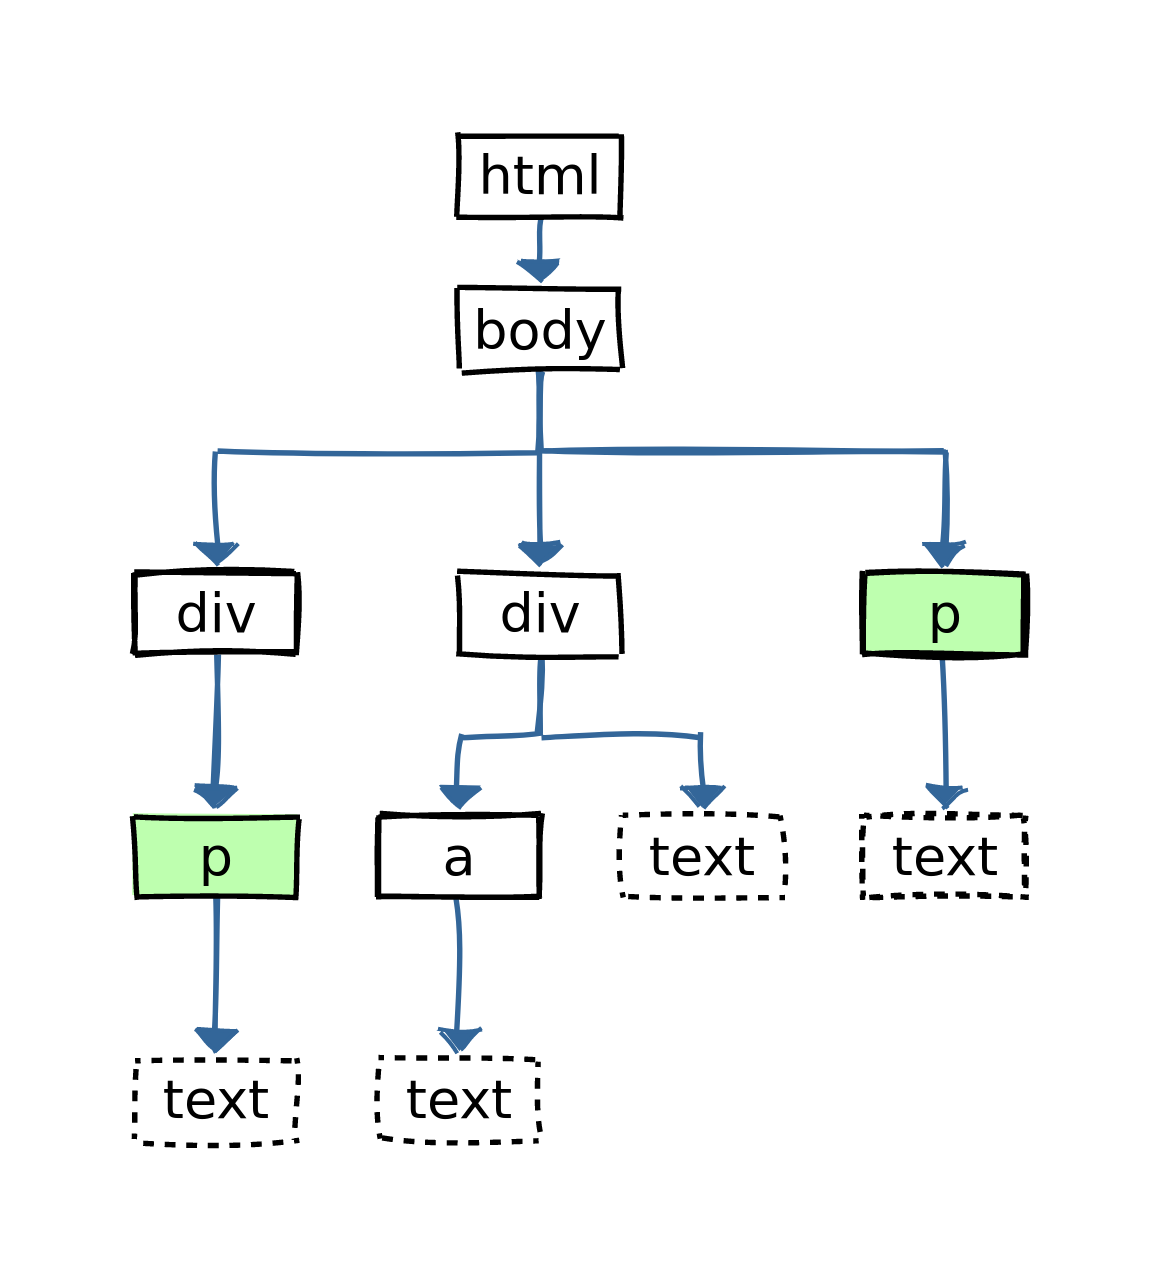
Un arbre HTML simple où tous les éléments p sont sélectionnés

html %>%
    html_elements(xpath = '//p')
# Équivalent sélecteur CSS : p
html %>%
    html_elements(xpath = '//body//p')
# Équivalent sélecteur CSS : body p
html %>%
    html_elements(xpath = '/html/body//p')
# Équivalent sélecteur CSS : html > body p
Web scraping en R

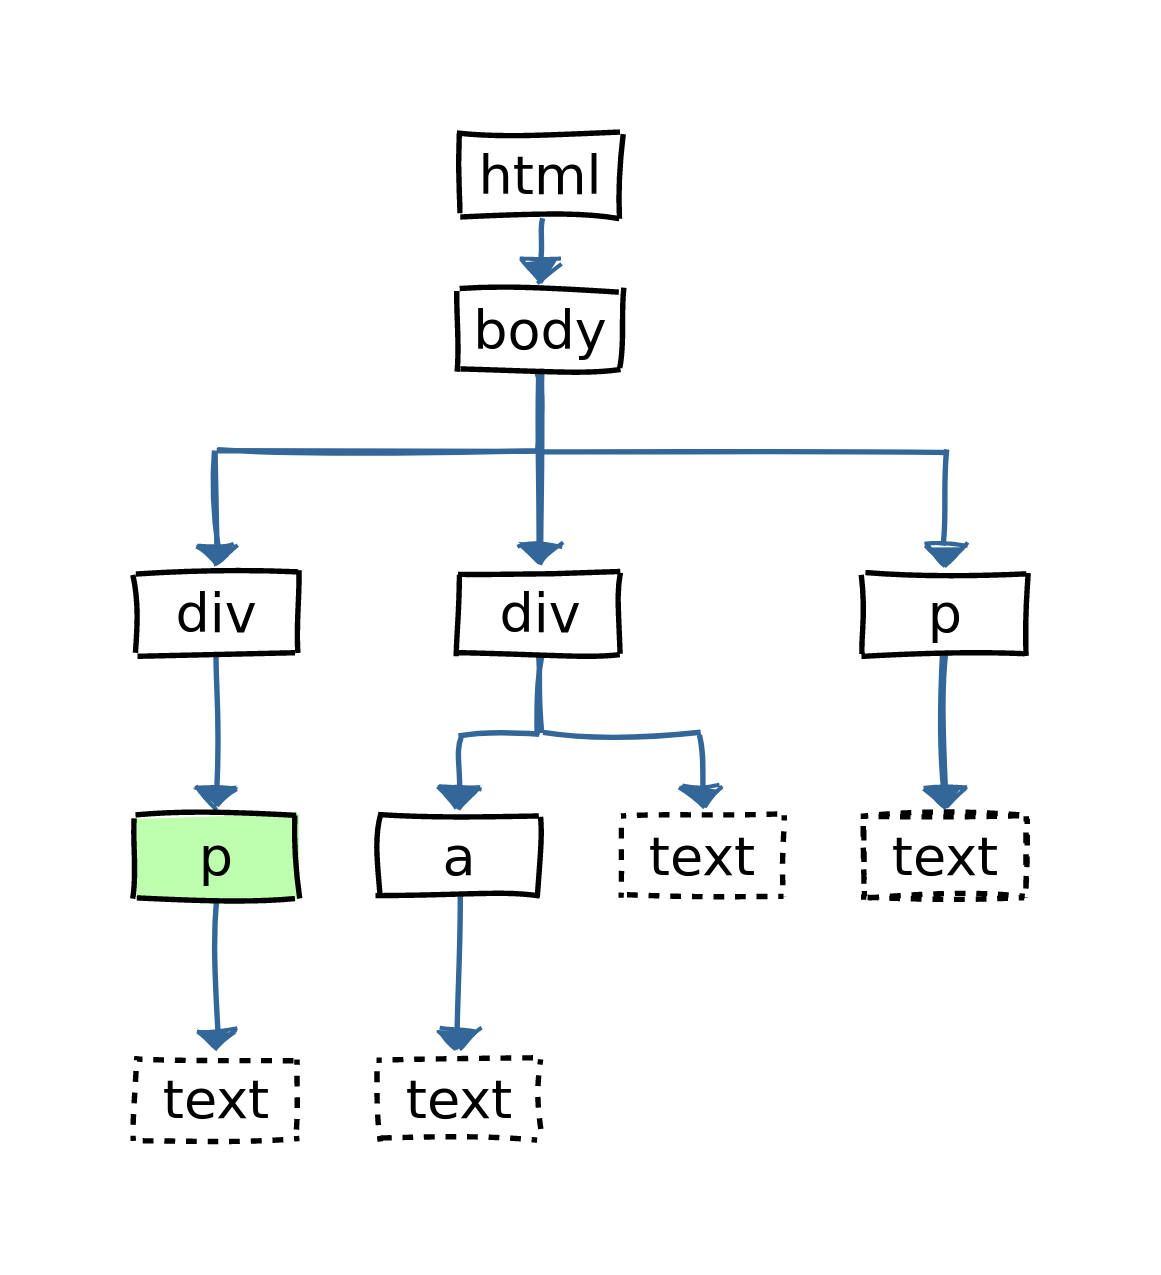
Un arbre HTML simple où seuls les éléments p sous des div sont sélectionnés

html %>%
    html_elements(xpath = '//div/p')
# Équivalent sélecteur CSS : div > p
Web scraping en R

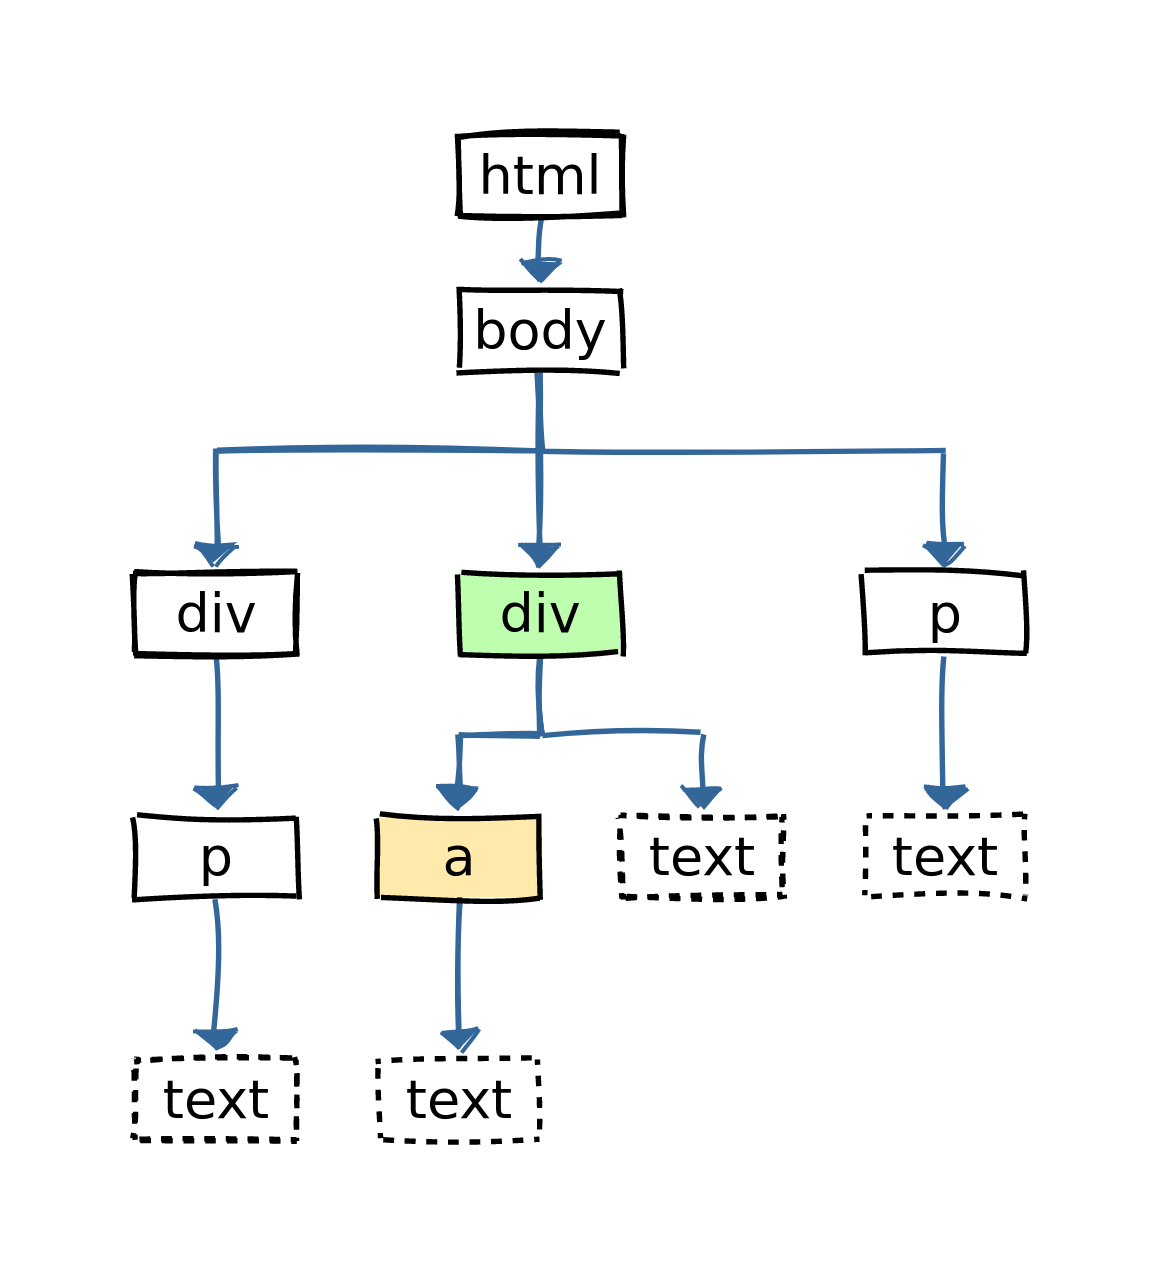
Un arbre HTML simple où seuls les div avec des enfants a sont sélectionnés

html %>%
    html_elements(xpath = '//div[a]')
# Équivalent sélecteur CSS : aucun
Web scraping en R

Syntaxe : axes, étapes et prédicats

  • Axes : / ou //
  • Étapes : types HTML comme span et a
  • Prédicats : [...]
  • Exemple : //span/a[@class = "external"] (CSS : span > a.external)
  • Exemple : //*[@id = "special"]//div (CSS : #special div ou *#special div)
Web scraping en R

Passons à la pratique !

Web scraping en R

Preparing Video For Download...