Introduction à Spark SQL en Python
Mark Plutowski
Data Scientist
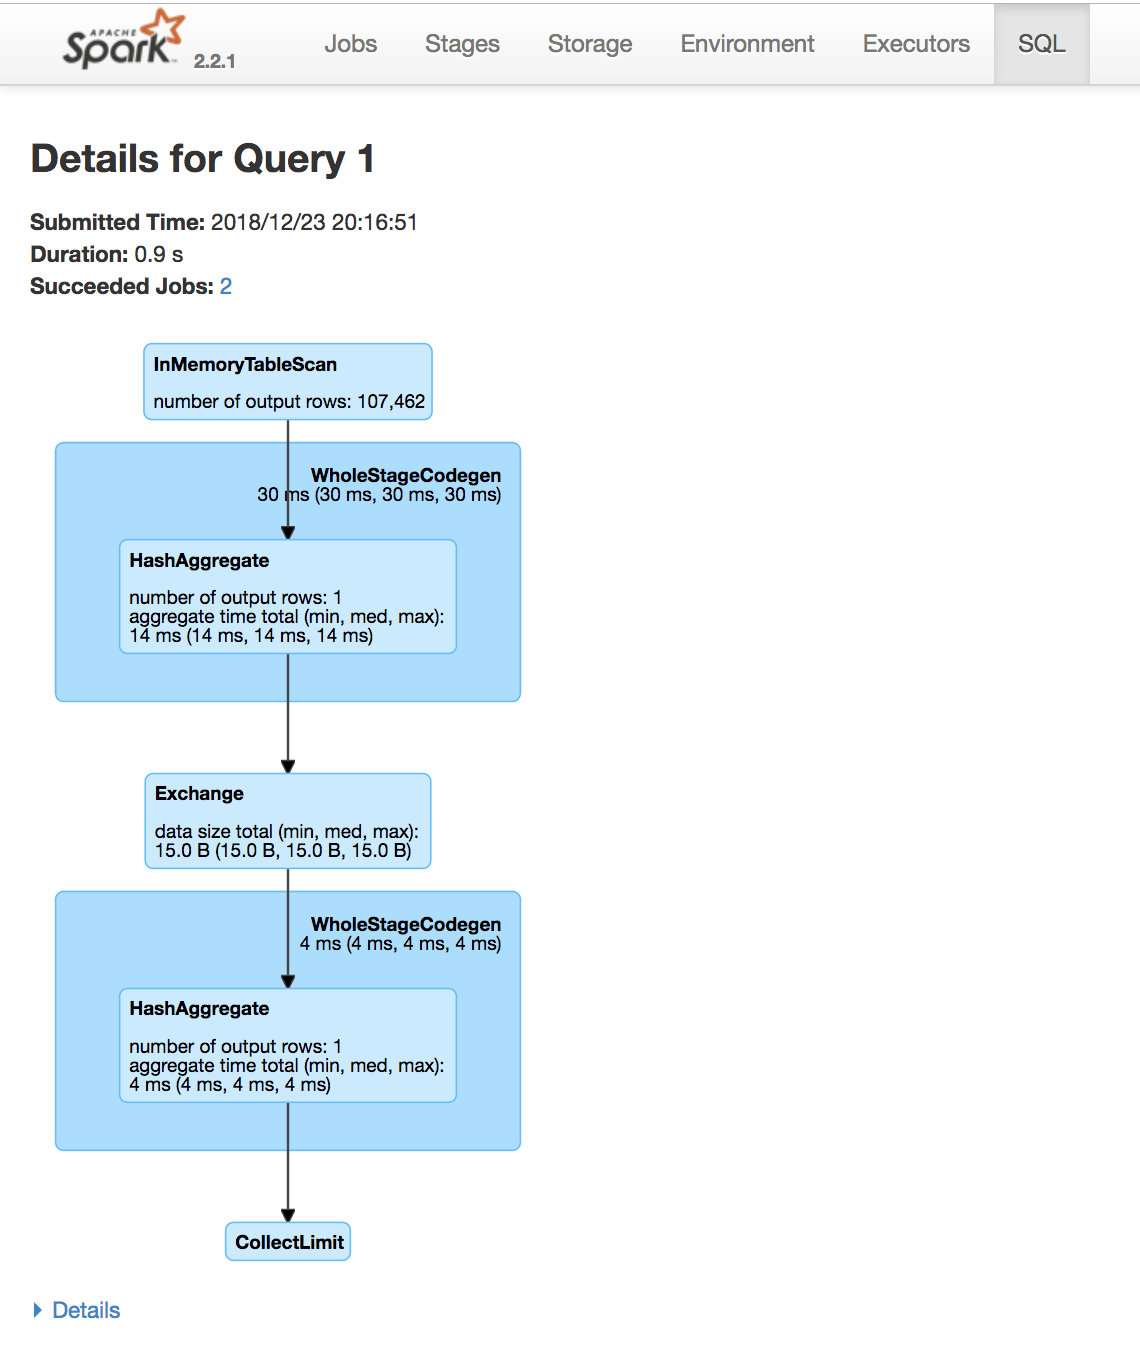
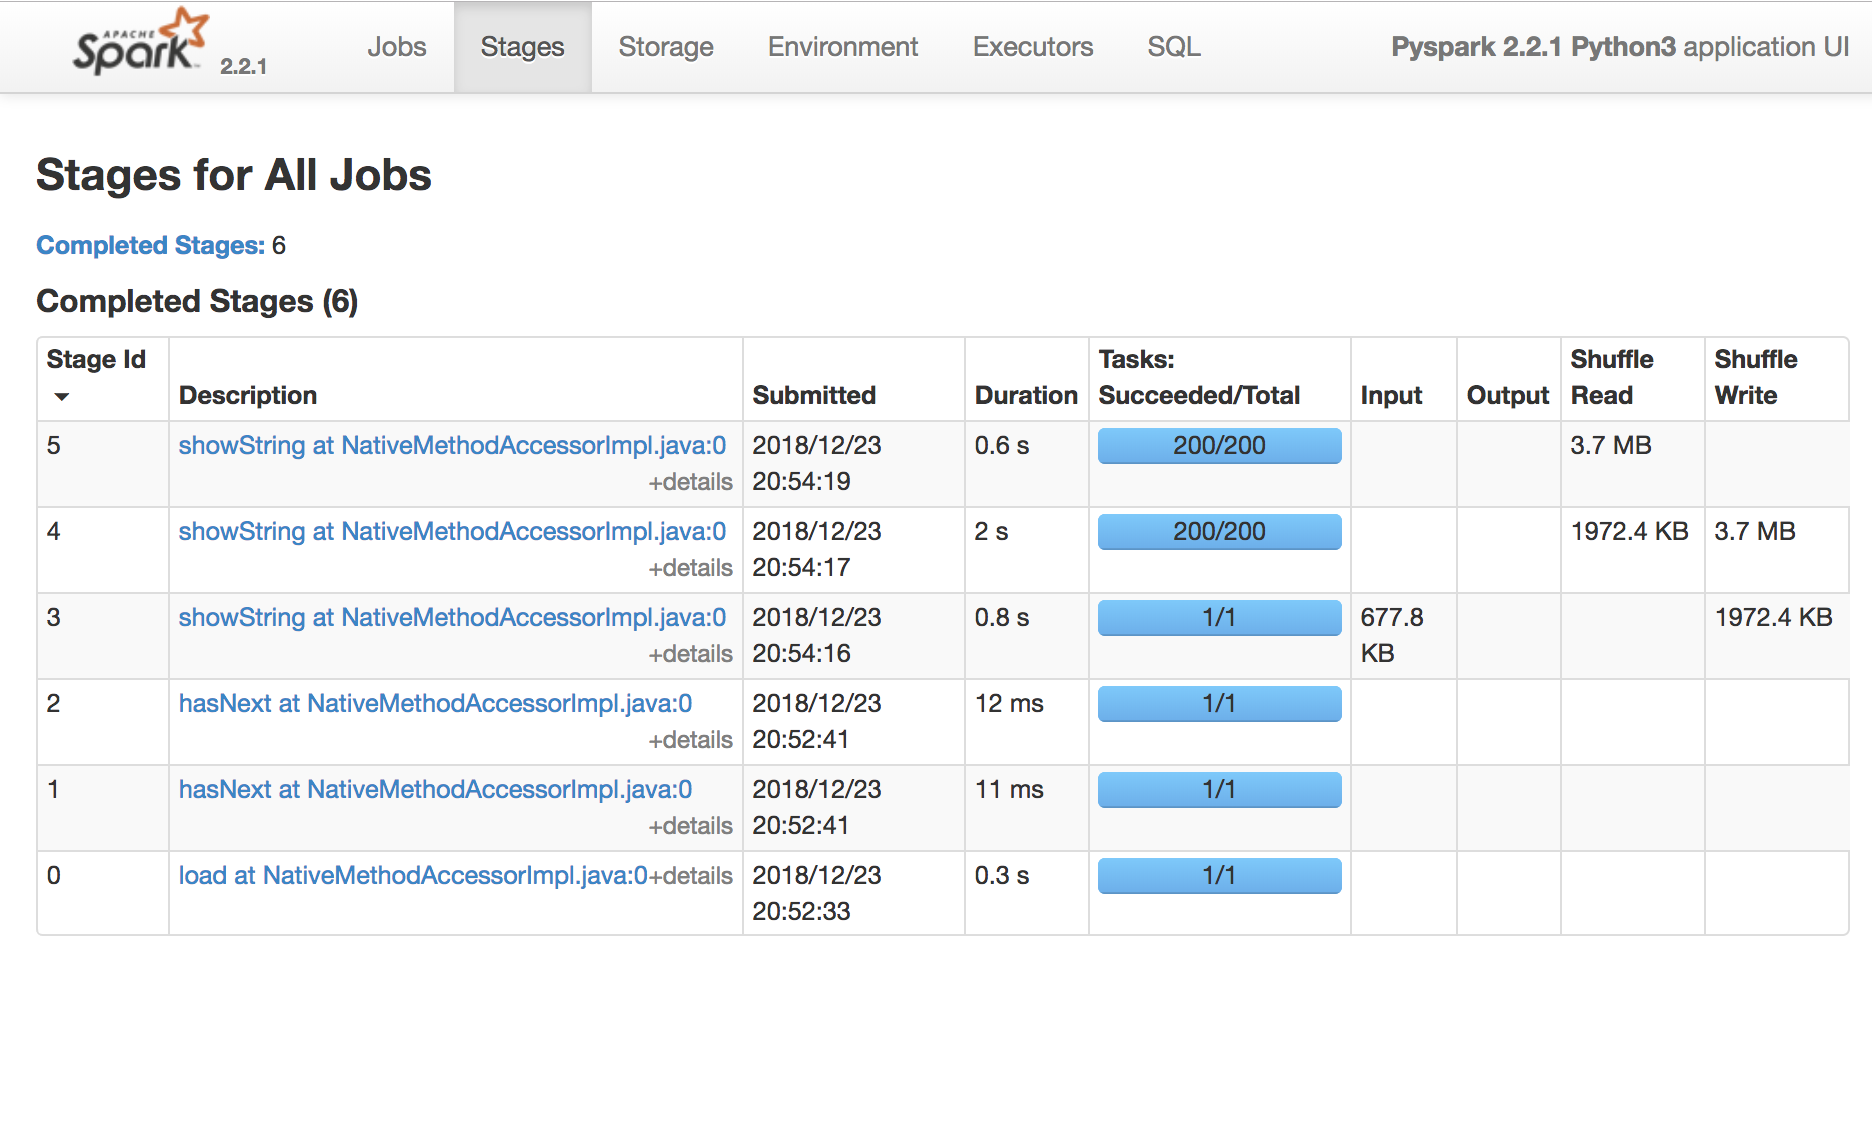
Une tâche Spark est une unité d’exécution sur un seul CPU
Un stage Spark est un groupe de tâches effectuant le même calcul en parallèle, chacune sur un sous-ensemble de données
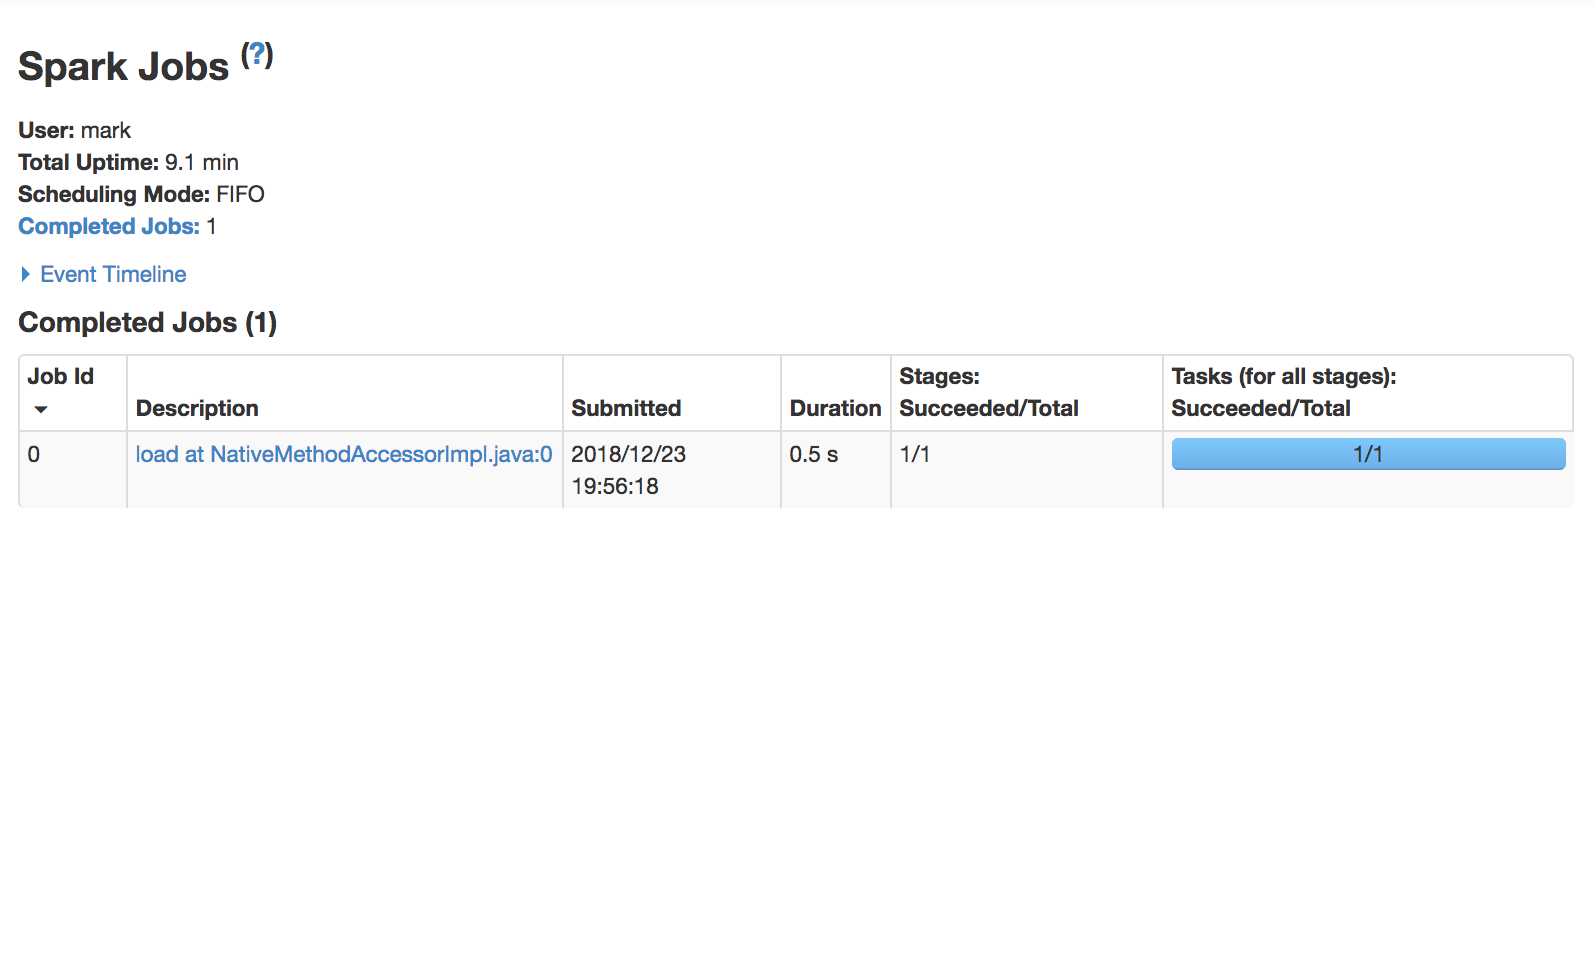
Un job Spark est un calcul déclenché par une action, découpé en un ou plusieurs stages.

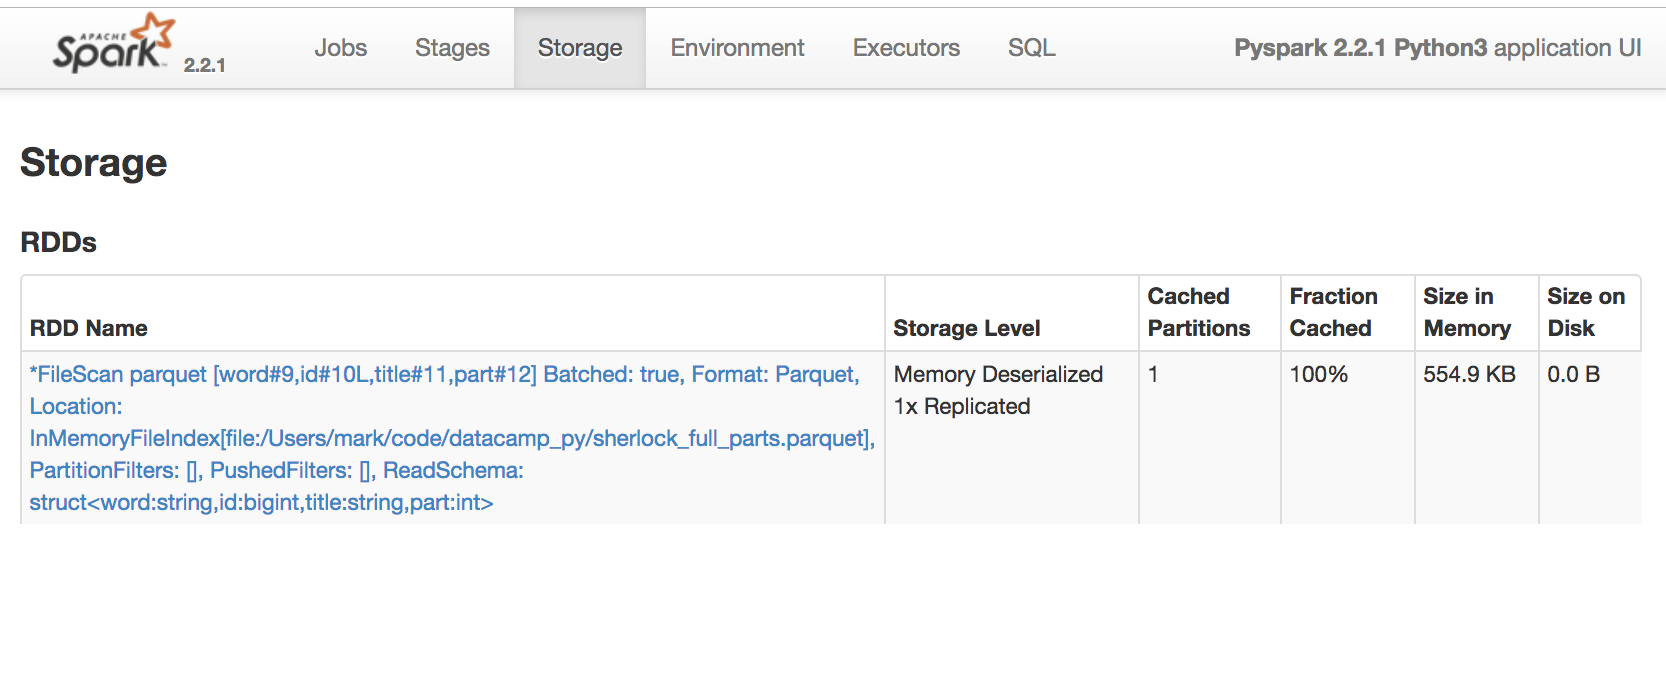
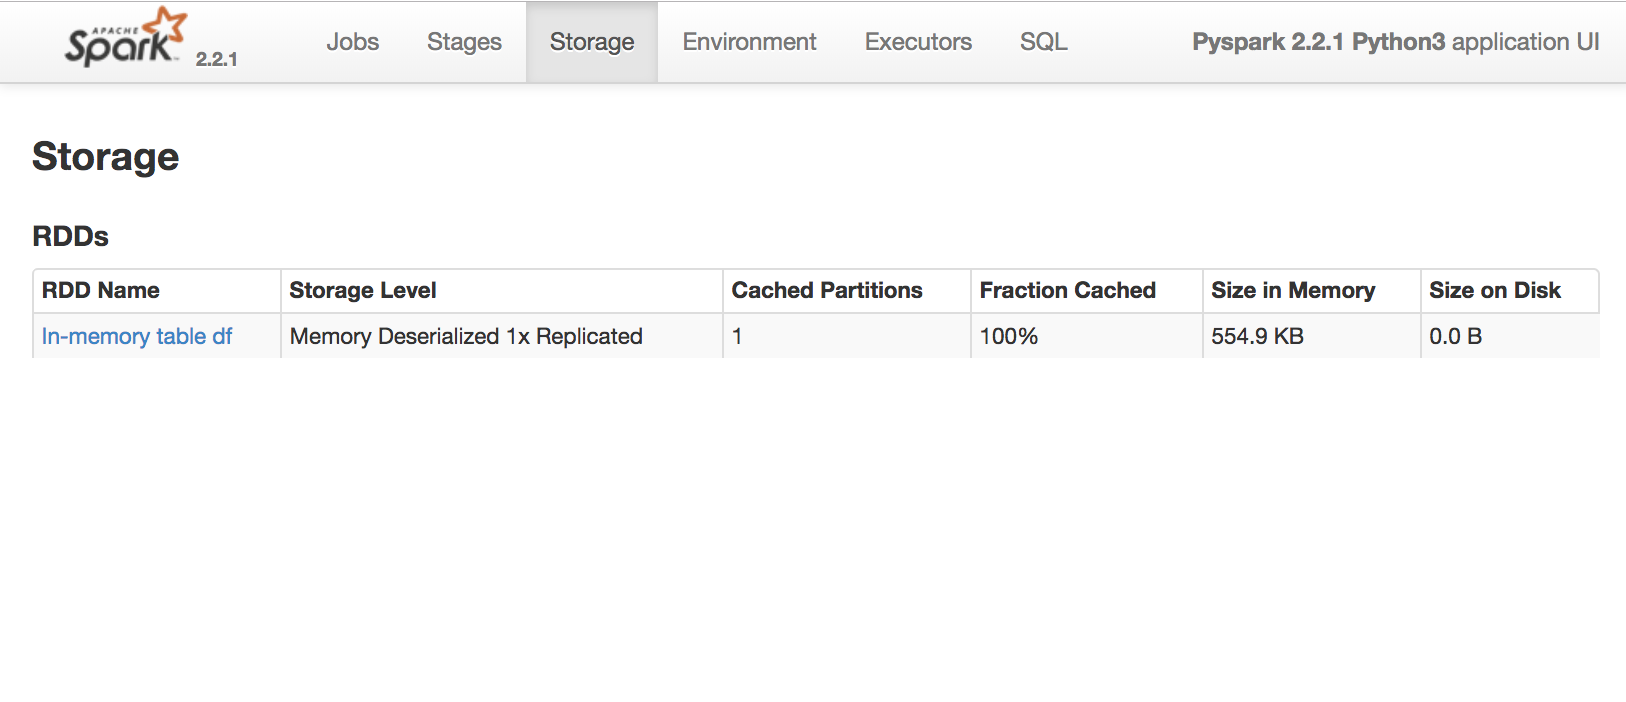
spark.catalog.cacheTable('table1')spark.catalog.uncacheTable('table1')spark.catalog.isCached('table1')spark.catalog.dropTempView('table1')spark.catalog.listTables()
[Table(name='text', database=None, description=None, tableType='TEMPORARY', isTemporary=True)]


Indique où se trouvent les partitions
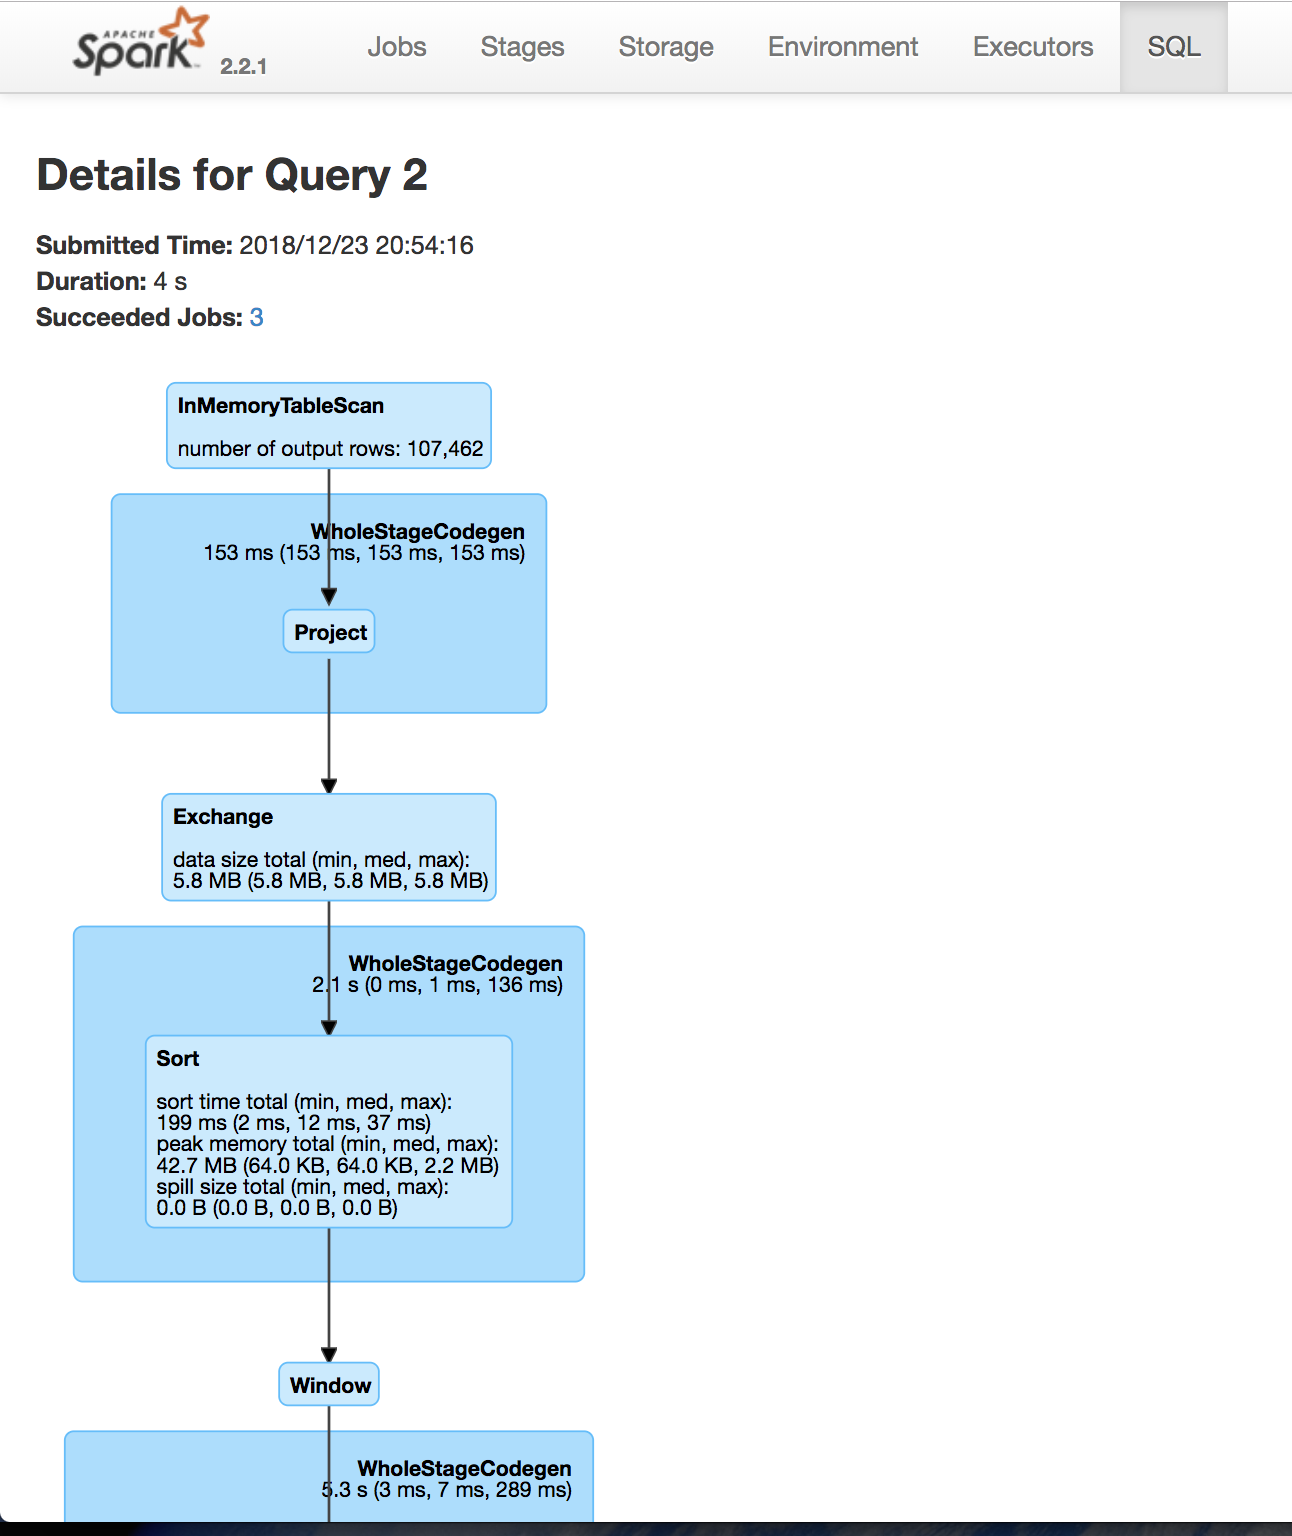
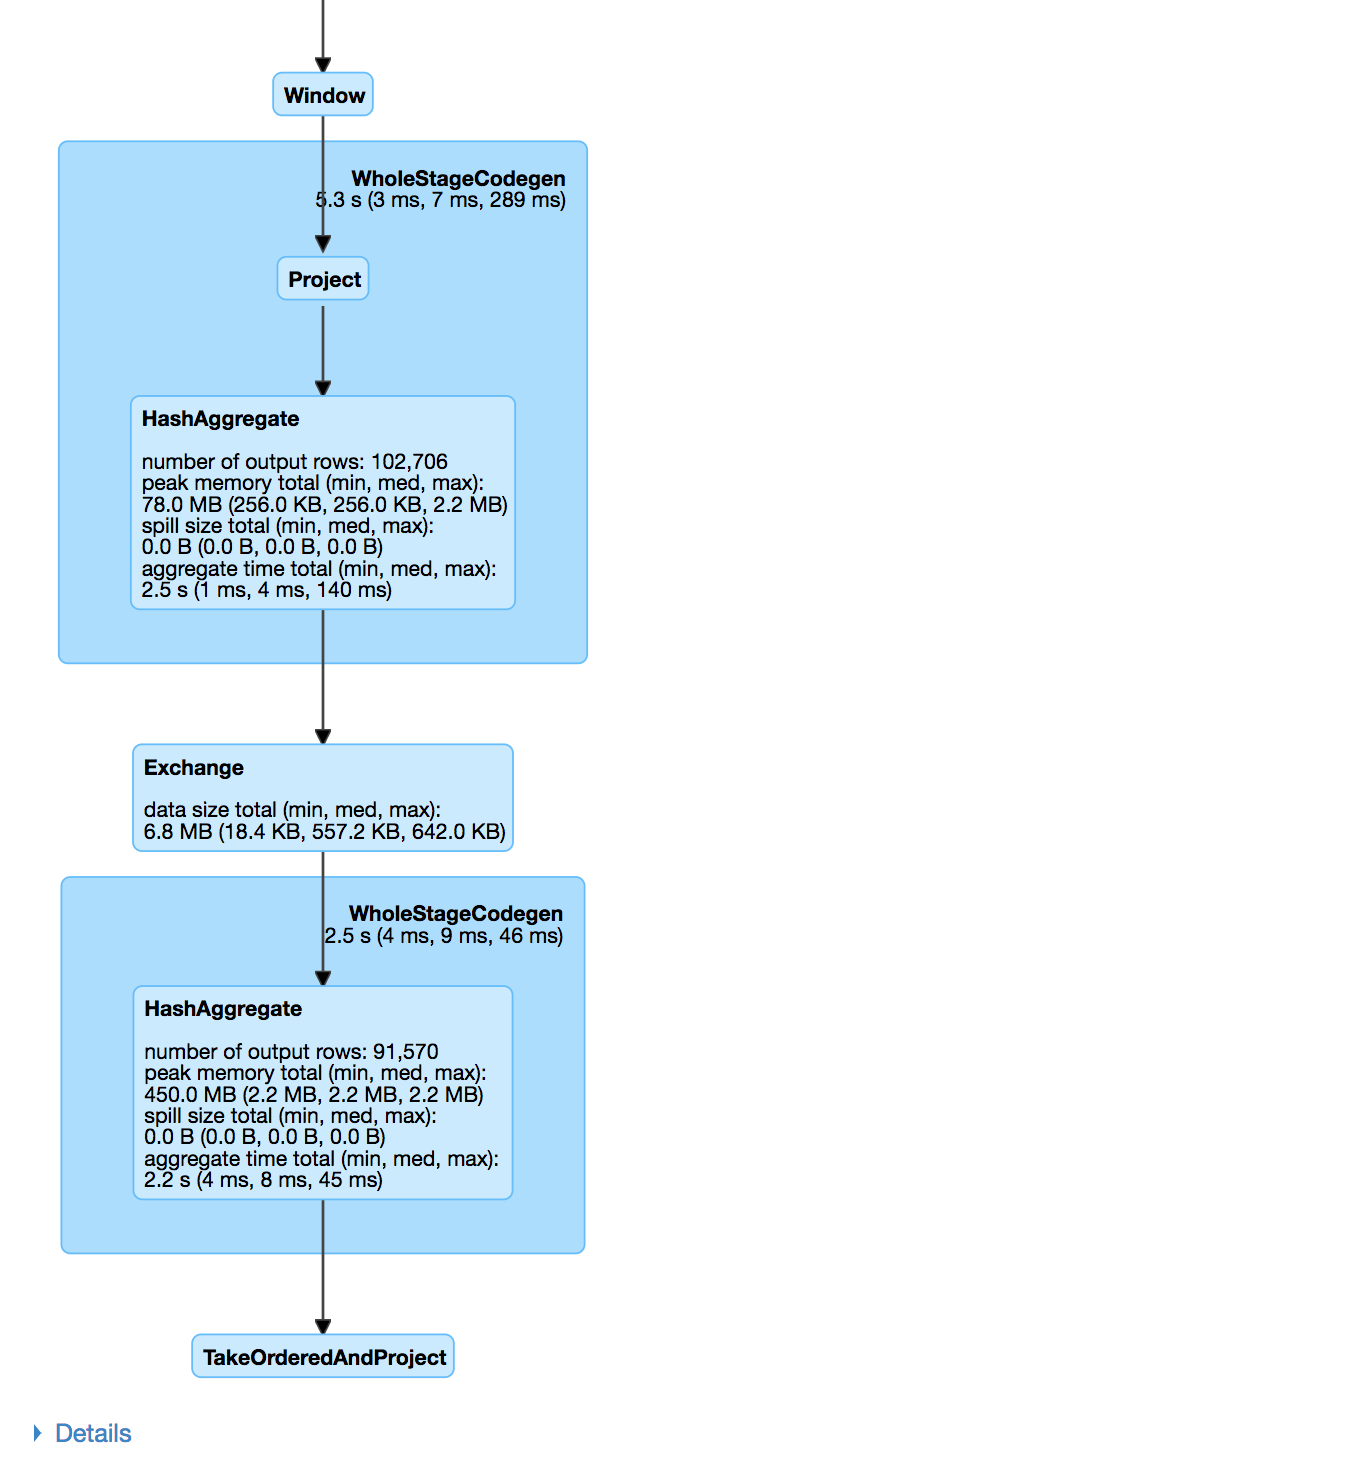
query3agg = """ SELECT w1, w2, w3, COUNT(*) as count FROM ( SELECT word AS w1, LEAD(word,1) OVER(PARTITION BY part ORDER BY id ) AS w2, LEAD(word,2) OVER(PARTITION BY part ORDER BY id ) AS w3 FROM df ) GROUP BY w1, w2, w3 ORDER BY count DESC """spark.sql(query3agg).show()


Introduction à Spark SQL en Python