Distribuer par catégorie avec seaborn

Importer et gérer des données financières en Python

Stefan Jansen

Instructor

Distributions par catégorie

  • Dernière partie : statistiques récapitulatives
  • Nombre d'observations, moyenne par catégorie
  • Maintenant : visualiser la distribution d'une variable selon les modalités d'une variable catégorielle pour comparer
  • Exemple : distribution de la capitalisation boursière par secteur ou année d'IPO
  • Plus de détail que les stats récapitulatives
Importer et gérer des données financières en Python

Nettoyer les données : supprimer les valeurs aberrantes

nasdaq = pd.read_excel('listings.xlsx', sheet_name='nasdaq', 
                        na_values='n/a')
nasdaq['market_cap_m'] = nasdaq['Market Capitalization'].div(1e6)

nasdaq = nasdaq[nasdaq.market_cap_m > 0] # Active companies only
outliers = nasdaq.market_cap_m.quantile(.9) # Outlier threshold
nasdaq = nasdaq[nasdaq.market_cap_m < outliers] # Remove outliers
Importer et gérer des données financières en Python

Boxplot : quartiles et valeurs aberrantes

import seaborn as sns
sns.boxplot(x='Sector', y='market_cap_m', data=nasdaq)
plt.xticks(rotation=75);
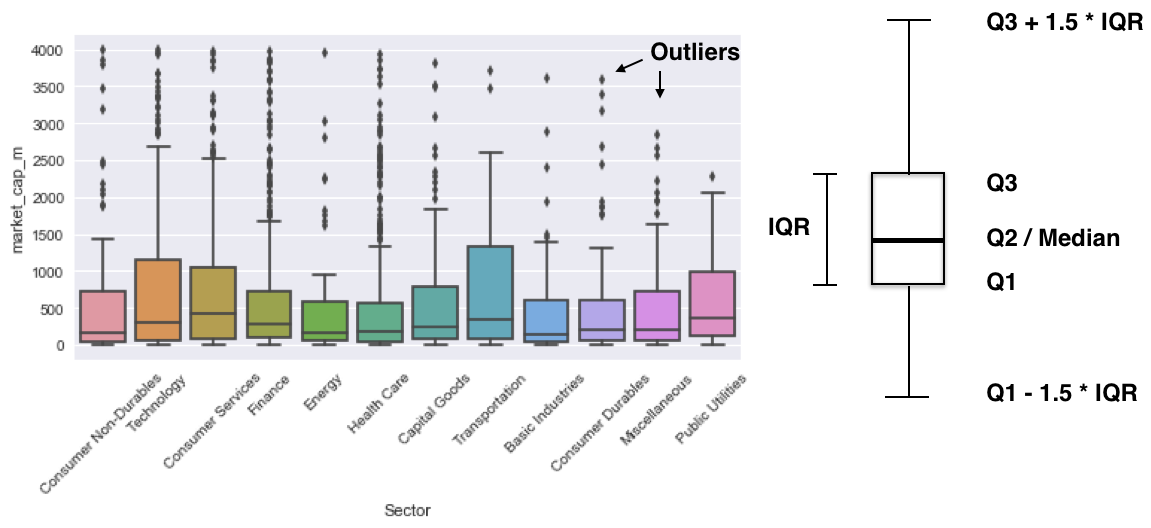
Quartiles d'un boxplot

Importer et gérer des données financières en Python

Une variante : SwarmPlot

sns.swarmplot(x='Sector', y='market_cap_m', data=nasdaq)
plt.xticks(rotation=75)
plt.show()
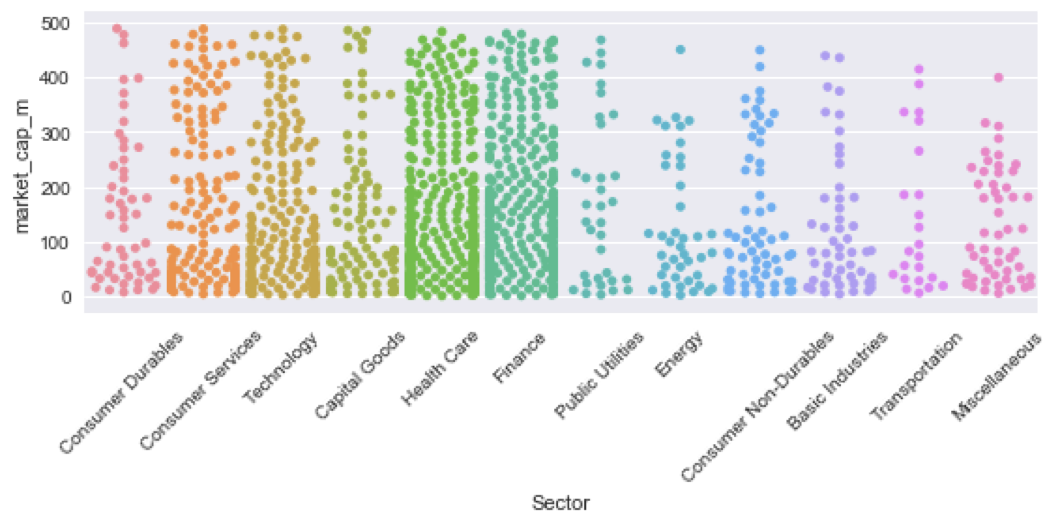
SwarmPlot

Importer et gérer des données financières en Python

Passons à la pratique !

Importer et gérer des données financières en Python

Preparing Video For Download...