Palettes catégorielles
Améliorer vos visualisations de données en Python

Nick Strayer
Instructor
Limites de perception
- Limitez-vous à 10 catégories max.
- Pensez au daltonisme
sns.palplot(sns.color_palette('Set2', 11))
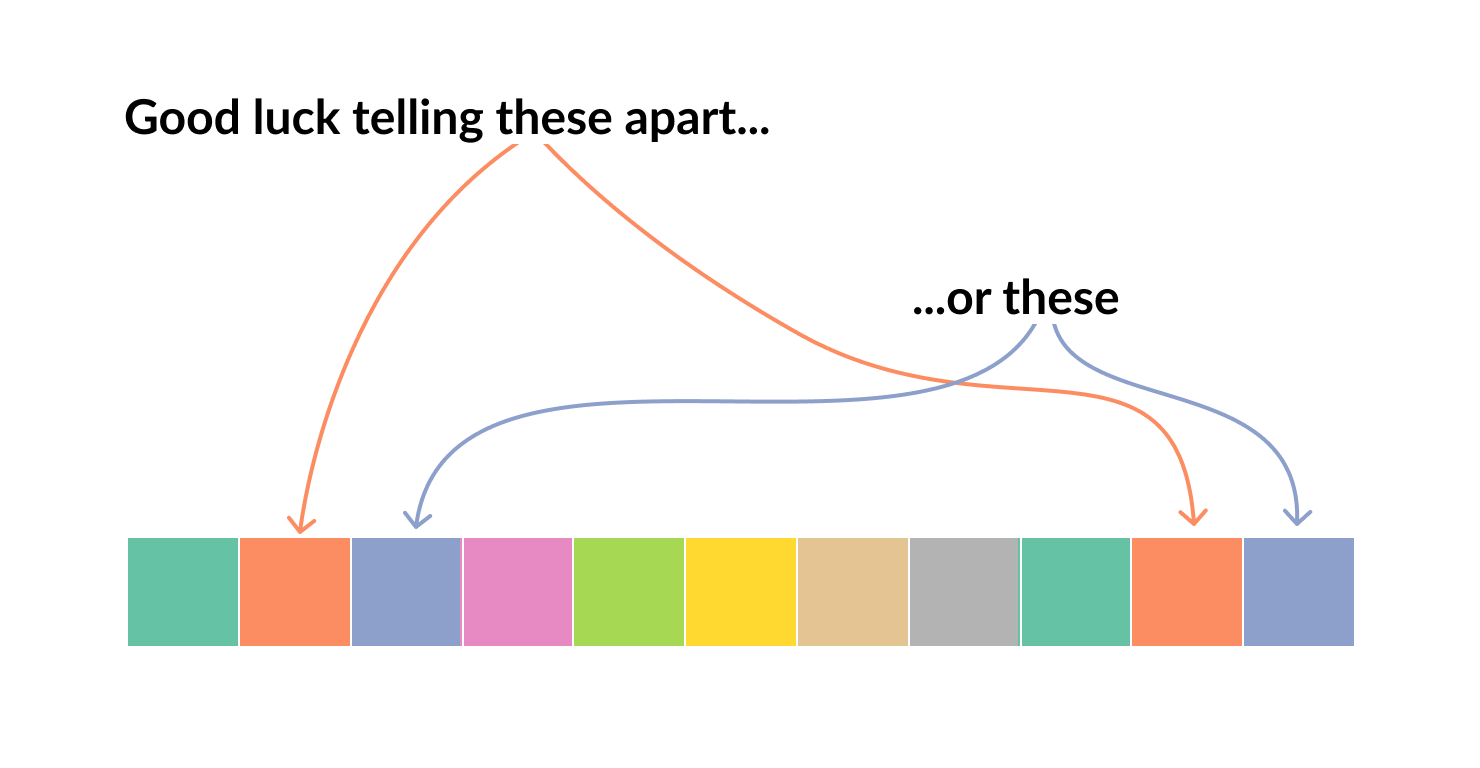
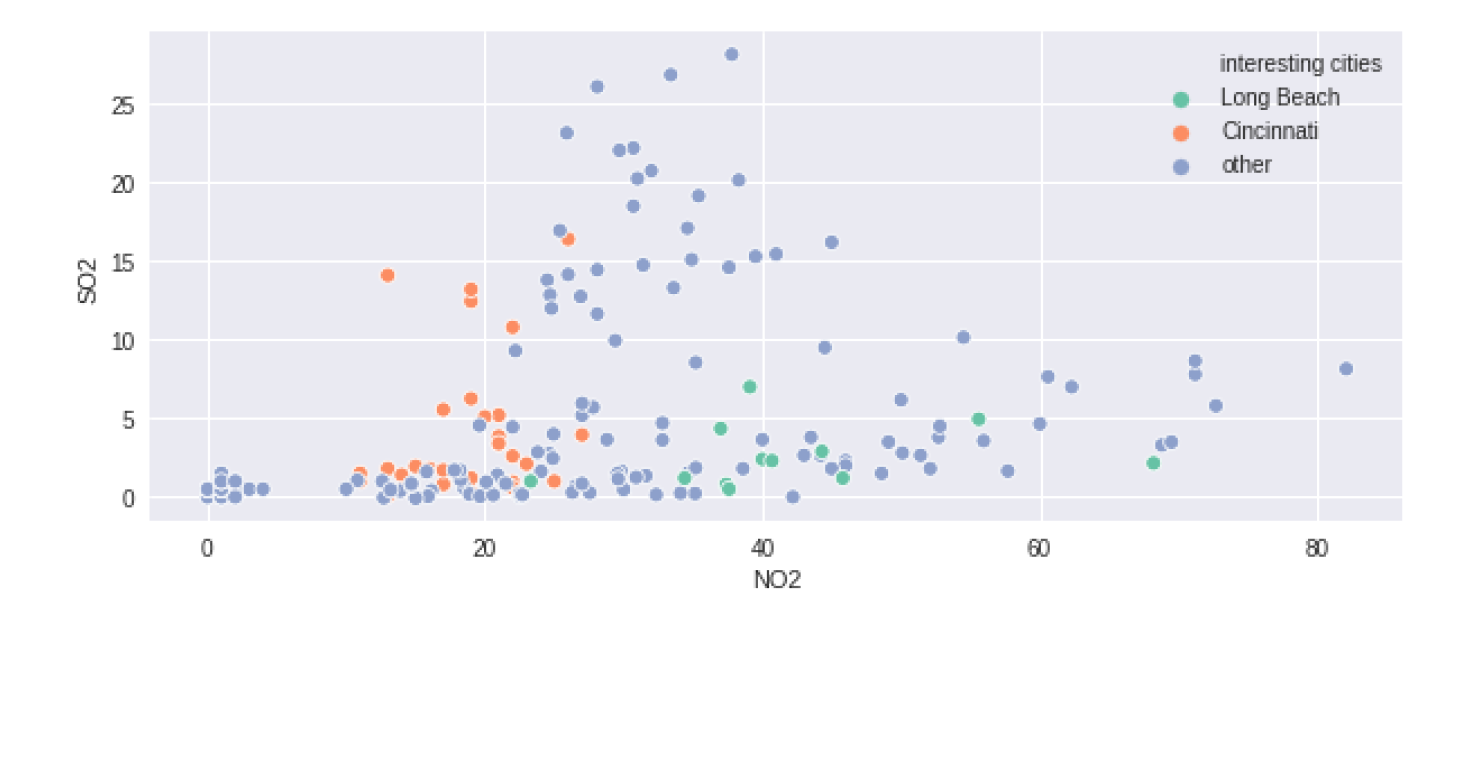
# Ajouter une colonne avec les combinaisons souhaitées
pollution['interesting cities'] = [x if x in ['Long Beach', 'Cincinnati']
                                   else 'other' for x in pollution['city'] ]

sns.scatterplot(x="NO2", y="SO2", hue = 'interesting cities', palette='Set2',
                data=pollution.query('year == 2014 & month == 12'))
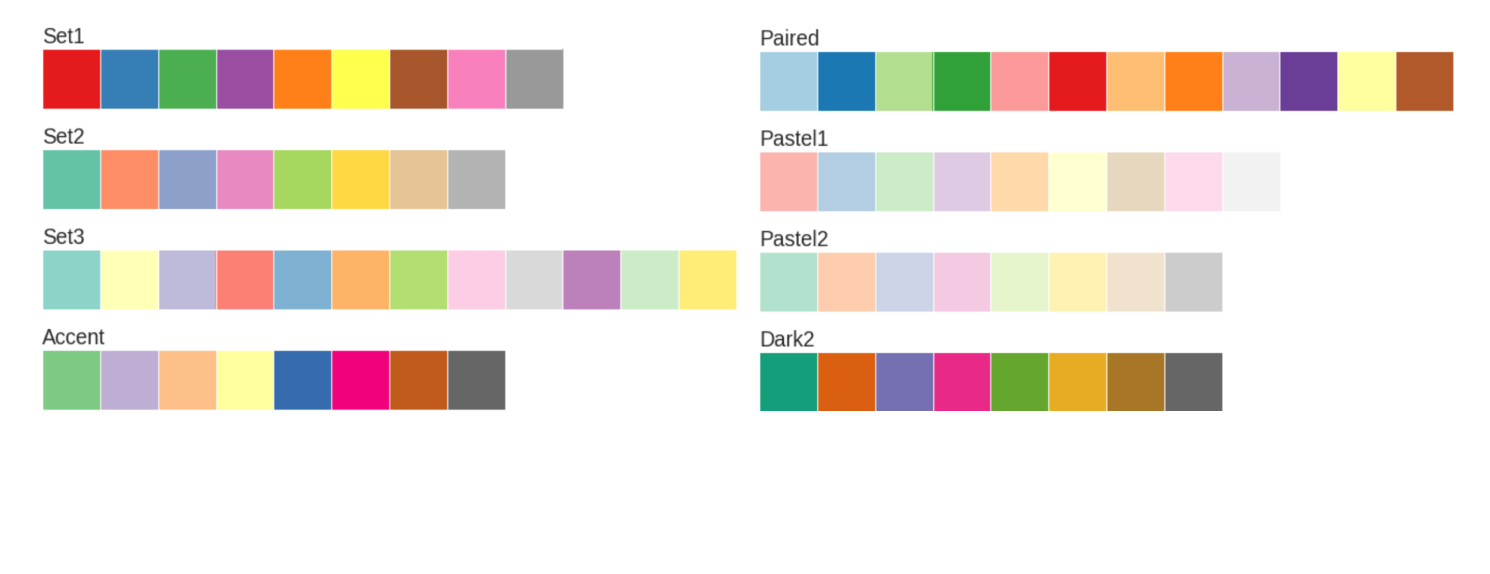
colorbrewer_palettes = ['Set1',   'Set2',    'Set3',    'Accent',
                        'Paired', 'Pastel1', 'Pastel2', 'Dark2']

for pal in colorbrewer_palettes:
    sns.palplot(pal=sns.color_palette(pal))
    plt.title(pal, loc = 'left')
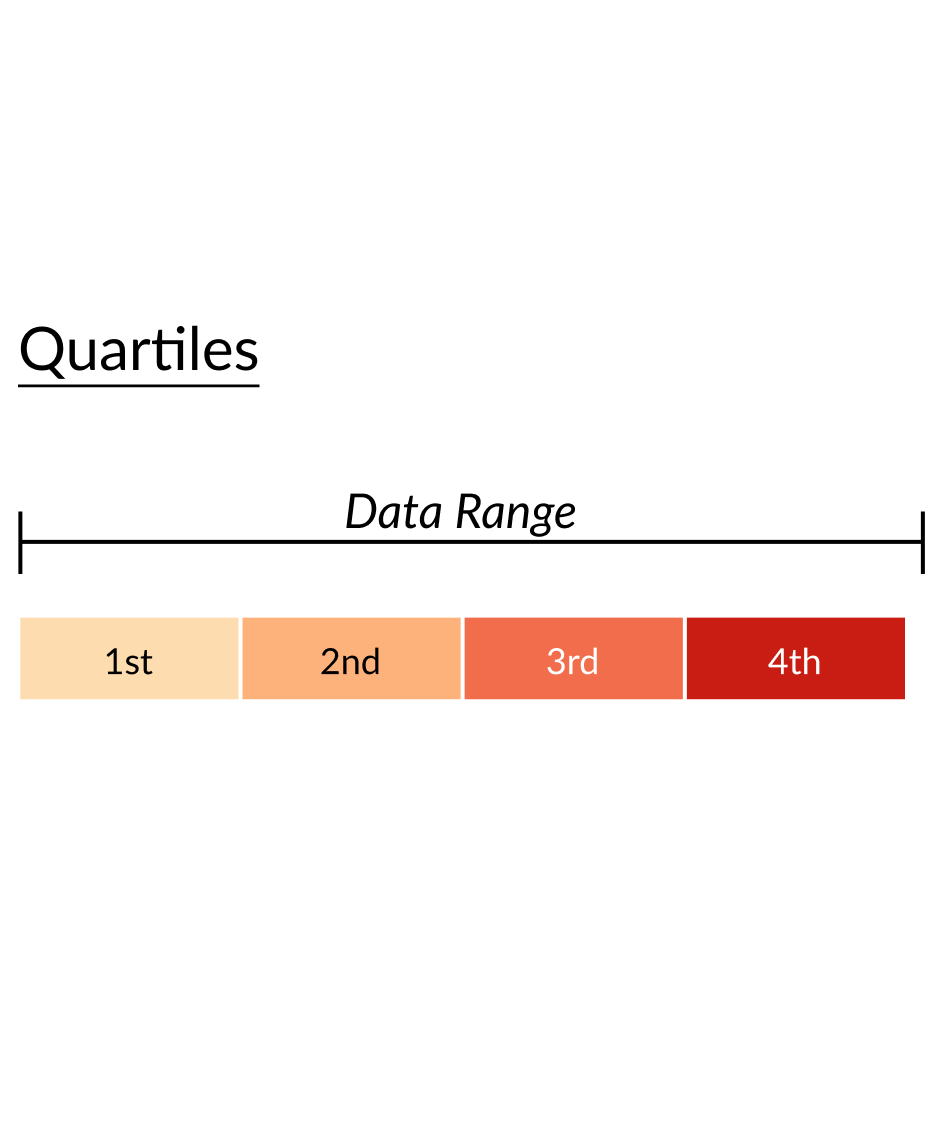
Données ordinales (a)
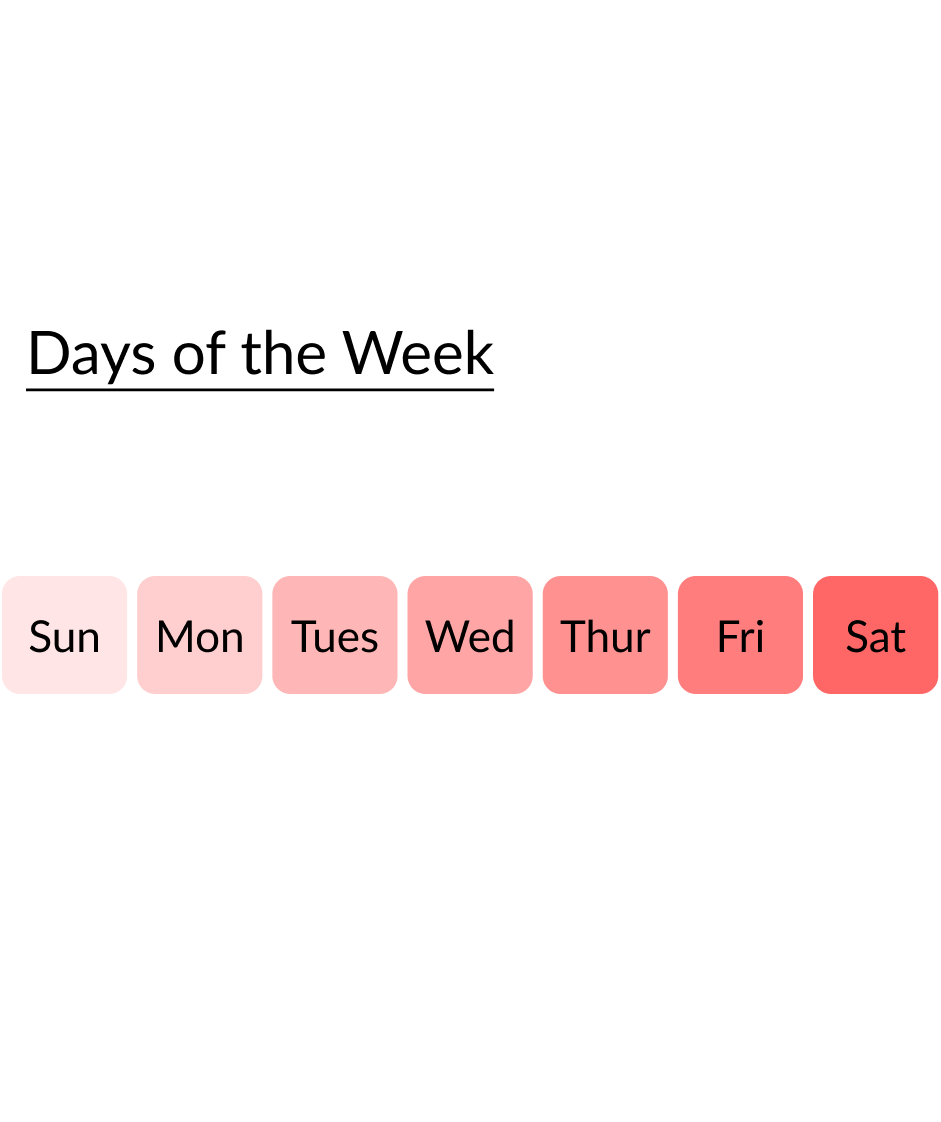
Données ordinales (b)
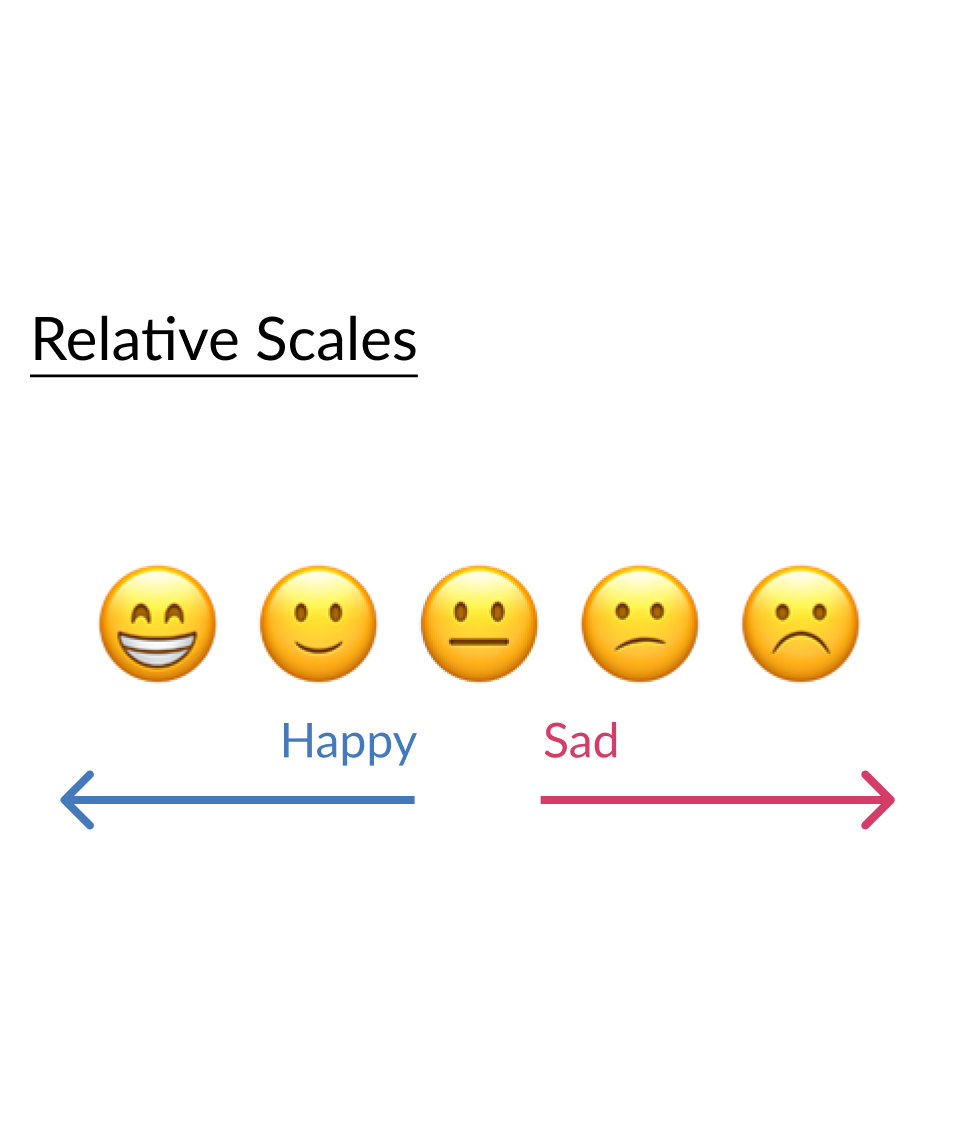
Données ordinales (c)
colorbrewer_palettes = ['Reds', 'Blues', 'YlOrBr', 'PuBuGn', 'GnBu', 'Greys']

for i, pal in enumerate(colorbrewer_palettes):
    sns.palplot(pal=sns.color_palette(pal, n_colors=i+4))

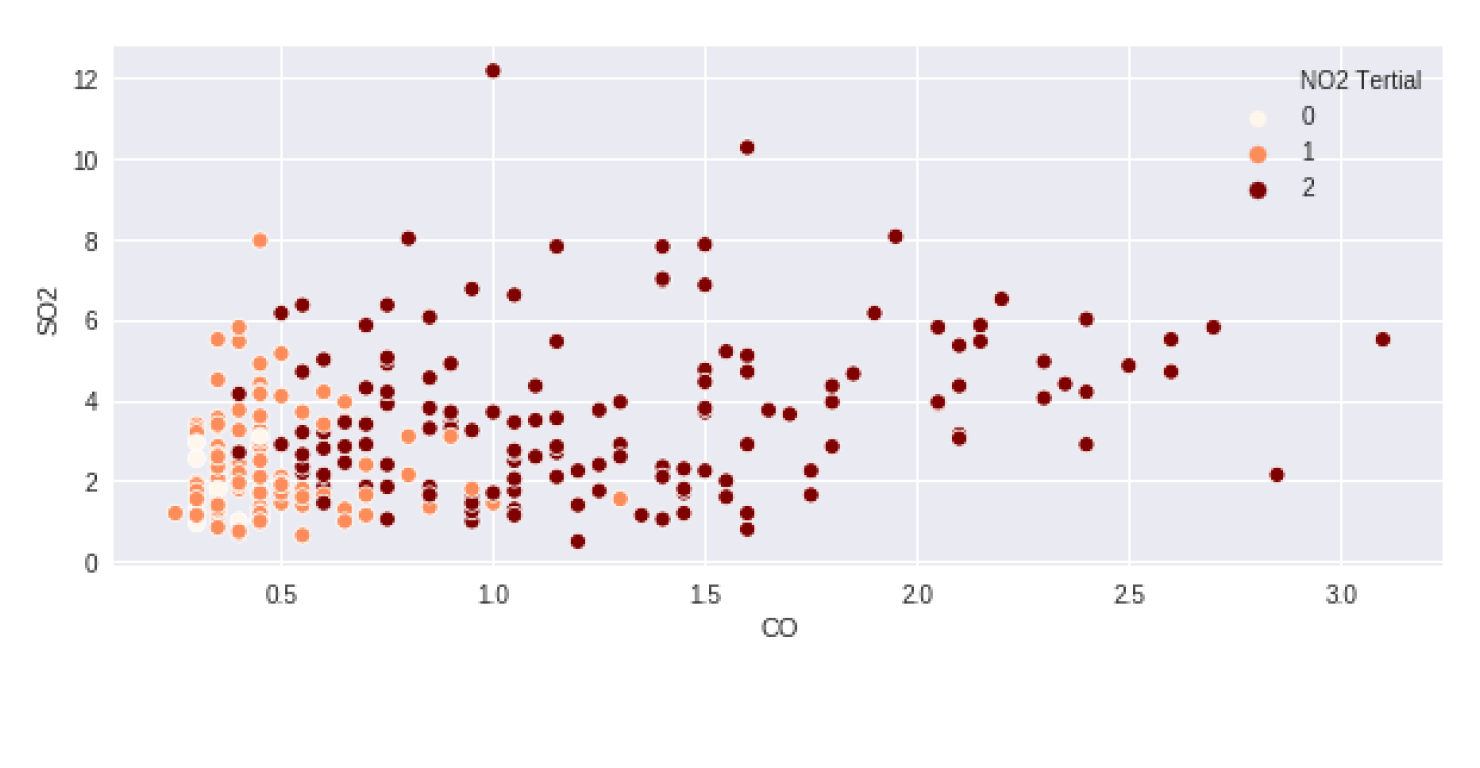
# Créer une colonne de tertiles avec qcut()
pollution['NO2 Tertial'] = pd.qcut(pollution['NO2'], 3, labels = False)

# Tracer en colorant selon les tertiles calculés
sns.scatterplot(x="CO", y="SO2", hue='NO2 Tertial', palette="OrRd",
                data=pollution.query("city == 'Long Beach' & year == 2014"))