Centrer et mettre à l’échelle les variables

Customer Segmentation in Python

Karolis Urbonas

Head of Data Science, Amazon

Identifier un problème

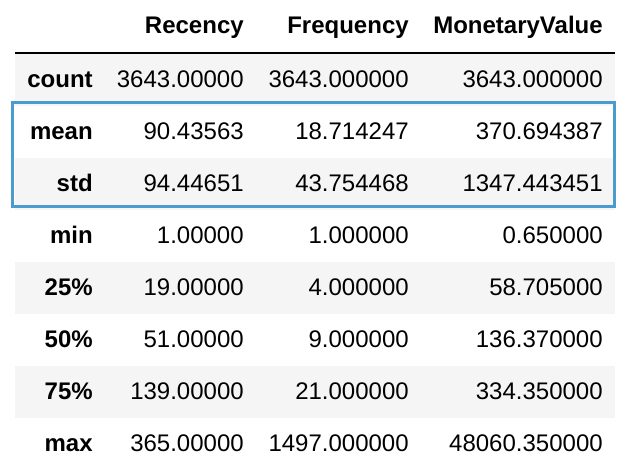
  • Analyser les statistiques clés du jeu de données
  • Comparer moyenne et écart type
datamart_rfm.describe()

Customer Segmentation in Python

Centrer des variables de moyennes différentes

  • K-means fonctionne bien avec des variables de même moyenne
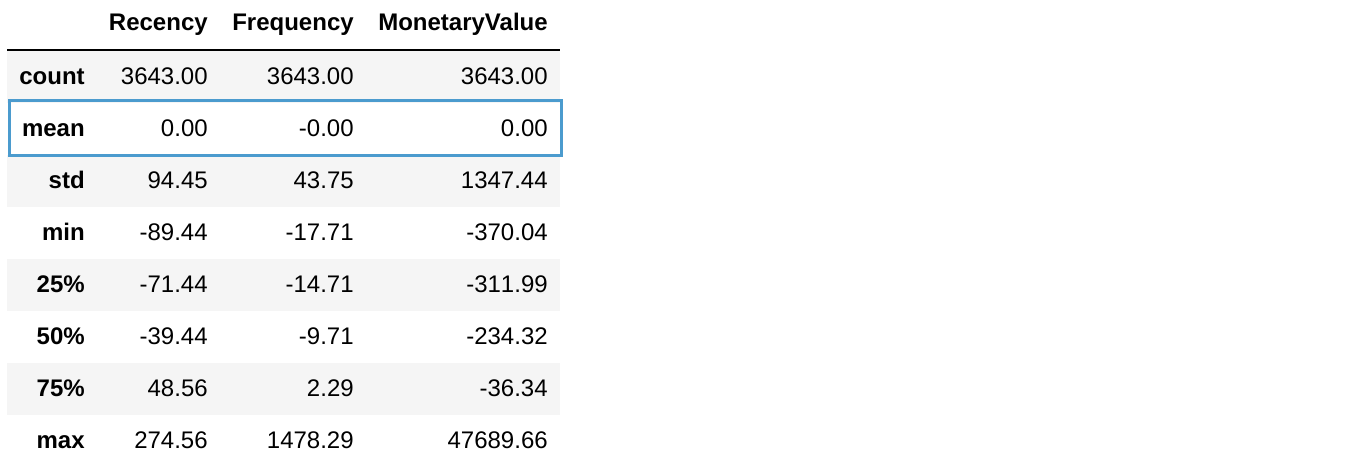
  • Centrer consiste à soustraire la moyenne à chaque observation
datamart_centered = datamart_rfm - datamart_rfm.mean()
datamart_centered.describe().round(2)
Customer Segmentation in Python

Mettre à l’échelle des variables de variance différente

  • K-means est meilleur avec des variables de même variance/écart type
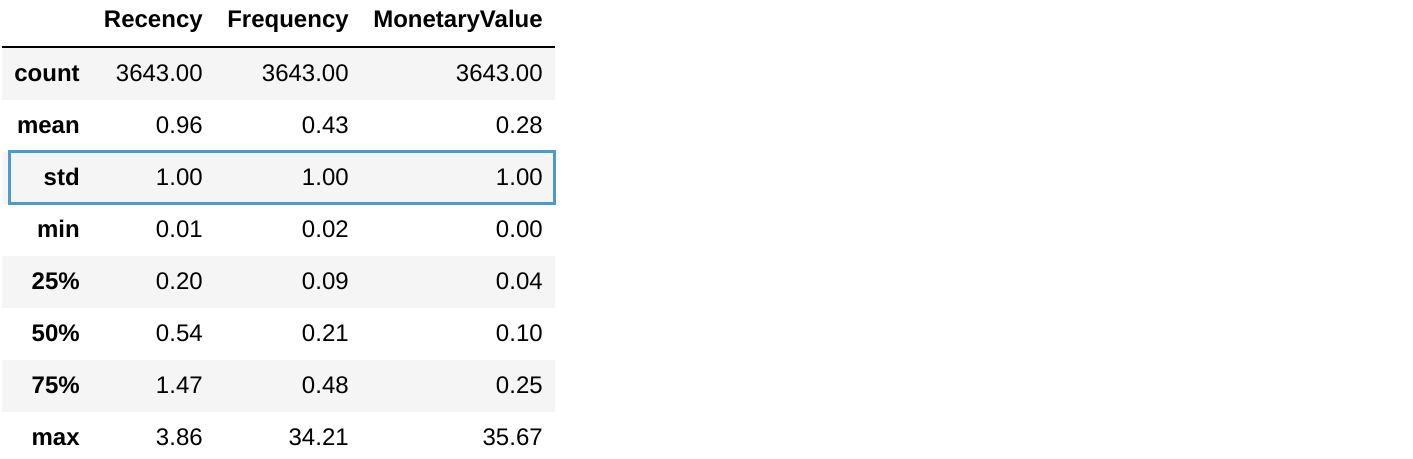
  • Mettre à l’échelle consiste à diviser par l’écart type de chaque variable
datamart_scaled = datamart_rfm / datamart_rfm.std()
datamart_scaled.describe().round(2)
Customer Segmentation in Python

Combiner centrage et mise à l’échelle

  • Soustraire la moyenne et diviser par l’écart type manuellement
  • Ou utiliser un scaler de la bibliothèque scikit-learn (retourne un objet numpy.ndarray)
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
scaler.fit(datamart_rfm)
datamart_normalized = scaler.transform(datamart_rfm)

print('mean: ', datamart_normalized.mean(axis=0).round(2)) print('std: ', datamart_normalized.std(axis=0).round(2))
mean:  [-0. -0.  0.]
std:  [1. 1. 1.]
Customer Segmentation in Python

Testez différentes approches par vous-même !

Customer Segmentation in Python

Preparing Video For Download...