Prétraitement des données

Customer Segmentation in Python

Karolis Urbonas

Head of Data Science, Amazon

Avantages du regroupement k-means

  • L’une des méthodes d’apprentissage non supervisé les plus populaires
  • Simple et rapide
  • Efficace*

* sous certaines hypothèses sur les données

Customer Segmentation in Python

Hypothèses clés de k-means

  • Distribution symétrique des variables (non asymétriques)
  • Variables avec la même moyenne
  • Variables avec la même variance
Customer Segmentation in Python

Variables asymétriques


  • Asymétrie à gauche


  • Asymétrie à droite

Customer Segmentation in Python

Variables asymétriques

  • Asymétrie corrigée par transformation logarithmique

Customer Segmentation in Python

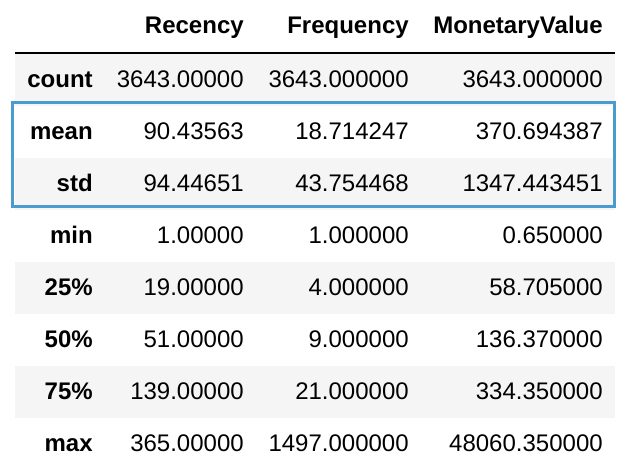
Variables sur la même échelle

  • K-means suppose une moyenne égale
  • Et une variance égale
  • Ce n’est pas le cas avec les données RFM
datamart_rfm.describe()

Customer Segmentation in Python

Révisons les notions

Customer Segmentation in Python

Preparing Video For Download...