Analyse de clustering : choisir le bon algorithme de clustering
S’entraîner aux questions d’entretien en Machine Learning avec Python

Lisa Stuart
Data Scientist
Mesures de distance : distance de Manhattan (taxi)
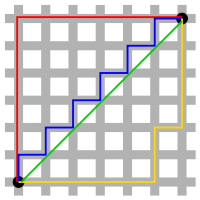
1 https://en.wikipedia.org/wiki/Taxicab_geometry
Mesures de distance : distance euclidienne

1 http://rosalind.info/glossary/euclidean-distance/
K-means
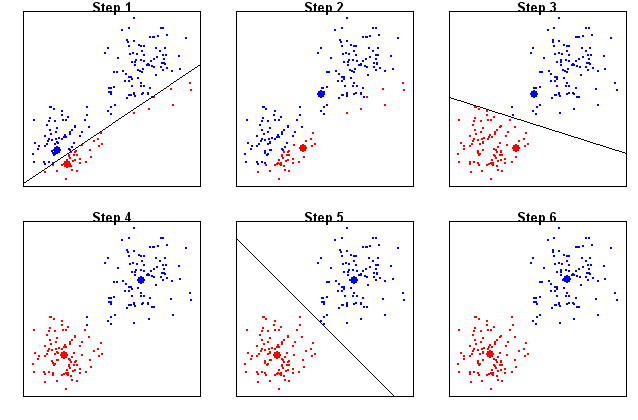
1 http://sherrytowers.com/2013/10/24/k-means-clustering/
Clustering hiérarchique agglomératif
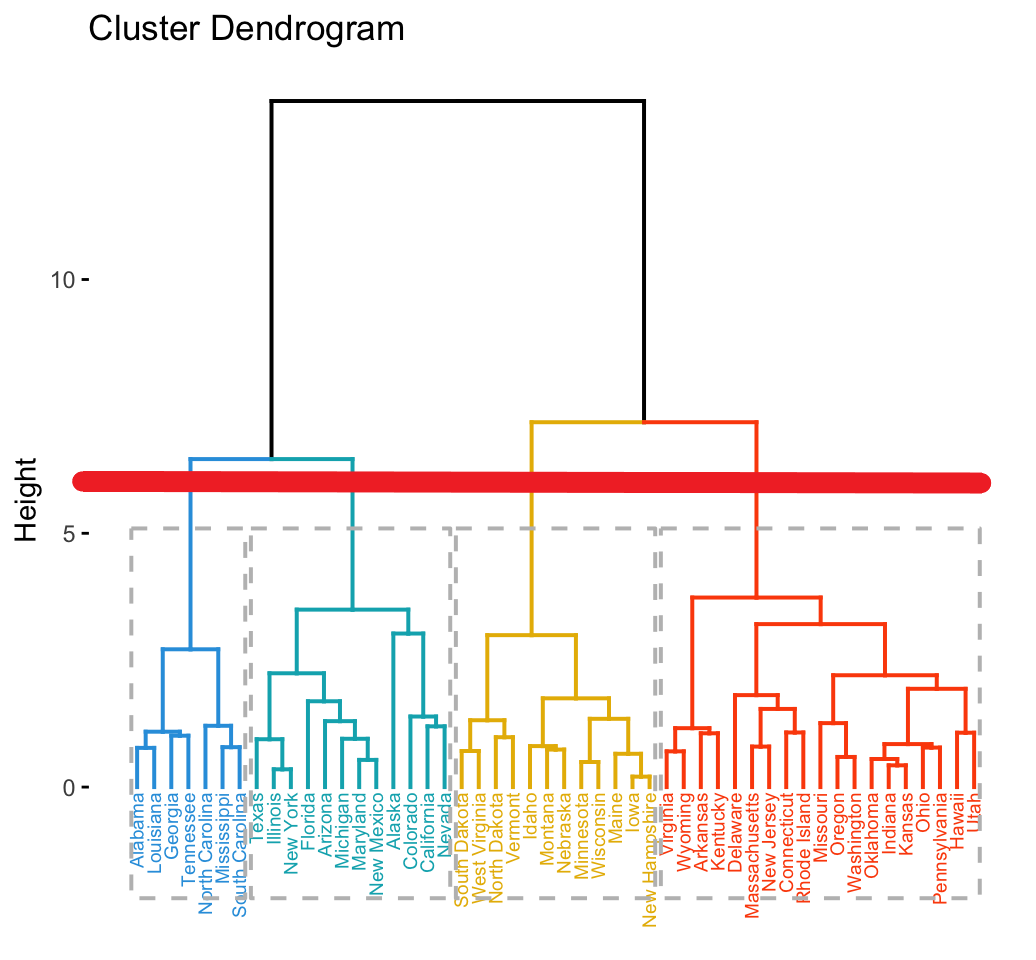
1 https://www.datanovia.com/en/lessons/agglomerative-hierarchical-clustering/
Choisir un algorithme de clustering
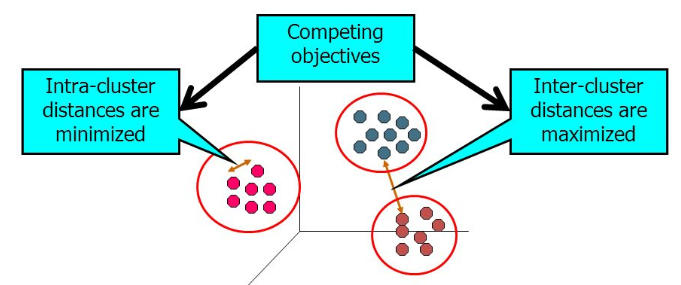
1 https://slideplayer.com/slide/8363774/

