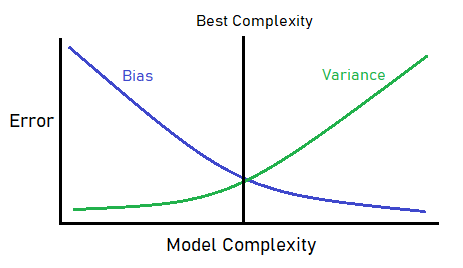
Compromis biais-variance

Machine Learning avec des modèles à base d’arbres en R

Sandro Raabe

Data Scientist

Hyperparamètres
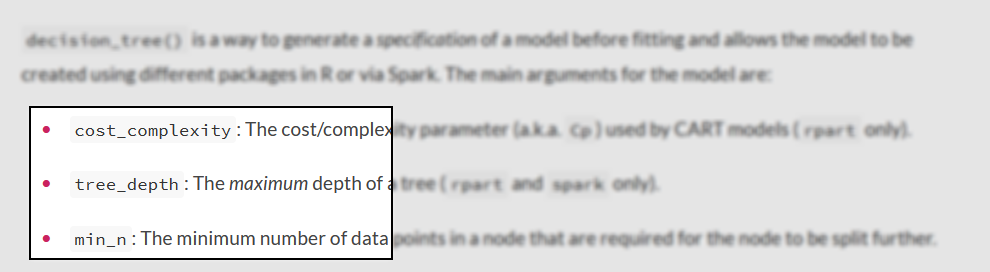
  • Choisis par la personne qui modélise
  • p. ex. tree_depth
  • Consultez la documentation !
?decision_tree

plusieurs hyperparamètres

Machine Learning avec des modèles à base d’arbres en R

Modèle simple

simple_spec <- decision_tree(tree_depth = 2) %>% 
    set_mode("regression")

simple_spec %>% fit(final_grade ~ .,
                    data = training_data)

Modèle complexe

complex_spec <- decision_tree(tree_depth = 15) %>% 
    set_mode("regression")

complex_spec %>% fit(final_grade ~ .,
                     data = training_data)

arbre de profondeur 2

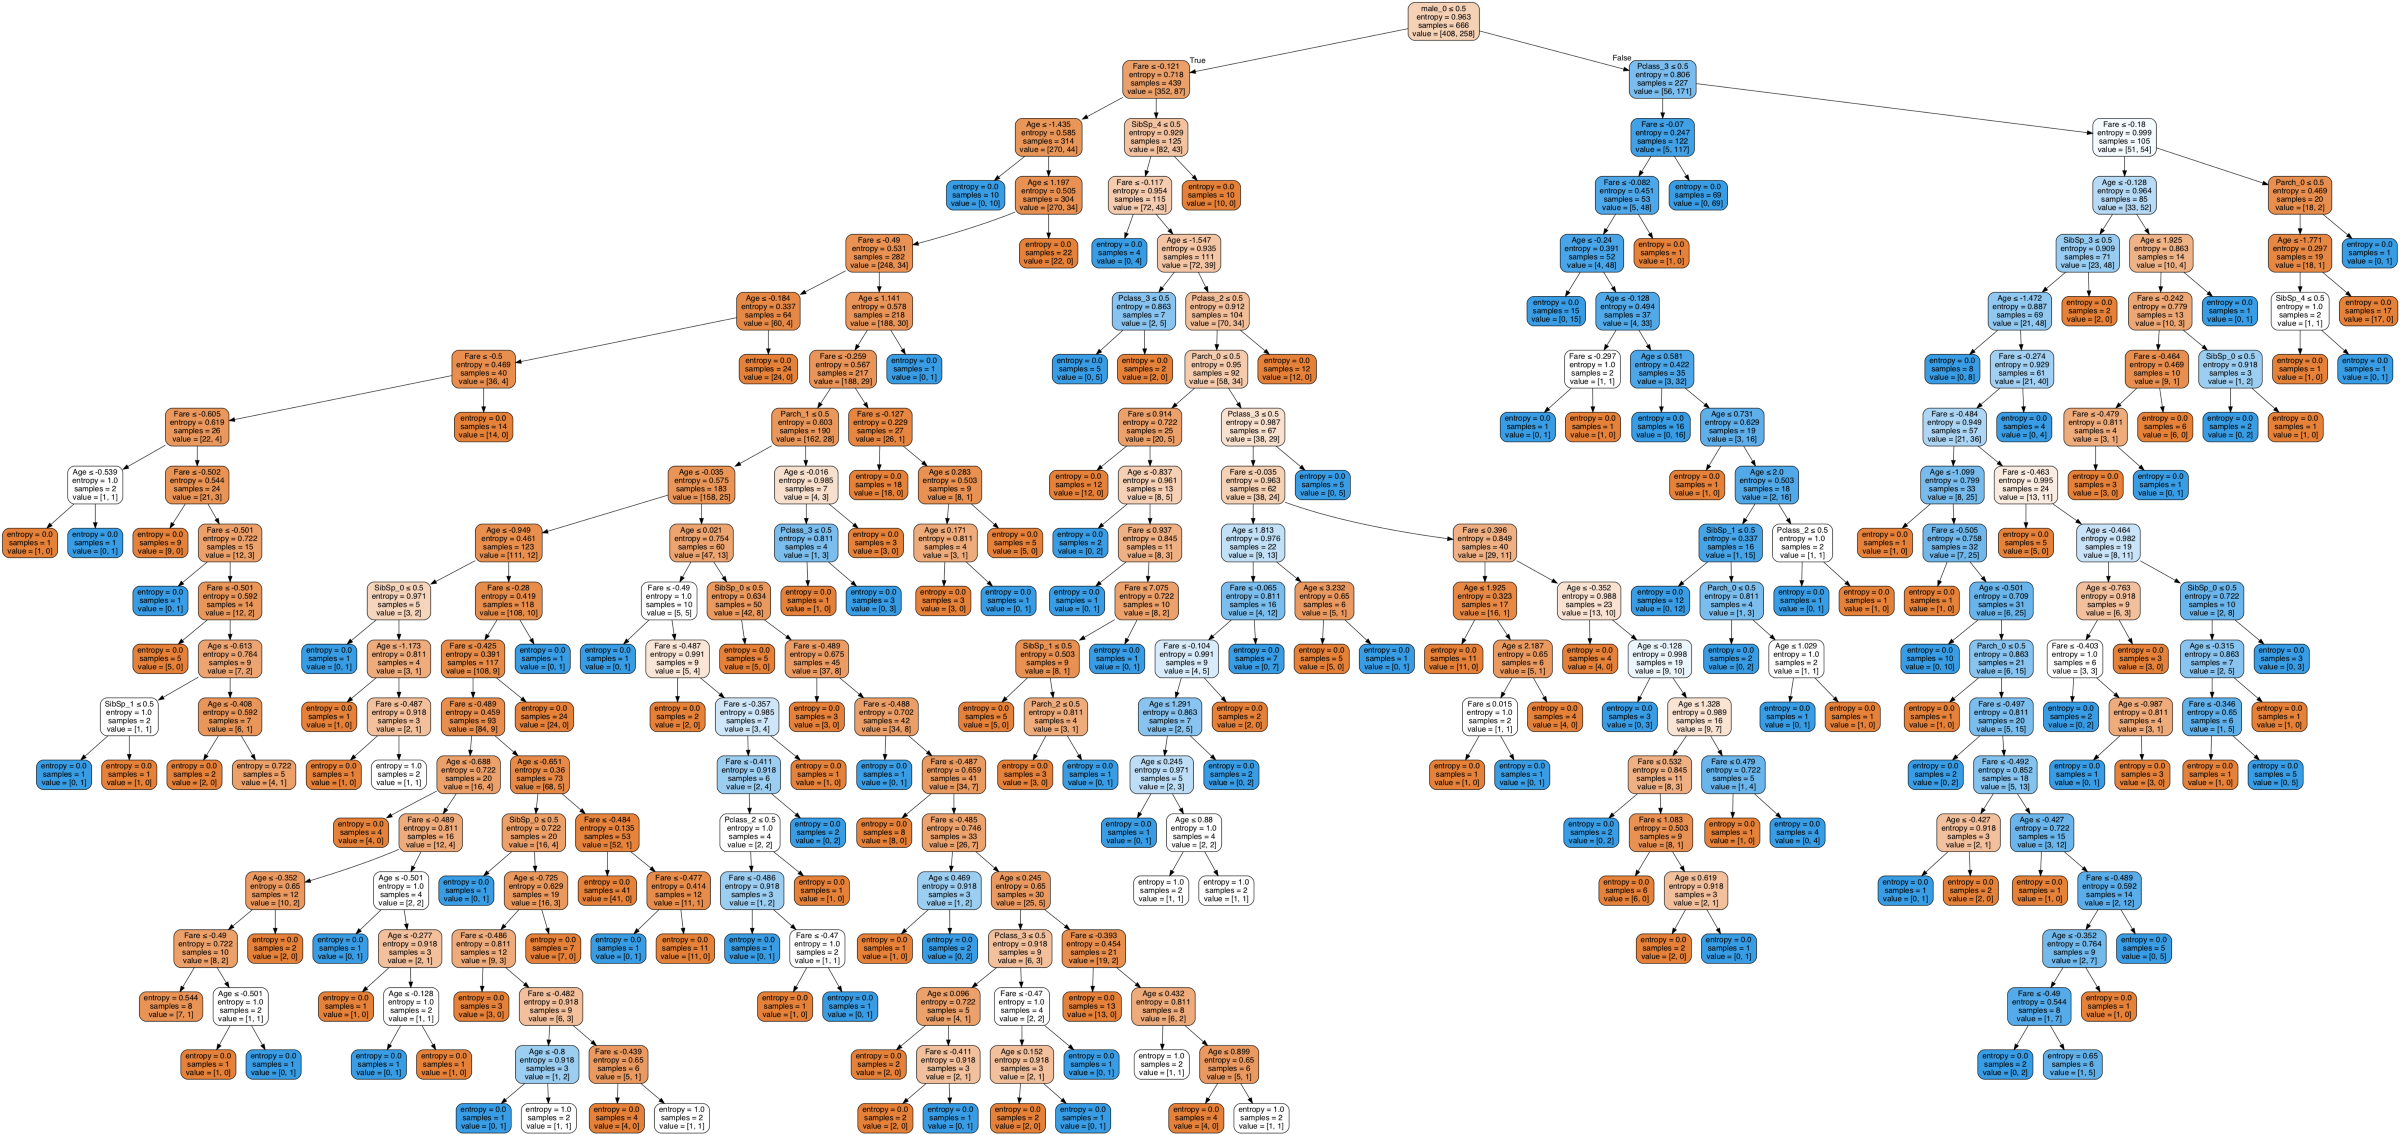
arbre de profondeur 30

Machine Learning avec des modèles à base d’arbres en R

Modèle complexe – surapprentissage – variance élevée

Prédictions sur l'entraînement : très bien !
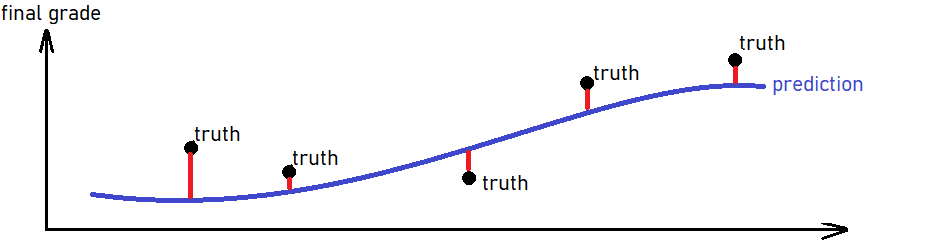
petites erreurs sur l'entraînement

mae(train_results, 
    estimate = .pred,
    truth = final_grade)
# A tibble: 1 x 3
  .metric  .estimate
1 mae          0.204

Prédictions sur le test : très éloignées !
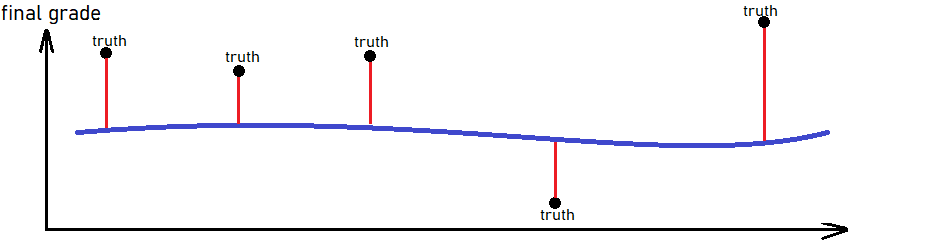
grosses erreurs sur le test

mae(test_results, 
    estimate = .pred,
    truth = final_grade)
# A tibble: 1 x 3
  .metric  .estimate
1 mae          0.947
Machine Learning avec des modèles à base d’arbres en R

Modèle simple – sous-apprentissage – biais élevé

Grandes erreurs sur l'entraînement et le test :

bind_rows(training = mae(train_results, estimate = .pred, truth = final_grade),
          test     = mae(test_results,  estimate = .pred, truth = final_grade),
          .id = "dataset")
# A tibble: 2 x 4
  dataset    .metric  .estimate
  <chr>      <chr>        <dbl>
1 training   mae          0.754
2 test       mae          0.844
Machine Learning avec des modèles à base d’arbres en R

Le compromis biais-variance

compromis biais-variance


  • Modèles simples -> biais élevé
  • Modèles complexes -> variance élevée
  • Compromis entre biais et variance
  • Viser la zone optimale
Machine Learning avec des modèles à base d’arbres en R

Détecter le surapprentissage

Hors échantillon/CV :

collect_metrics(cv_fits)


# A tibble: 1 x 3
  .metric    mean     n 
1 mae       2.432     5
  • Erreur CV élevée
  • Surapprentissage / variance élevée
  • Réduire la complexité !

Dans l'échantillon :

mae(training_pred, 
    estimate = .pred, 
    truth = final_grade)
# A tibble: 1 x 2
  .metric  .estimate
1 mae          0.228
  • Faible erreur d'entraînement
Machine Learning avec des modèles à base d’arbres en R

Détecter le sous-apprentissage

Dans l'échantillon :

mae(training_pred, estimate = .pred, truth = final_grade)
# A tibble: 1 x 2
  .metric .estimate
  <chr>       <dbl>
1 mae         2.432
  • Grande erreur dans/d'entraînement
  • Sous-apprentissage / biais élevé
  • Augmenter la complexité !
Machine Learning avec des modèles à base d’arbres en R

Faisons le compromis !

Machine Learning avec des modèles à base d’arbres en R

Preparing Video For Download...