Préparer les données pour prédire les achats

Machine Learning pour le marketing en Python

Karolis Urbonas

Head of Analytics & Science, Amazon

Régression : prédire une variable continue

  • Régression : type d'apprentissage supervisé
  • Variable cible : continue ou de comptage
  • Version la plus simple : régression linéaire
  • Les données de comptage (ex. nombre de jours actifs) sont parfois mieux prédites par une régression de Poisson ou binomiale négative
Machine Learning pour le marketing en Python

Caractéristiques Récence, Fréquence, Monétaire (RFM)

  • RFM : approche à la base de nombreux procédés de création de variables
  • Récence : temps écoulé depuis la dernière transaction
  • Fréquence : nombre d'achats sur la période observée
  • Valeur Monétaire : montant total dépensé sur la période observée
Machine Learning pour le marketing en Python

Explorer la répartition des ventes par mois

# Explorer la distribution mensuelle des observations
online.groupby(['InvoiceMonth']).size()
InvoiceMonth
2010-12    4893
2011-01    3580
2011-02    3648
2011-03    4764
2011-04    4148
2011-05    5018
2011-06    4669
2011-07    4610
2011-08    4744
2011-09    7189
2011-10    8808
2011-11    9513
dtype: int64
Machine Learning pour le marketing en Python

Séparer les données de caractéristiques

# Exclure la variable cible
online_X = online[online['InvoiceMonth']!='2011-11']

# Définir la date de référence NOW = dt.datetime(2011,11,1)
# Construire les caractéristiques features = online_X.groupby('CustomerID').agg({ 'InvoiceDate': lambda x: (NOW - x.max()).days, 'InvoiceNo': pd.Series.nunique, 'TotalSum': np.sum, 'Quantity': ['mean', 'sum'] }).reset_index()
features.columns = ['CustomerID', 'recency', 'frequency', 'monetary', 'quantity_avg', 'quantity_total']
Machine Learning pour le marketing en Python

Vérifier les caractéristiques

print(features.head())
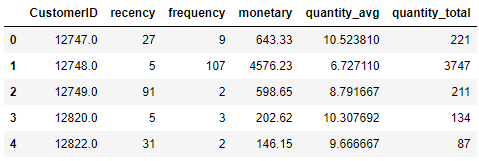
En-tête des caractéristiques

Machine Learning pour le marketing en Python

Calculer la variable cible

# Tableau croisé des transactions mensuelles par client
cust_month_tx = pd.pivot_table(data=online, index=['CustomerID'], 
                               values='InvoiceNo',
                               columns=['InvoiceMonth'],
                               aggfunc=pd.Series.nunique, fill_value=0)
print(cust_month_tx.head())
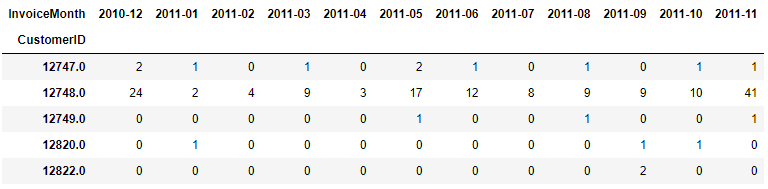
Tableau croisé mensuel par client

Machine Learning pour le marketing en Python

Finaliser la préparation et séparer en train/test

# Enregistrer les noms des colonnes identifiant et cible
custid = ['CustomerID']
target = ['2011-11']

# Extraire la variable cible Y = cust_month_tx[target]
# Extraire les noms des colonnes de caractéristiques cols = [col for col in features.columns if col not in custid]
# Conserver les caractéristiques X = features[cols]
Machine Learning pour le marketing en Python

Séparer les données en entraînement et test

# Séparer aléatoirement 25 % des données pour le test
from sklearn.model_selection import train_test_split
train_X, test_X, train_Y, test_Y = train_test_split(X, Y, 
                                                    test_size=0.25, 
                                                    random_state=99)

# Afficher les dimensions des jeux de données print(train_X.shape, train_Y.shape, test_X.shape, test_Y.shape)
(2529, 5) (2529, 1) (843, 5) (843, 1)
Machine Learning pour le marketing en Python

Passons à la pratique !

Machine Learning pour le marketing en Python

Preparing Video For Download...