Contrôles de qualité des données et statistiques descriptives

Surveiller le Machine Learning en Python

Hakim Elakhrass

Co-founder and CEO of NannyML

Qu'appelle-t-on contrôles de qualité des données et statistiques descriptives ?
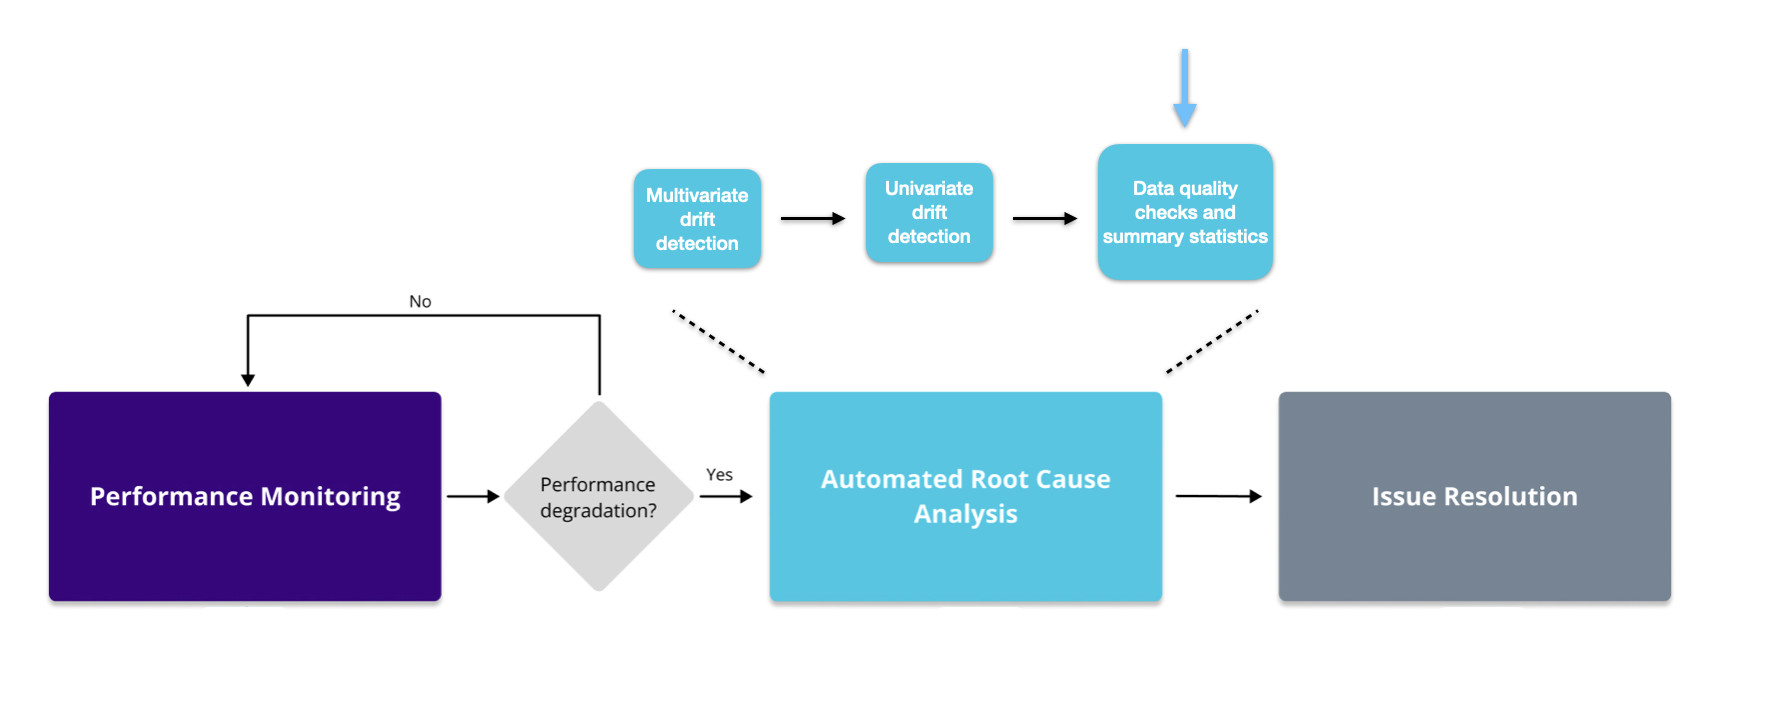
L'image montre le flux de supervision avec la partie contrôles de qualité des données et statistiques descriptives mise en évidence dans l'étape d'analyse automatisée des causes.

  • Détection des valeurs manquantes
  • Détection des valeurs inédites
  • Somme, moyenne, écart-type, médiane et nombre de lignes
Surveiller le Machine Learning en Python

Détection des valeurs manquantes

  • Moins d'observations dans un bloc
  • Perte d'informations utiles
  • Interprétations et décisions erronées
# Instantiate the missing values calculator module
ms_calc = nannyml.MissingValuesCalculator(column_names=["Age"], normalize=True)

# Fit the calculator on the reference set
ms_calc.fit(reference)

# Calculate the rate of the missing values on the analysis set
ms_results = ms_calc.calculate(analysis)
ms_results.plot()
Surveiller le Machine Learning en Python

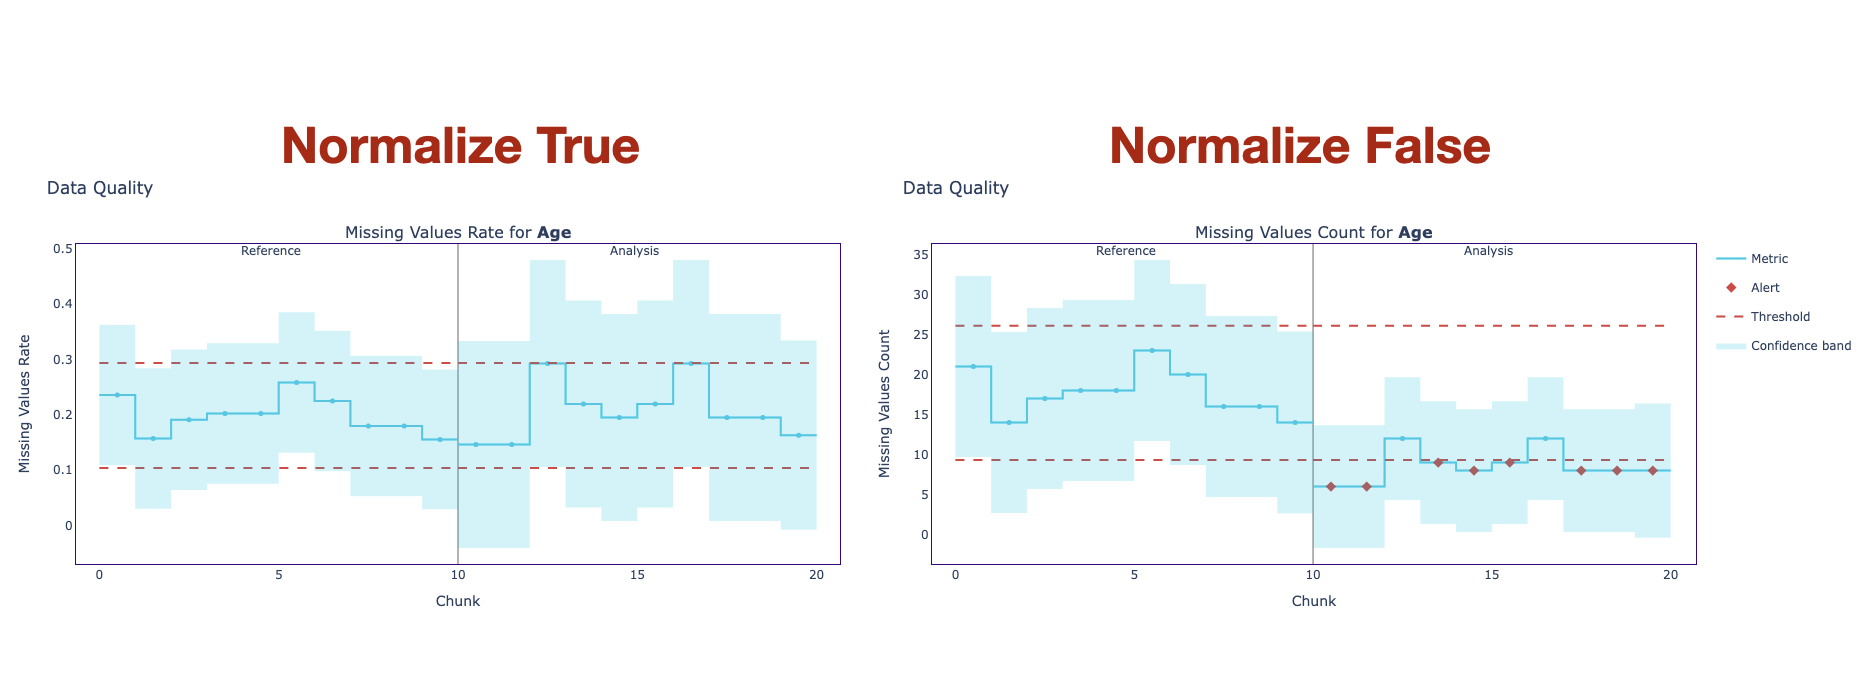
Graphique des valeurs manquantes

Le graphique montre les résultats des valeurs manquantes pour le paramètre normalize réglé sur True et False.

Surveiller le Machine Learning en Python

Détection des valeurs inédites

  • Valeurs catégorielles absentes sur la période de référence
  • Plus de valeurs inédites peut réduire la confiance du modèle dans certaines zones
# Instantiate the unseen values calculator module
us_calc = nannyml.UnseenValuesCalculator(column_names=["Cabin"], normalize=False)
# Fit, calculate and plot the rate of the unseen values
us_calc.fit(reference)
us_results = us_calc.calculate(analysis)
us_results.plot()
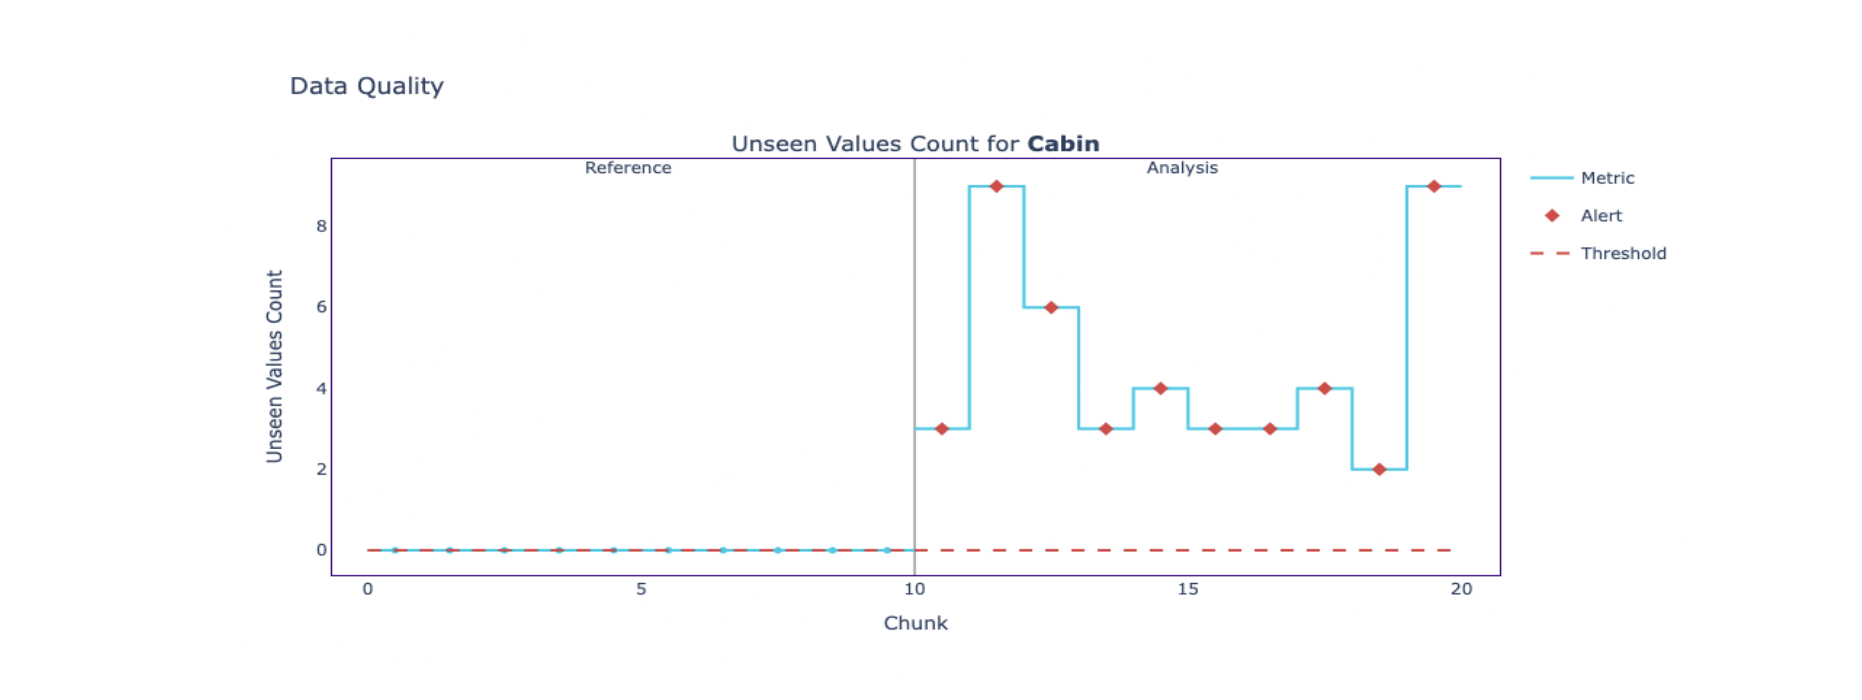
L'image montre un graphique des valeurs inédites avec des variations du nombre de valeurs inédites.

Surveiller le Machine Learning en Python

Statistiques descriptives

  • Somme : utile en finance pour calculer chiffre d'affaires ou profits sur une période.
  • Moyenne et écart-type : utiles pour le suivi du data drift et l'explicabilité.
  • Médiane : robuste aux valeurs aberrantes, pratique quand une variable en contient beaucoup.
  • Nombre de lignes : vérifie qu'il y a assez de données par bloc.
sum_calc = nannyml.SummaryStatsSumCalculator(column_names=selected_columns)
avg_calc = nannyml.SummaryStatsAvgCalculator(column_names=selected_columns)
std_calc = nannyml.SummaryStatsStdCalculator(column_names=selected_columns)
med_calc = nannyml.SummaryStatsMedianCalculator(column_names=selected_columns)
rows_calc = nannyml.SummaryStatsRowCountCalculator(column_names=selected_columns)
Surveiller le Machine Learning en Python

Passons à la pratique !

Surveiller le Machine Learning en Python

Preparing Video For Download...