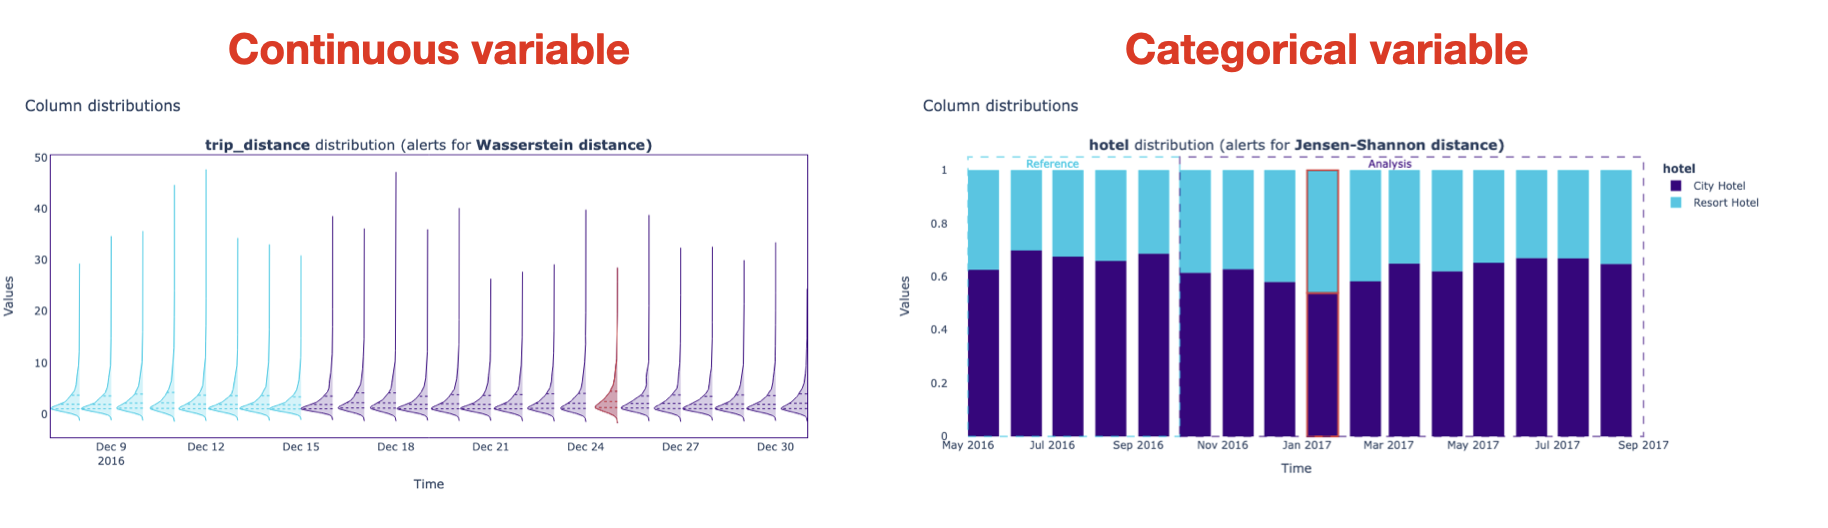
Détection de dérive univariée
Surveiller le Machine Learning en Python

Hakim Elakhrass
CEO and co-founder
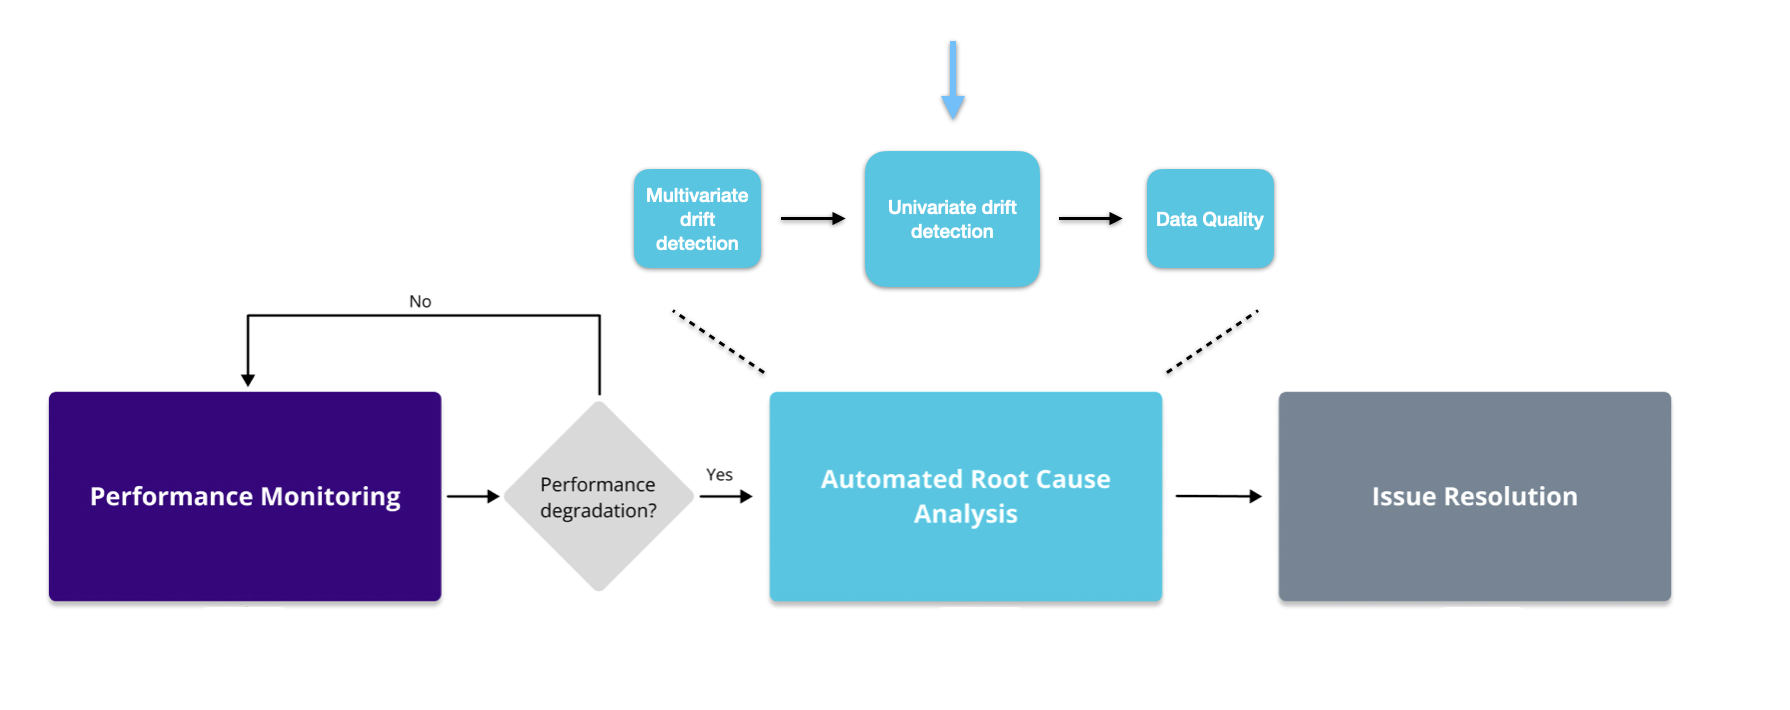
Qu'est-ce que la détection de dérive univariée ?
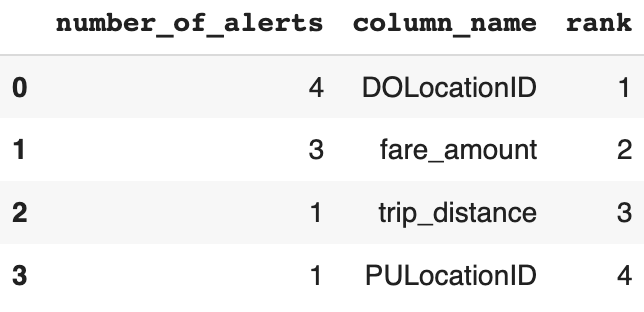
Classement par nombre d'alertes
# Initialiser le classificateur par nombre d'alertes
alert_count_ranker = nannyml.AlertCountRanker()
alert_count_ranked_results = alert_count_ranker.rank(
    uv_results,
    only_drifting=False)
# Afficher les résultats
display(alert_count_ranked_results)
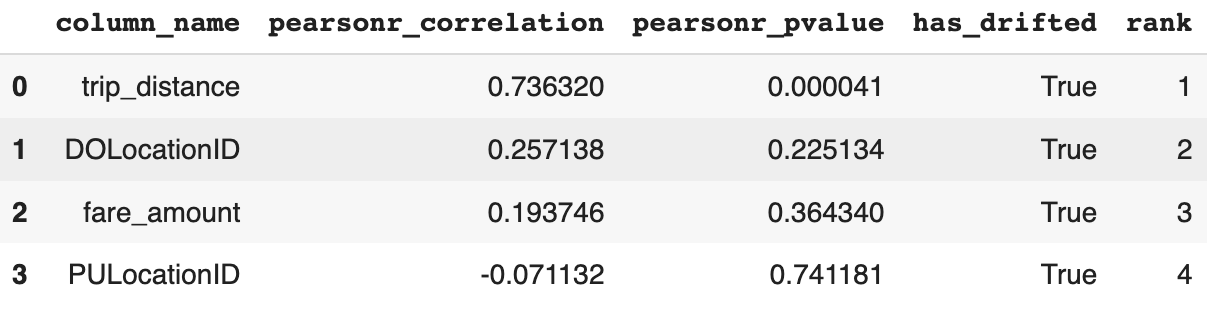
Classement par corrélation
# Initialiser le classificateur par corrélation
correlation_ranker = nannyml.CorrelationRanker()
correlation_ranker.fit(perf_results.filter(period='reference'))
correlation_ranked_results = correlation_ranker.rank(uv_results, perf_results)

# Afficher les résultats
display(correlation_ranked_results)
Graphique de distribution des variables