Préparation des données pour NannyML

Surveiller le Machine Learning en Python

Hakim Elakhrass

Co-founder and CEO of NannyML

Chargement des données
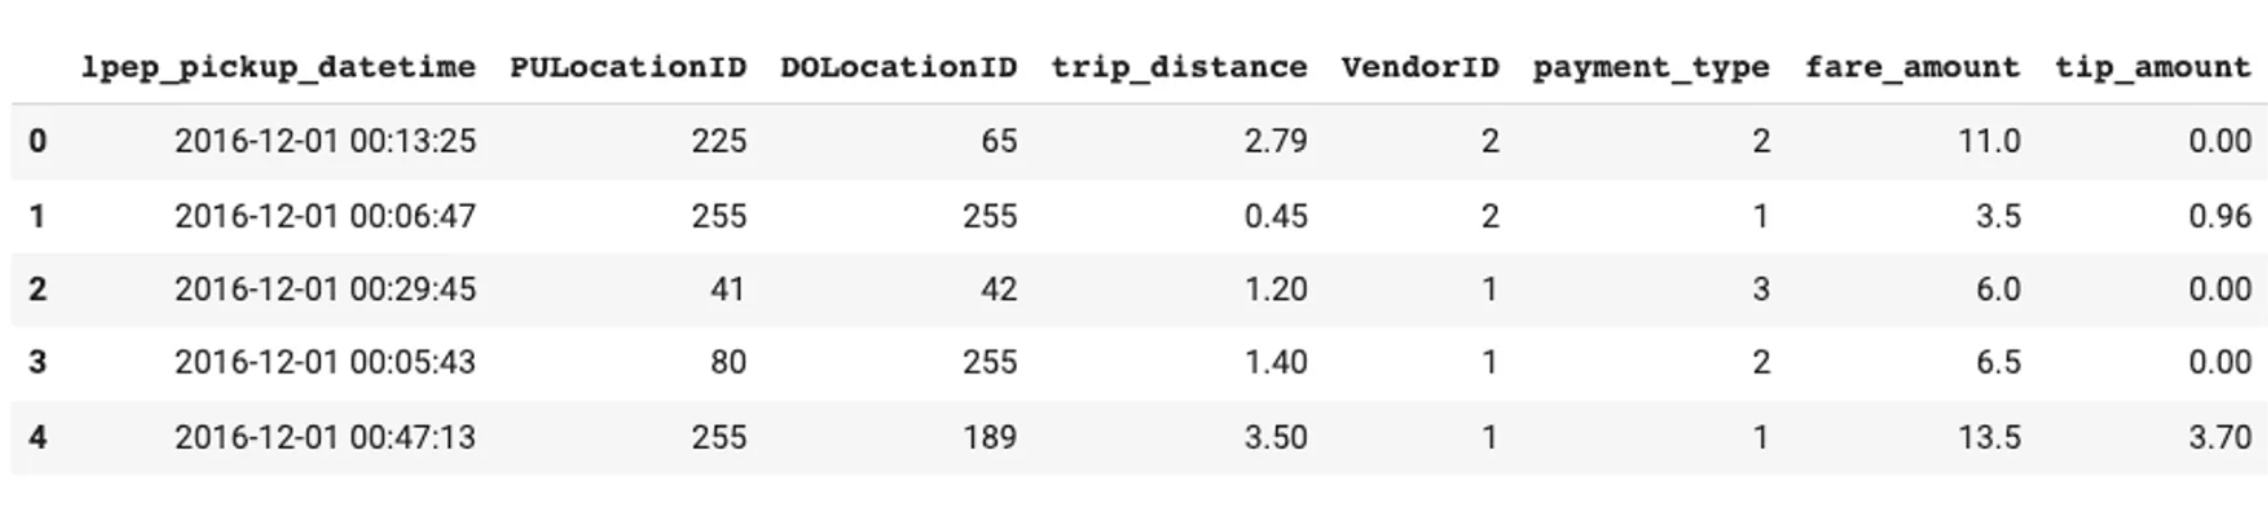
dataset_name = "green_taxi_dataset.csv"
data = pd.read_csv(dataset_name)
data.head()

L'image est une capture des cinq premières lignes du jeu de données.

Surveiller le Machine Learning en Python

Traitement des données

# Create data partition
data['partition'] = pd.cut(
    data['lpep_pickup_datetime'],
    bins= [pd.to_datetime('2016-12-01'),
           pd.to_datetime('2016-12-08'),
           pd.to_datetime('2016-12-16'),
           pd.to_datetime('2017-01-01')],
    right=False,
    labels= ['train', 'test', 'prod']
)
Surveiller le Machine Learning en Python

Découper les données

# Target column name
target = 'tip_amount'
# Features column name
features = ["PULocationID", "DOLocationID", "trip_distance", "VendorID", "pickup_time"]
# Train set
X_train = data.loc[data['partition'] == 'train', features]
y_train = data.loc[data['partition'] == 'train', target]

# Test set (later reference set)
X_test = data.loc[data['partition'] == 'test', features]
y_test = data.loc[data['partition'] == 'test', target]

# Production set (later analysis set)
X_prod = data.loc[data['partition'] == 'prod', features]
y_prod = data.loc[data['partition'] == 'prod', target]
Surveiller le Machine Learning en Python

Construction du modèle

  • Entraîner LGBMRegressor avec la bibliothèque lightgbm
  • Évaluer le modèle sur un jeu de test
  • Déployer le modèle
# Training the model
model = LGBMRegressor(random_state=42)
model.fit(X_train, y_train)

# Making predictions
y_pred_train = model.predict(X_train)
y_pred_test = model.predict(X_test)

# Evaluating the model on train and test set
mae_train = MAE(y_train, y_pred_train)
mae_test = MAE(y_test, y_pred_test)

# Deploying the model to production
y_pred_prod = model.predict(X_prod)
Surveiller le Machine Learning en Python

Créer les jeux de référence et d'analyse

Période de référence

  • Utilise un jeu de test

  • Nécessite la vérité terrain

  • Définit la performance de base

Période d'analyse

  • Données de production récentes

  • Vérité terrain facultative

  • NannyML analyse le drift des données et la performance

# Creating reference set
reference = X_test.copy() # Test set features
reference['y_pred'] = y_pred_test # Predictions
reference['tip_amount'] = y_test # Labels
reference = reference.join(
    data['lpep_pickup_datetime']) # Timestamp
# Creating analysis set
analysis = X_prod.copy() # Production features
analysis['y_pred'] = y_pred_prod # Predictions
analysis = analysis.join(
    data['lpep_pickup_datetime']) # Timestamp
Surveiller le Machine Learning en Python

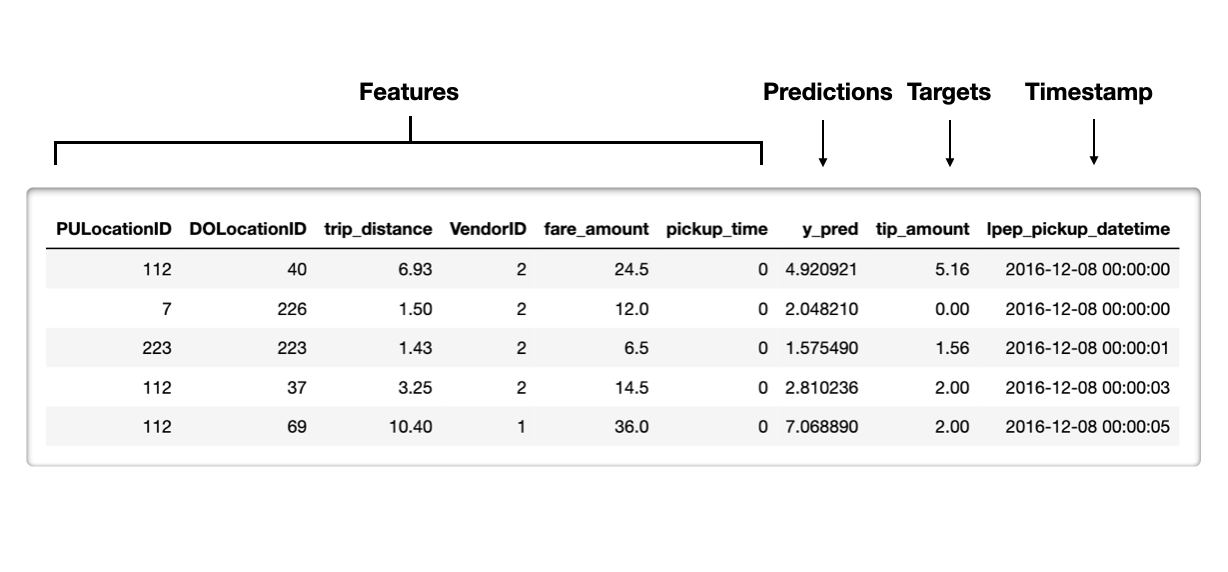
Exemple de jeu de référence

  • Horodatage — moment où l'observation a eu lieu (optionnel)
  • Caractéristiques — variables d'entrée du modèle
  • Sorties du modèle
    • Prédictions — score de prédiction produit par le modèle
    • Étiquettes de classe — probabilités seuillées
  • Cible — vérité terrain

L'image montre les cinq premières lignes du jeu de référence.

Surveiller le Machine Learning en Python

Passons à la pratique !

Surveiller le Machine Learning en Python

Preparing Video For Download...