Taille d'effet

Fondements de l’inférence en Python

Paul Savala

Assistant Professor of Mathematics

Qu'est-ce que la taille d'effet ?
Un médecin tenant une cigarette cassée.

  • Taille d'effet : mesure de la force entre deux variables
Un assortiment de malbouffe.

Fondements de l’inférence en Python

Pourquoi mesurer la taille d'effet

  • Mesure la force de la relation
  • Tabagisme : grande taille d'effet
  • Mauvaise alimentation : petite taille d'effet
Fondements de l’inférence en Python

Valeurs p


  • La relation existe-t‑elle ?
  • Issue d'un test d'hypothèse

Taille d'effet


  • Quelle est la force de la relation ?
  • Indépendante d'un test d'hypothèse
Fondements de l’inférence en Python

Taille d'effet pour des moyennes – d de Cohen

$n_1 = \text{Taille de l'échantillon du groupe 1}$

$n_2 = \text{Taille de l'échantillon du groupe 2}$

$s_1 = \text{Écart-type du groupe 1}$

$s_2 = \text{Écart-type du groupe 2}$

$\overline{x}_1 = \text{Moyenne du groupe 1}$

$\overline{x}_2 = \text{Moyenne du groupe 2}$

$s = \displaystyle\sqrt{\frac{(n_1-1)s_1^2 + (n_2-1)s_2^2}{n_1 + n_2 - 2}}$

$d$ de Cohen $= \displaystyle\frac{\overline{x}_1 - \overline{x}_2}{s}$

Fondements de l’inférence en Python

Interpréter le d de Cohen

  • 0,01 - Très faible
  • 0,20 - Faible
  • 0,50 - Moyen
  • 0,80 - Grand
  • 1,20 - Très grand

$d$ de Cohen $= 0{,}6$

Taille d'effet moyenne à grande

1 https://books.google.com/books?id=2v9zDAsLvA0C&pg=PP1 https://doi.org/10.22237%2Fjmasm%2F1257035100
Fondements de l’inférence en Python

Taille d'effet pour la corrélation

r, p_value = stats.pearsonr(
    btc_sp_df['Close_BTC'], 
    btc_sp_df['Close_SP500']
    )

print(r**2)
0.82

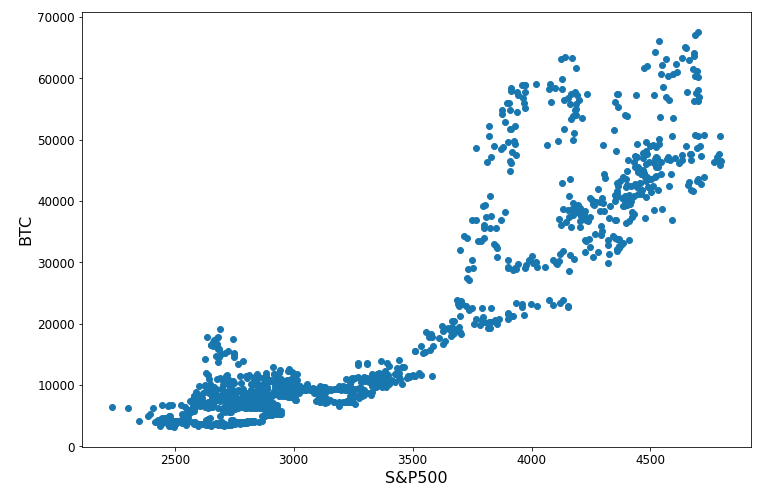
$R^2$ : pourcentage de la variation d'une variable expliqué par la connaissance de l'autre

Un nuage de points avec le cours de clôture du S&P 500 en abscisse et le cours de clôture du Bitcoin en ordonnée. La droite est approximativement linéaire et de pente positive.

Fondements de l’inférence en Python

Taille d'effet pour des variables catégorielles

  • $\chi^2$ = statistique du khi deux issue d'un tableau de contingence
  • $n$ = nombre total d'observations
  • $d$ = degrés de liberté = $min(\text{lignes}-1, \text{colonnes}-1)$

$V$ de Cramer $= \displaystyle\sqrt{\frac{\chi^2/n}{d}}$

Fondements de l’inférence en Python

Calculer le V de Cramer

chi2, p, d, e = stats.chi2_contingency(
    contingency_table)

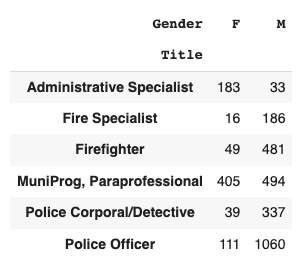
dof = min(6-1, 2-1) = 1 n = 3394
v = np.sqrt((chi2 / n) / dof)
v = 0.52

Un tableau indiquant hommes et femmes avec les intitulés de poste, et le nombre d'hommes et de femmes par poste.

1 https://en.wikipedia.org/wiki/Degrees_of_freedom_(statistics)
Fondements de l’inférence en Python

Interpréter le V de Cramer

V de Cramer = 0.52, Degrés de liberté = 1
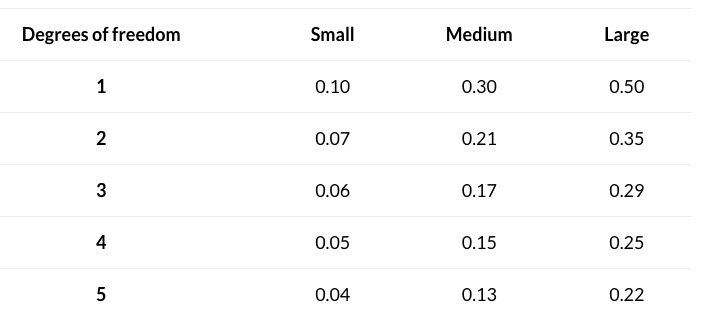
Un tableau indiquant les degrés de liberté de un à cinq, et les valeurs de V de Cramer requises pour une taille d'effet petite, moyenne et grande. Petite : 0,1 ; 0,07 ; 0,06 ; 0,05 ; 0,04. Moyenne : 0,3 ; 0,21 ; 0,17 ; 0,15 ; 0,13. Grande : 0,5 ; 0,35 ; 0,29 ; 0,25 ; 0,22.

1 https://www.statology.org/interpret-cramers-v
Fondements de l’inférence en Python

Passons à la pratique !

Fondements de l’inférence en Python

Preparing Video For Download...