Différents critères de fréquence

Text mining avec sac de mots en R

Ted Kwartler

Instructor

Pondération des termes
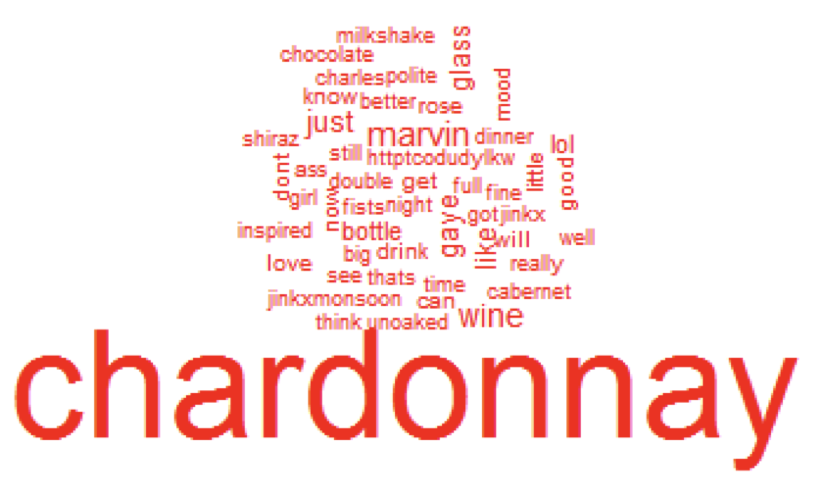
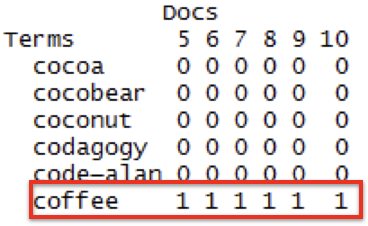
  • Fréquence par défaut = simple comptage des mots
  • Des mots fréquents peuvent masquer des insights
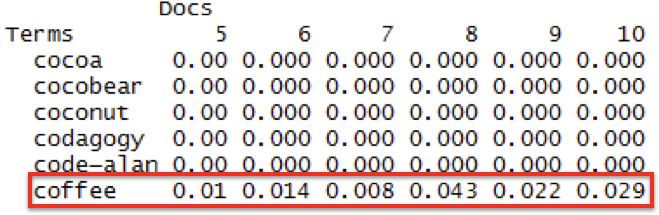
  • Ajuster la pondération avec TfIdf
  • Les mots présents dans de nombreux documents sont pénalisés

nuage de mots

Text mining avec sac de mots en R

Pondération des termes

# Standard term weighting
tf_tdm <- TermDocumentMatrix(text_corp)
tf_tdm_m <- as.matrix(tf_dtm)
tf_tdm_m[505:510, 5:10]
tdf.png

# TfIdf weighting
tf_idf_tdm <- TermDocumentMatrix(text_corp, 
    control = list(weighting = weightTfIdf))
tf_idf_tdm_m <- as.matrix(tf_idf_dtm)
tf_tdm_m <- as.matrix(tf_dtm)
tfidf.png

Text mining avec sac de mots en R

Conserver les métadonnées des documents

# Ensure the first 2 columns are doc_id & text
names(tweets)[1:2] <- c('doc_id','text')

# Create VCorpus including metadata
test_corpus <- VCorpus(DataframeSource(tweets))
# Clean and view results
text_corpus <- clean_corpus(text_corpus)
content(text_corpus[[1]])
$content
[1] "ayyytylerb true drink lots coffee"
meta(text_corpus[[1]])
$meta
  id      : 1
  author  : thejennagibson
  date    : 8/9/2013 2:43
  language: en
Text mining avec sac de mots en R

Passons à la pratique !

Text mining avec sac de mots en R

Preparing Video For Download...