Pourquoi transformer des variables existantes ?

Feature engineering en R

Jorge Zazueta

Research Professor. Head of the Modeling Group at the School of Economics, UASLP

Faciliter la vie de votre modèle

On peut améliorer les performances du modèle de Machine Learning en rendant les données plus faciles à traiter.

glimpse(loans_num)
Rows: 614
Columns: 6
$ Loan_Status       <fct> Y, N, Y, Y, Y, Y, Y, N, Y, N, Y, Y, Y, N...
$ ApplicantIncome   <dbl> 5849, 4583, 3000, 2583, 6000, 5417, 233...
$ CoapplicantIncome <dbl> 0, 1508, 0, 2358, 0, 4196, 1516, 2504, 1...
$ LoanAmount        <dbl> NA, 128, 66, 120, 141, 267, 95, 158, 168...
$ Loan_Amount_Term  <dbl> 360, 360, 360, 360, 360, 360, 360, 360, ...
$ Credit_History    <fct> 1, 1, 1, 1, 1, 1, 1, 0, 1, 1, 1, 1, 1, 1...
Feature engineering en R

Transformation logarithmique

Appliquez une transformation log aux variables numériques pour :

  • Gérer l'asymétrie des données
  • Réduire l'effet des valeurs aberrantes
  • Convertir des relations multiplicatives en additives
  • Rendre les données plus adaptées au modélisation
  • Ne fonctionne que pour des valeurs positives

Montants de prêt après transformation log
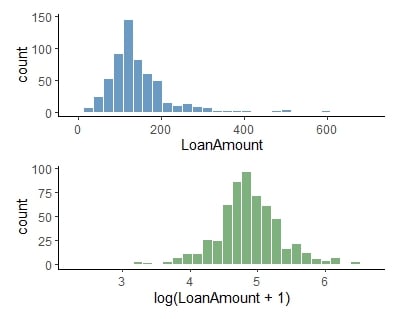
Comparaison graphique des données brutes et transformées par log

Feature engineering en R

Normalisation

Normalisez ou redimensionnez les variables numériques pour :

  • Empêcher une variable de dominer les autres
  • Faciliter l'interprétation grâce à des ordres de grandeur comparables
  • Rendre les données plus adaptées au modélisation

Par exemple, les durées de prêt varient fortement
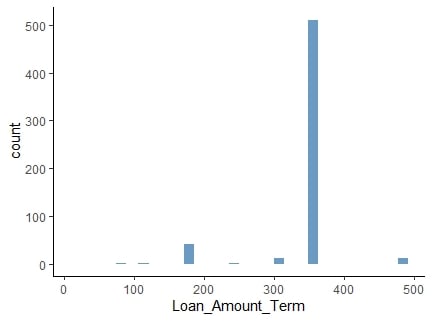
Histogramme des valeurs de durée de prêt.

Feature engineering en R

Normalisation

Normalisez ou redimensionnez les variables numériques pour :

  • Empêcher une variable de dominer les autres
  • Mieux gérer les valeurs aberrantes et
  • Les données manquantes
  • Rendre les données plus adaptées au modélisation

Les valeurs normalisées préservent la distribution tout en gardant de la variation.
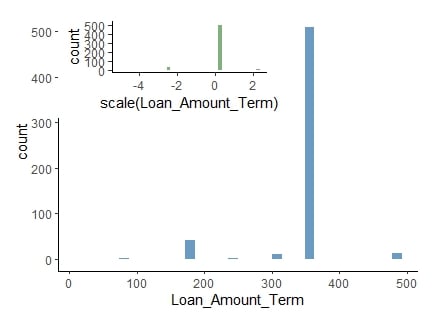
Histogramme des montants de prêt superposés aux données normalisées.

Feature engineering en R

Définir le modèle et la recette

Nous pouvons maintenant déclarer un modèle de régression logistique et ajouter une recette pour imputer, normaliser et appliquer le log aux variables concernées.

lr_model <- logistic_reg()

lr_recipe <- 
  recipe(Loan_Status ~., 
         data = train) %>%
  step_impute_knn(
    all_numeric_predictors())%>%
  step_normalize(Loan_Amount_Term) %>%
  step_log(all_numeric_predictors(),
           -Loan_Amount_Term, offset = 1)

Afficher l'objet recipe fournit un résumé des étapes appliquées.

lr_recipe
Recipe

Inputs:

      role #variables
   outcome          1
 predictor          5

Operations:

K-nearest neighbor imputation for all_numeric_predictors()
Centering and scaling for Loan_Amount_Term
Log transformation on all_numeric_predictors(),-Loan_Amount_Term
Feature engineering en R

Mesurer la performance efficacement

Nous définissons un ensemble de métriques, roc_auc, accuracy et sens, pour évaluer l'objet workflow ajusté lr_fit.

class_evaluate <- metric_set(
  roc_auc, accuracy, sens)

Puis nous l'exécutons comme toute fonction.

lr_aug %>% 
  class_evaluate(
    truth = Loan_Status, 
    estimate = .pred_class, 
    .pred_Y)

Ensemble de métriques personnalisé

# A tibble: 3 × 3
  .metric  .estimator .estimate
  <chr>    <chr>          <dbl>
1 accuracy binary         0.813
2 sens     binary         0.467
3 roc_auc  binary         0.288
Feature engineering en R

Passons à la pratique !

Feature engineering en R

Preparing Video For Download...