Feature engineering en R
Jorge Zazueta
Research Professor and Head of the Modeling Group at the School of Economics, UASLP
Supprimer les variables non pertinentes ou peu informatives offre plusieurs avantages, dont
Ajuster un modèle avec toutes les variables
lr_recipe_full <-
recipe(Loan_Status ~., data = train) %>%
update_role(Loan_ID, new_role = "ID")
lr_workflow_full <-
workflow() %>%
add_model(lr_model) %>%
add_recipe(lr_recipe_full)
lr_fit_full <-
lr_workflow_full %>%
fit(data = train)
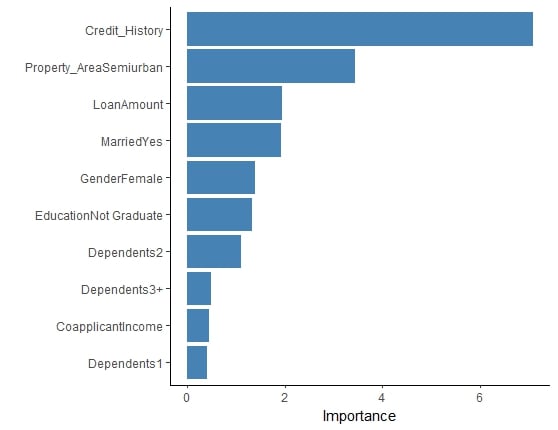
Tracer l'importance des variables avec vip
lr_fit_full %>%
extract_fit_parsnip() %>%
vip(aesthetics = list(fill = "steelblue"))
Importance des variables
Vous pouvez ajouter directement des variables avec la syntaxe de formule R de base.
# Create recipe
recipe_formula <-
recipe(Loan_Status ~ Credit_History + Property_Area +
LoanAmount, data = train)
# Bundle with model
workflow_formula <- # Bundle with model
workflow() %>% add_model(lr_model) %>%
add_recipe(recipe_formula)
Un vecteur de variables peut être utilisé pour sélectionner les variables avant l'entraînement.
# Feature vector
features <- c("Credit_History", "Property_Area", "LoanAmount", "Loan_Status")
# Training and testing data
train_features <- train %>% select(all_of(features))
test_features <- test %>% select(all_of(features))
# Create recipe and bundle with model
recipe_features <- recipe(Loan_Status ~., data = train_features)
workflow_features <- workflow() %>% add_model(lr_model) %>%
add_recipe(recipe_features)
Objets augmentés pour les deux approches
lr_aug_formula <-
workflow_formula %>%
fit(data = train) %>%
augment(new_data = test)
lr_aug_features <-
workflow_features %>%
fit(data = train_features) %>%
augment(new_data = test_features)
Les deux méthodes donnent les mêmes résultats
all_equal(lr_aug_features,
lr_aug_formula %>%
select(all_of(features),
starts_with(".pred")))
[1] TRUE
Utiliser toutes les variables
lr_fit_full <- # Fit workflow
lr_workflow_full %>%
fit(data = train)
lr_aug_full <- # Augment
lr_fit_full %>%
augment(test)
lr_aug_full %>% # Evaluate
class_evaluate(truth = Loan_Status,
estimate = .pred_class,
.pred_Y)
# A tibble: 2 × 3
.metric .estimator .estimate
<chr> <chr> <dbl>
1 accuracy binary 0.842
2 roc_auc binary 0.744
Utiliser les 3 meilleures variables*
lr_fit_formula <- # Fit workflow
workflow_formula %>%
fit(train)
lr_aug_formula <- # Augment
lr_fit_formula %>%
augment(new_data = test)
lr_aug_formula %>% # Evaluate
class_evaluate(truth = Loan_Status,
estimate = .pred_class,
.pred_Y)
# A tibble: 2 × 3
.metric .estimator .estimate
<chr> <chr> <dbl>
1 accuracy binary 0.842
2 roc_auc binary 0.733
Feature engineering en R